
AI 与工程数学 / 系统课时
看懂范数与距离度量
看懂范数与距离度量
优化算法需要回答几个非常具体的问题:当前点离目标多远、这一步走了多大、误差是否已经足够小。范数就是这些判断的统一语言。本节用常见向量范数和矩阵范数建立直觉,并说明不同范数为什么会改变“更近”“更小”和“更稀疏”的含义。
学习目标
- 能计算并区分 L1、L2 与 L∞ 范数,并把距离写成两个向量之差的范数。
- 能理解矩阵范数在衡量线性变换放大效应时的作用。
- 能根据步长、误差、约束半径和正则化目标选择合适的范数。
范数到底在度量什么
向量范数把一个向量映射为非负实数,可以理解为“大小”。对向量 ,常见定义是 、、。它们都满足非负性、齐次性和三角不等式,因此可以稳定地用来描述长度。
距离则是在范数基础上比较两个点:。因此“误差小于阈值”“步长小于阈值”本质上都是在选择一种范数后,对差向量做判断。换一种范数,同一对点的数值距离和几何形状都会改变。
三种向量范数如何改变几何
在二维平面里,把所有满足 的点画出来,可以直接看到不同范数的偏好。L2 的单位球是圆,L1 是菱形,L∞ 是与坐标轴平行的正方形。这个形状会进一步影响约束边界、投影结果以及正则化后更容易出现哪类解。
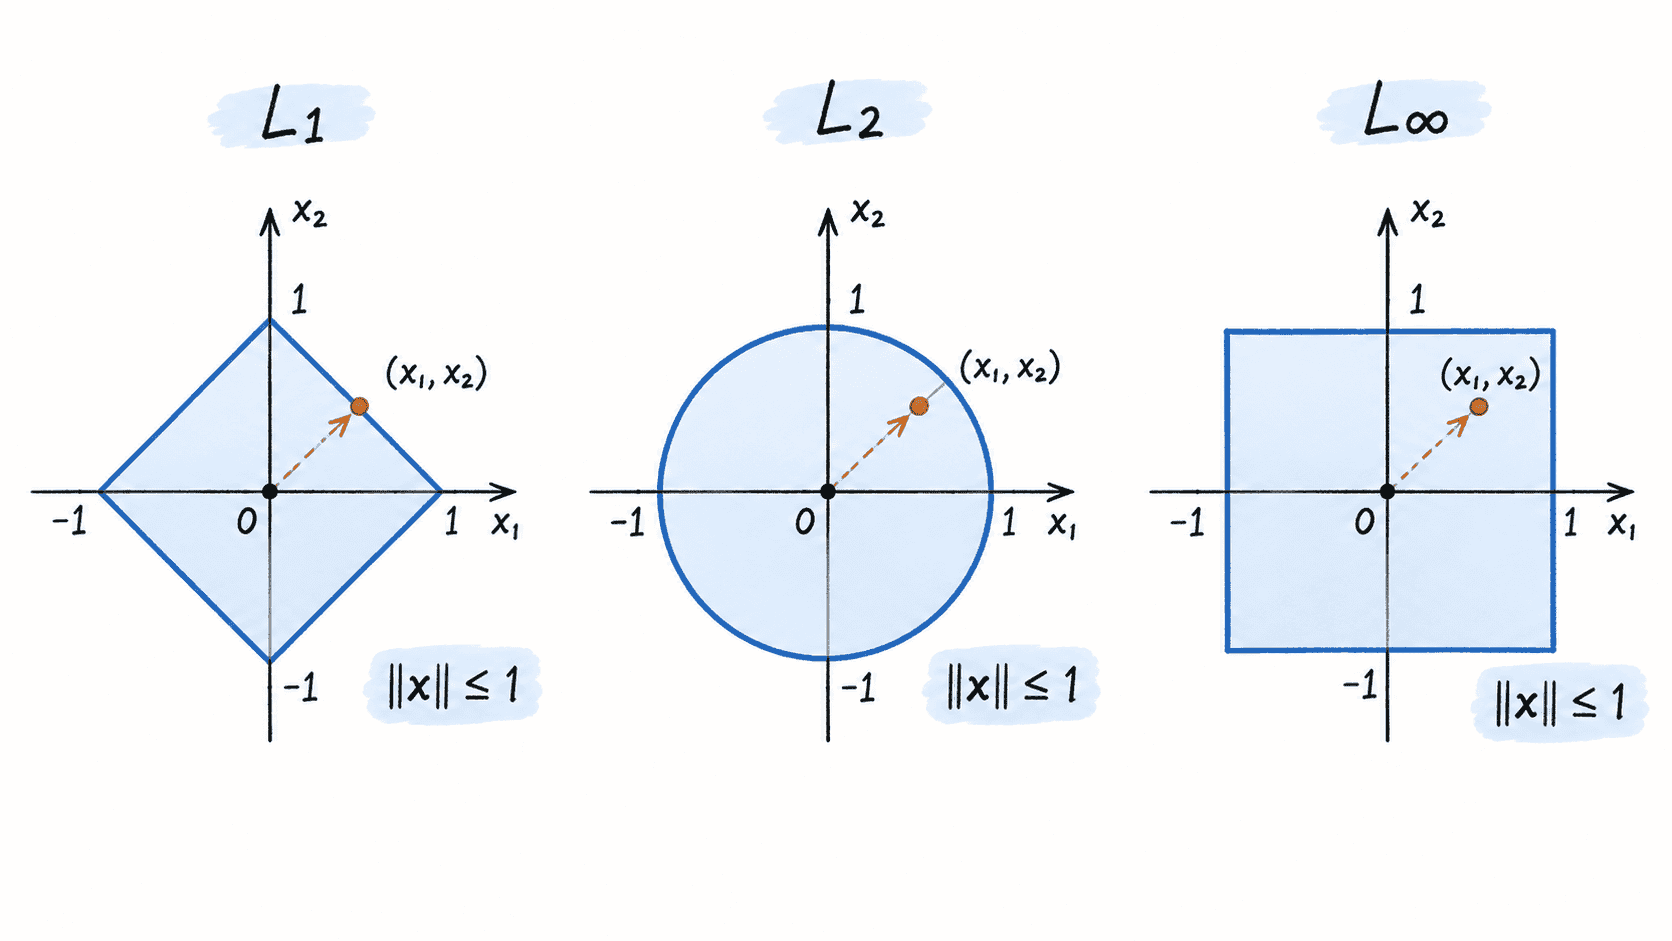
当目标是鼓励稀疏解时,L1 常见,因为它的约束边界在坐标轴方向有尖角;当希望度量欧氏长度时,L2 最自然;当关注“最大单项偏差不能超过多少”时,L∞ 更直接。三者没有绝对优劣,关键是它们表达的业务含义不同。
矩阵范数在优化里表示什么
矩阵可以看作线性变换。矩阵范数描述这个变换会把输入向量放大到什么程度。常见的诱导 2-范数等于最大奇异值,反映最强放大方向;Frobenius 范数则把所有元素平方后求和再开方,更像矩阵整体能量。
在优化中,矩阵范数常用于分析 Hessian、雅可比矩阵或误差传播。例如当某个线性算子的 2-范数很大时,一个很小的输入扰动可能被明显放大。后续讨论条件数、梯度 Lipschitz 常数和预处理时,都会继续用到这种“放大倍数”的观点。
用代码核对数值
下面用 NumPy 同时计算向量范数、两点距离和几种矩阵范数。示例依赖已安装的 NumPy。
import numpy as np

x = np.array([3.0, -4.0])
y = np.array([1.0, -1.0])
A = np.array([[1.0, 2.0], [3.0, 4.0]])

# 向量范数既可度量“大小”,也可用于两点之差形成的距离。
for order, name in [(1, "L1"), (2, "L2"), (np.inf, "Linf")]:
    print(f"{name} norm(x) = {np.linalg.norm(x, ord=order):.4f}")
    print(f"{name} distance(x, y) = {np.linalg.norm(x - y, ord=order):.4f}")

# 矩阵 1/2/∞ 范数是诱导范数,Frobenius 范数衡量整体元素能量。
print(f"matrix 1-norm = {np.linalg.norm(A, ord=1):.4f}")
print(f"matrix 2-norm = {np.linalg.norm(A, ord=2):.4f}")
print(f"matrix inf-norm = {np.linalg.norm(A, ord=np.inf):.4f}")
print(f"matrix Frobenius norm = {np.linalg.norm(A, ord='fro'):.4f}")
预期输出
L1 norm(x) = 7.0000
L1 distance(x, y) = 5.0000
L2 norm(x) = 5.0000
L2 distance(x, y) = 3.6056
Linf norm(x) = 4.0000
Linf distance(x, y) = 3.0000
matrix 1-norm = 6.0000
matrix 2-norm = 5.4650
matrix inf-norm = 7.0000
matrix Frobenius norm = 5.4772
选择哪一种度量
停止条件通常应与实际容忍误差一致:如果任何一个参数超差都不可接受,可考虑 L∞;如果关心整体均方意义上的偏差,L2 更自然。正则化同样如此,L1 往往偏向产生更多零分量,L2 则倾向于让参数整体变小而不是直接变成零。
真正需要记住的不是公式数量,而是:范数定义了优化问题中“大小”和“距离”的语言。只要度量选得与目标一致,误差、步长、正则化和约束半径就能使用同一套数学表达。