
AI 与工程数学 / 系统课时
用拟牛顿法避开显式 Hessian
用拟牛顿法避开显式 Hessian
拟牛顿法希望获得牛顿法的曲率优势,却不直接计算二阶导数。以 BFGS 为代表的方法只观察连续两次位置和梯度的变化,就能逐步更新 Hessian 逆矩阵的近似,在中等规模光滑优化中常比普通梯度下降更快。
学习目标
- 理解位移 和梯度变化 如何提供局部曲率信息
- 掌握 BFGS 逆 Hessian 近似的更新与搜索流程
- 区分梯度下降、BFGS 和 L-BFGS 适合的问题规模
二阶信息可以从梯度变化中估计
牛顿法需要真实 Hessian,而拟牛顿法维护一个近似矩阵。以逆 Hessian 近似 为例,搜索方向写成:
完成一次移动后,记录位置变化和梯度变化:
对于局部近似为二次函数的问题,有 ,其中 是 Hessian。因此一对 就包含了沿本次移动方向观察到的曲率信息。BFGS 的核心工作,就是把这些新信息融合到已有近似中,而不是重新计算整个 Hessian。
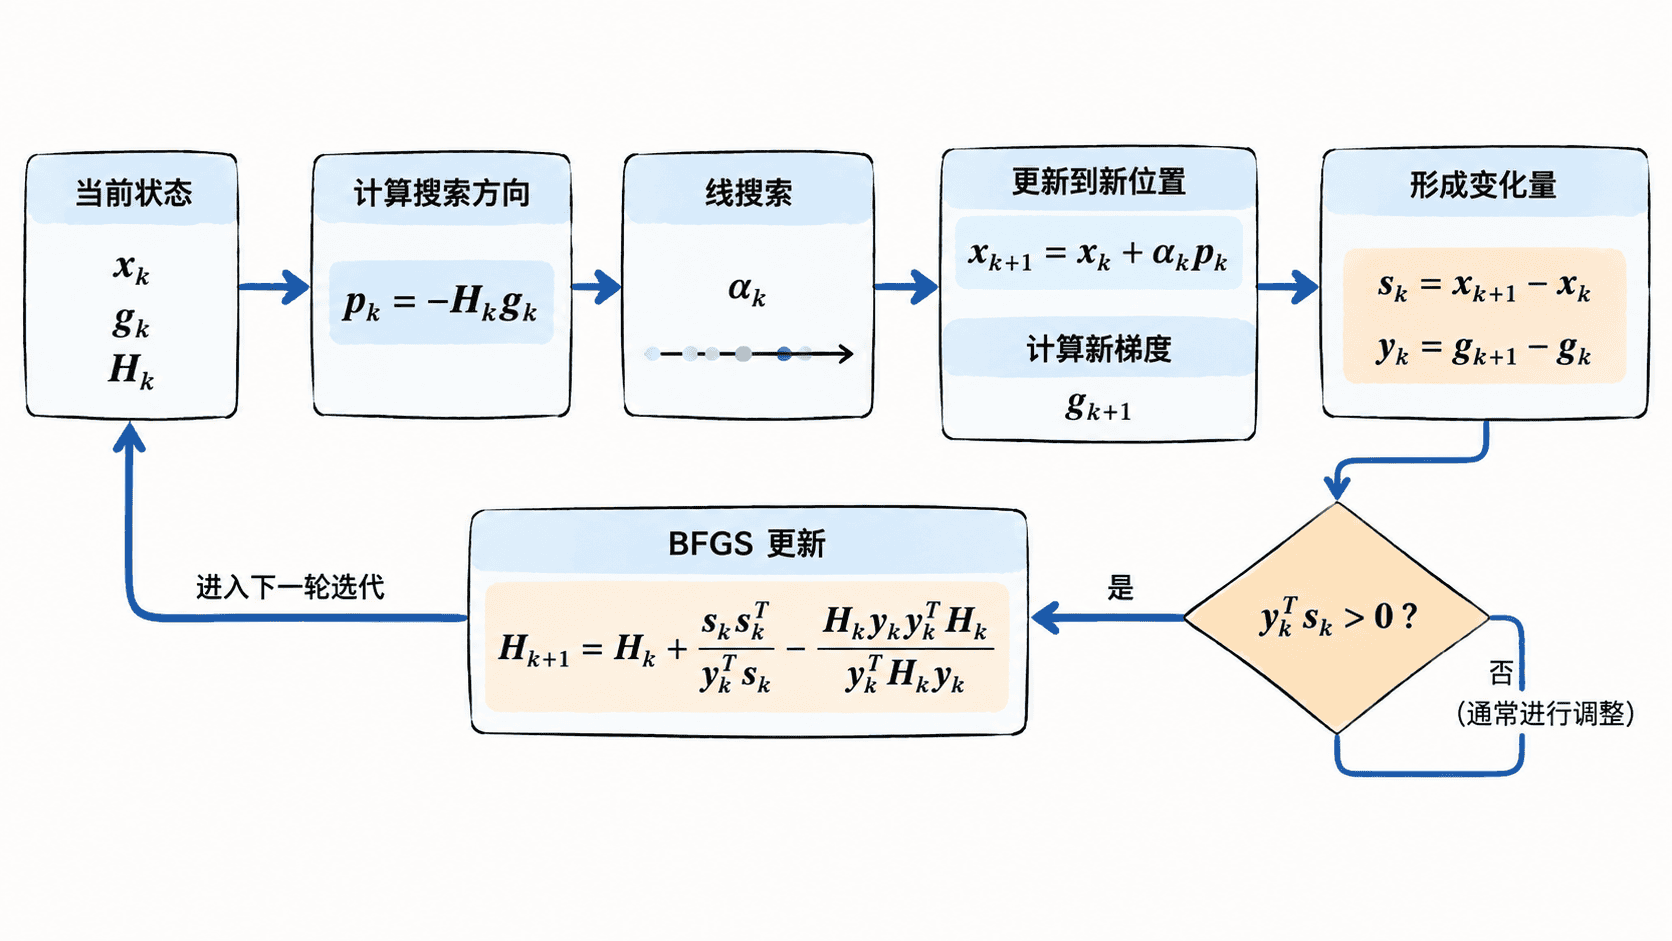
BFGS 怎样更新近似矩阵
令 ,BFGS 对逆 Hessian 近似采用更新:
这个公式看起来复杂,但目的很明确:新的 要保留过去积累的曲率信息,同时满足新的割线条件,使当前观察到的 与 一致。
当 正定且 时,标准 BFGS 更新能够继续保持正定性,于是 仍是下降方向。实际实现通常使用满足 Wolfe 条件的线搜索,这也是维护该曲率条件的重要手段。
用一个二维问题观察两次迭代
下面仍使用一个正定二次函数。为了让输出完全可复现,示例利用已知二次矩阵计算精确线搜索步长;一般非线性问题不会直接拥有这个矩阵,实际 BFGS 通常改用 Wolfe 线搜索。
def dot(a, b):
    return sum(x * y for x, y in zip(a, b))


def mat_vec(matrix, vector):
    return [sum(matrix[i][j] * vector[j] for j in range(2)) for i in range(2)]


def mat_mul(a, b):
    return [[sum(a[i][k] * b[k][j] for k in range(2)) for j in range(2)] for i in range(2)]


def outer(a, b):
    return [[a[i] * b[j] for j in range(2)] for i in range(2)]


def add(a, b):
    return [[a[i][j] + b[i][j] for j in range(2)] for i in range(2)]


def sub(a, b):
    return [[a[i][j] - b[i][j] for j in range(2)] for i in range(2)]


def scale(matrix, value):
    return [[value * matrix[i][j] for j in range(2)] for i in range(2)]


def objective(x):
    a, b = x[0] - 2.0, x[1] + 1.0
    return a * a + 4.0 * b * b + a * b


def gradient(x):
    a, b = x[0] - 2.0, x[1] + 1.0
    return [2.0 * a + b, 8.0 * b + a]


A = [[2.0, 1.0], [1.0, 8.0]]  # 该二次函数的真实 Hessian,仅用于精确线搜索
I = [[1.0, 0.0], [0.0, 1.0]]
x = [0.0, 0.0]
H = [[1.0, 0.0], [0.0, 1.0]]  # BFGS 从单位阵开始近似逆 Hessian

for iteration in range(2):
    g = gradient(x)
    p = [-v for v in mat_vec(H, g)]

    # 对当前二次示例做精确线搜索
    alpha = -dot(g, p) / dot(p, mat_vec(A, p))
    x_new = [x[i] + alpha * p[i] for i in range(2)]
    g_new = gradient(x_new)

    s = [x_new[i] - x[i] for i in range(2)]
    y = [g_new[i] - g[i] for i in range(2)]
    ys = dot(y, s)
    if ys <= 1e-12:
        raise ValueError('curvature condition failed')

    rho = 1.0 / ys
    left = sub(I, scale(outer(s, y), rho))
    right = sub(I, scale(outer(y, s), rho))
    H = add(mat_mul(mat_mul(left, H), right), scale(outer(s, s), rho))
    x = x_new

    print(f'iter {iteration + 1}: x=({x[0]:.6f}, {x[1]:.6f}), f={objective(x):.6f}')
预期输出:
iter 1: x=(0.500000, -1.000000), f=2.250000
iter 2: x=(2.000000, -1.000000), f=0.000000
第一次迭代时 ,所以搜索方向本质上还是负梯度方向。得到新的 和 后,第二次搜索已经使用更新过的曲率近似,因此在这个二维二次问题中迅速到达最优点。
与梯度下降的使用边界
梯度下降每轮只需要梯度和一个步长,额外内存很小,但面对不同方向曲率差异很大的问题时容易沿狭长谷底来回摆动。BFGS 会利用历史梯度变化校正方向,因此通常需要更少的迭代,但完整矩阵需要 存储和运算。
当变量规模达到数万甚至更多时,保存完整 BFGS 矩阵往往不现实。L-BFGS 不保存整个矩阵,而只保留最近若干组 ,把内存开销降低到与变量维度近似线性相关,因此更适合大规模问题。
如果目标函数光滑、梯度可靠、变量规模中等,而显式 Hessian 的构造或分解又太昂贵,BFGS 通常是很有竞争力的默认选择;若梯度本身噪声很大、函数不可微或维度极高,则应根据问题结构选择其他优化方法。