
AI 与工程数学 / 系统课时
比较单纯形与内点法思路
比较单纯形与内点法思路
线性规划不仅要得到最优解,还要考虑模型规模、稀疏性和求解过程。本节从几何路线出发,对比单纯形法沿可行域边界顶点移动与内点法从内部逼近最优点的差异,并理解为什么两者可能得到相同答案,却表现出不同的计算特征。
学习目标
- 从几何视角区分单纯形法与内点法的搜索路线
- 理解两类方法在迭代对象、稀疏大模型和最终解形态上的主要差异
- 能根据问题规模和求解需求形成基本的算法选择判断
同一个线性规划,两条不同路线
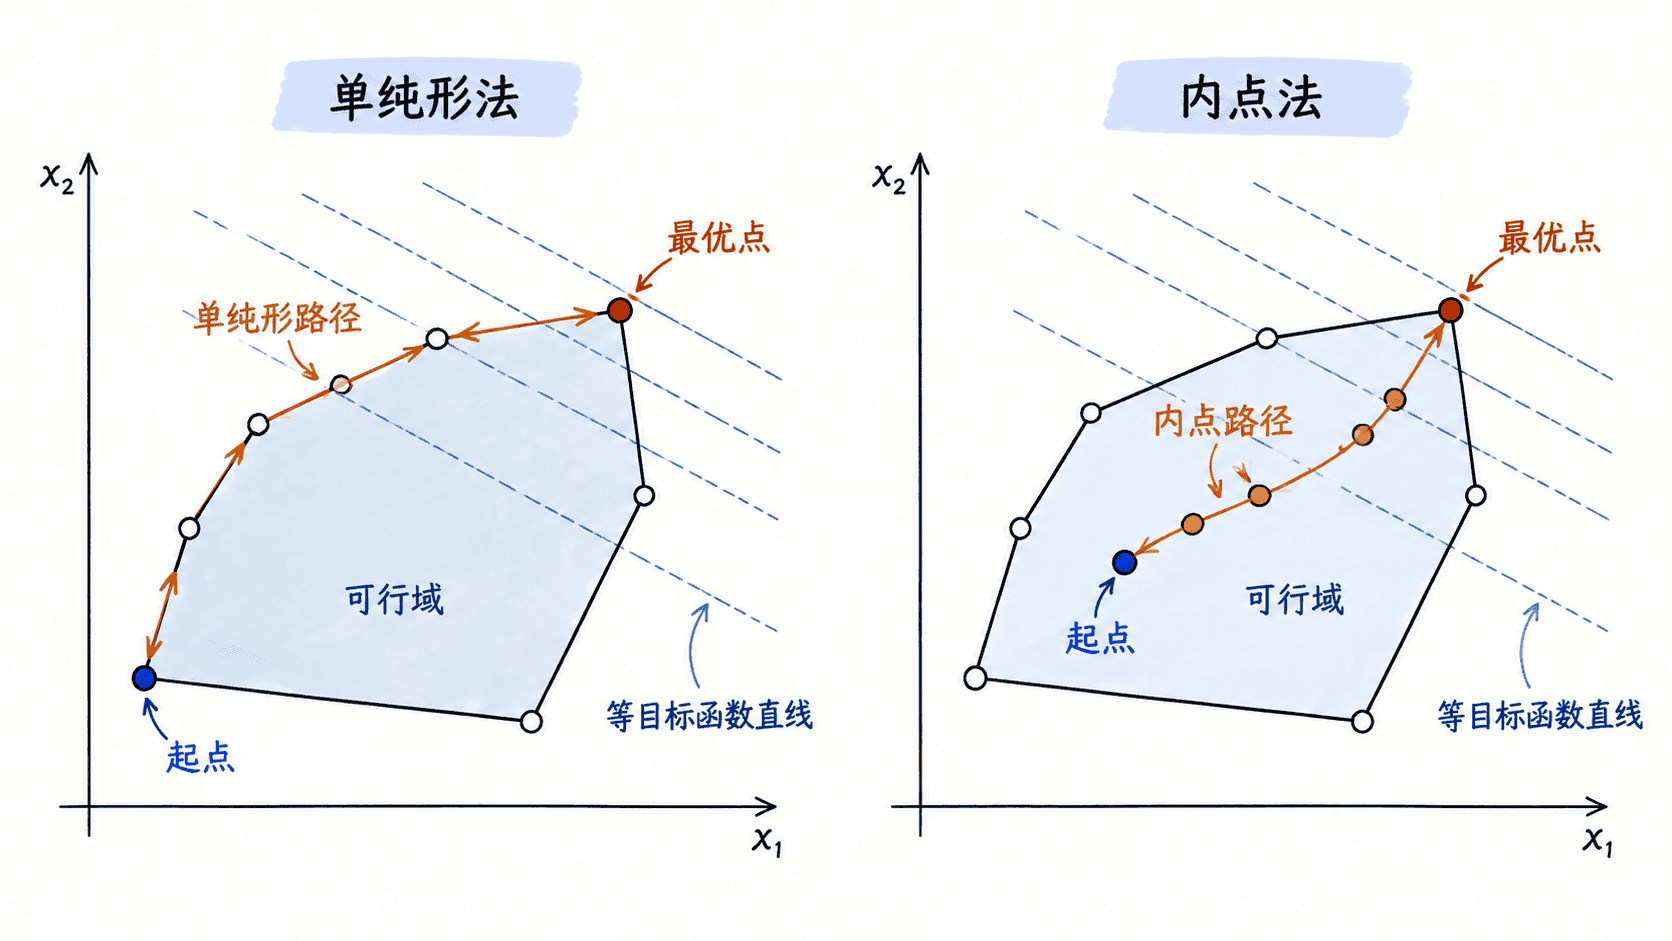
考虑二维线性规划:在若干线性约束围成的凸多边形中,寻找让线性目标函数最小的点。只要问题存在有限最优解,至少有一个最优解可以落在可行域的顶点上。
单纯形法正是利用这个结构。它通常维护一个基本可行解,也就是几何上的顶点,然后选择相邻边进入下一个更优顶点。整个过程更像沿着多边形的边界逐站移动。
内点法不要求每一步都停在顶点上。它从可行域内部出发,通过障碍函数等机制避免过早碰到约束边界,并沿连续方向不断逼近最优位置。
单纯形法到底在更新什么
标准形式的线性规划可以写成目标函数与一组线性等式、非负约束。单纯形法把变量划分为基变量与非基变量,一个基对应一个候选顶点。每次迭代会选择进入基和离开基的变量,从当前基切换到相邻的基。
因此,单纯形法的核心并不是在整个空间里任意调整坐标,而是在一系列基之间转换。实际工程中的修正单纯形法还会复用矩阵分解,避免每次都直接计算完整逆矩阵。
它的一个重要特点是最终天然得到基解。当业务关心哪些约束起作用、哪些变量处于边界,或者需要进行灵敏度分析时,这种结构往往很有价值。
内点法为什么能穿过可行域内部
内点法通常把不等式约束的边界通过障碍项引入目标。例如要求某个变量保持正值时,可以加入随变量接近零而急剧增大的障碍,使迭代点尽量留在内部。
随着障碍参数逐步减小,障碍问题的最优点会沿所谓中心路径靠近原问题的最优解。每一步通常需要求解由一阶、二阶条件构成的线性方程组,所以它更依赖高质量的矩阵分解与稀疏线性代数。
与逐个顶点移动相比,内点法一次迭代可能完成更大范围的连续调整。面对变量和约束很多的大型稀疏问题时,这种计算模式通常更有吸引力。
不过,内点法接近最优面时得到的解未必天然就是某个基顶点。如果后续算法需要基本可行解,求解器可能继续执行 crossover,把内部解转换为基解。
用同一个模型验证求解结果
下面用 SciPy 的 HiGHS 双单纯形与 HiGHS 内点法求解同一个线性规划。模型是最小化 ,等价于最大化 ,约束为 、、,且变量非负。
import numpy as np
from scipy.optimize import linprog

c = np.array([-3.0, -2.0])
A_ub = np.array([
    [1.0, 1.0],
    [1.0, 0.0],
    [0.0, 1.0],
])
b_ub = np.array([4.0, 2.0, 3.0])

for method in ("highs-ds", "highs-ipm"):
    result = linprog(
        c,
        A_ub=A_ub,
        b_ub=b_ub,
        bounds=[(0, None), (0, None)],
        method=method,
    )
    print(method, result.success, np.round(result.x, 6), round(result.fun, 6))
预期输出
highs-ds True [2. 2.] -10.0
highs-ipm True [2. 2.] -10.0
两种方法都找到 ,目标值为 。这说明算法路线不同,不代表优化问题的答案不同。实际求解器还会进行缩放、预处理和 crossover,因此不能仅凭最终解反推出内部走过了哪些迭代点。
什么时候更关注哪一种方法
单纯形法适合需要基解、频繁重优化或希望利用已有基进行热启动的场景。例如模型只修改少量约束或目标系数时,上一次的基可能成为很好的起点。
内点法往往更适合规模很大、矩阵高度稀疏的线性规划,尤其当从零开始求解一个大型模型时。它的迭代次数通常不会随着顶点数量直接增长,但每一步都需要解决较大的线性代数子问题。
因此不应把选择规则简化成“单纯形适合小问题、内点法适合大问题”。真正影响性能的还包括稀疏结构、数值条件、热启动需求、是否需要基解以及求解器自身实现。工程上通常先使用成熟求解器的自动策略,再根据日志和基准测试决定是否固定某条算法路线。