
AI 与工程数学 / 系统课时
用泰勒展开构造局部模型
用泰勒展开构造局部模型
泰勒展开的价值不是把公式“展开得更长”,而是把难处理的非线性函数在当前点附近替换成更简单的线性或二次模型。梯度下降和牛顿法都可以理解为先构造局部模型,再从模型中产生下一步迭代。
学习目标
- 会写出多元函数的一阶与二阶泰勒局部模型
- 能解释梯度下降与牛顿法分别利用了哪些局部信息
- 理解步长缩小时,一阶与二阶近似误差为何快速下降
从原函数到局部近似
设当前点为 ,准备尝试一个位移 。对足够光滑的函数,一阶泰勒模型为
二阶泰勒模型为
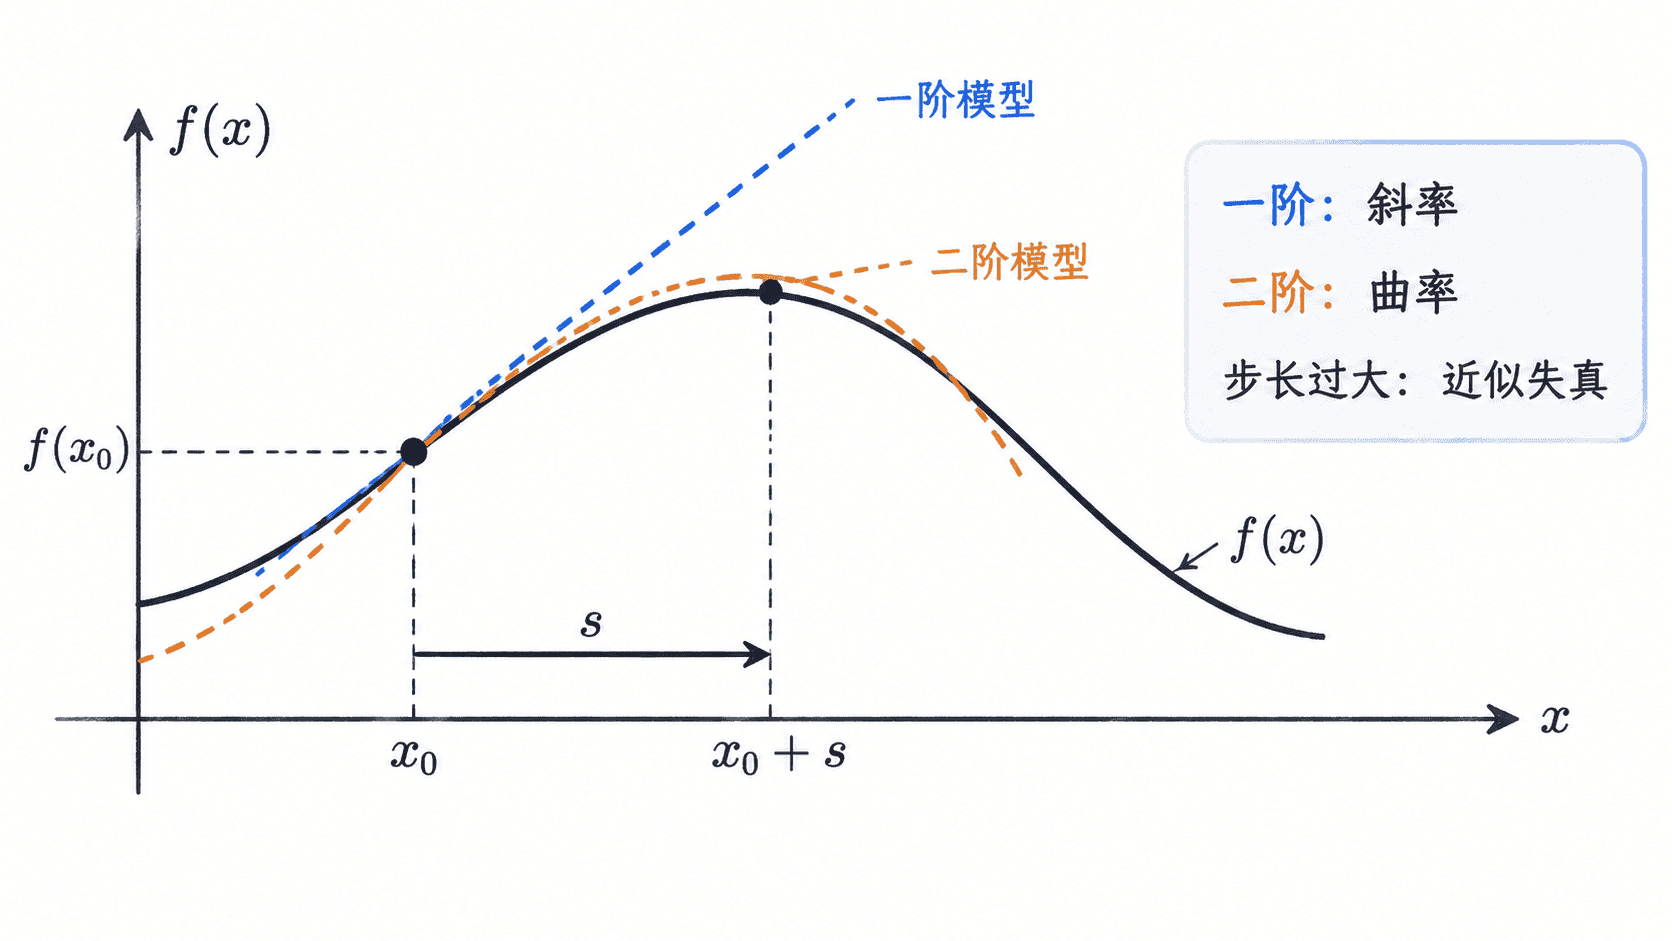
一阶模型只保留当前点的斜率,相当于用切线或切平面近似原函数;二阶模型再加入 Hessian,因此还能描述局部弯曲。只要位移 足够小,这些简单模型就能在当前点附近提供有用的预测。
梯度法与牛顿法来自两个模型
如果只使用一阶模型 ,沿 移动会让线性项下降。但线性模型本身没有曲率限制,如果允许任意大的 ,模型会倾向于让步长无限增大,因此梯度下降还需要步长 :
牛顿法则进一步使用二阶模型。对 关于 求梯度并令其为零:
若 Hessian 可逆,就得到
因此,梯度法主要相信当前位置的斜率,再用步长控制移动距离;牛顿法还利用曲率,希望直接找到二次模型的极小点。这也是牛顿法接近良好极小点时通常比普通梯度下降收敛更快的原因之一。
步长决定近似是否可信
泰勒模型只在展开点附近可靠。以一元函数为例,在足够光滑的条件下,一阶模型遗漏的主导误差通常是 ,二阶模型遗漏的主导误差通常是 。因此步长缩小时,二阶模型通常会比一阶模型更快逼近真实函数。
下面用 在 处验证这个趋势:
import math

def f(x):
    return math.exp(x)

def first_order(h):
    return 1.0 + h

def second_order(h):
    return 1.0 + h + 0.5 * h * h

for h in (0.4, 0.2, 0.1):
    exact = f(h)
    err1 = abs(exact - first_order(h))
    err2 = abs(exact - second_order(h))
    print(f"h={h:.1f} first={err1:.8f} second={err2:.8f}")
预期输出:
h=0.4 first=0.09182470 second=0.01182470
h=0.2 first=0.02140276 second=0.00140276
h=0.1 first=0.00517092 second=0.00017092
随着 变小,两种模型都明显变准,而且二阶模型的误差下降得更快。这说明优化算法不能只关心搜索方向:即使方向合理,步子过大也可能离开展开点太远,使局部模型失去预测能力。
局部模型如何产生一次迭代
实际优化可以理解为反复执行“建模、提出候选步、验证”的过程。在当前位置计算函数值、梯度以及必要时的 Hessian,构造局部模型;然后从模型中求一个候选位移 ;最后再判断这个位移是否仍处在模型可信的邻域内。
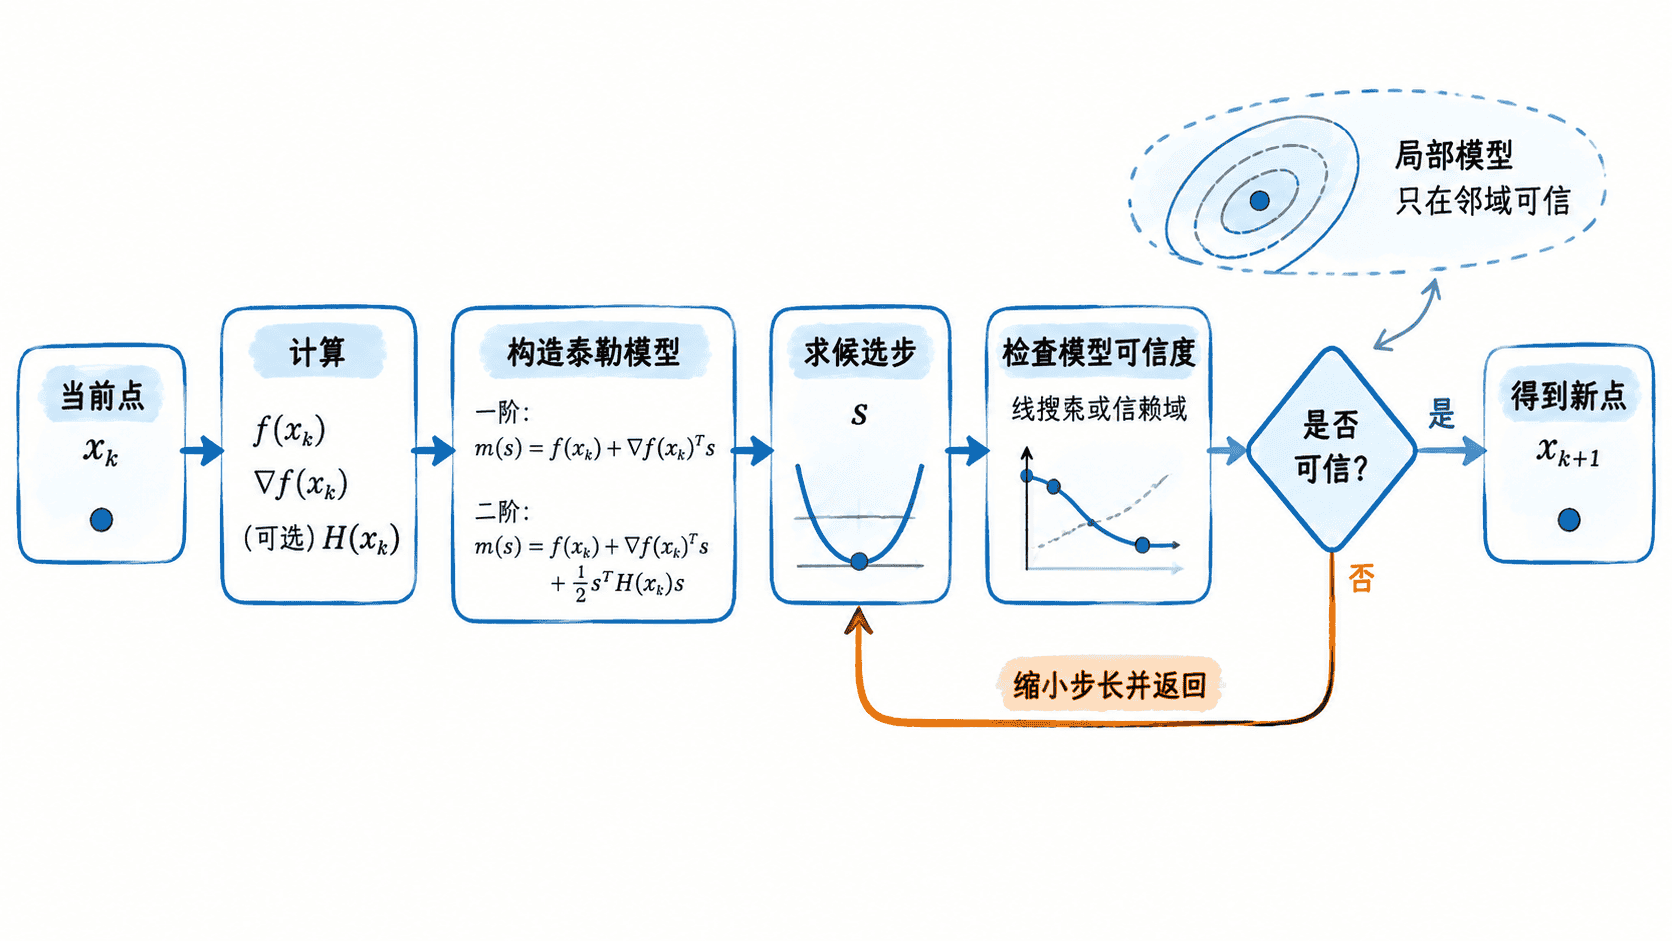
梯度下降通常选择简单的一阶模型,再依靠学习率或线搜索控制步长;牛顿法选择信息更丰富的二阶模型,但需要计算或近似 Hessian,并求解相应线性方程。信赖域方法则把“模型只在附近可信”直接变成约束,只允许在受控邻域内寻找模型的最优步。
泰勒展开在优化中的核心角色因此是构造一个可计算的局部代理:先用低阶模型代替复杂目标函数,再通过步长、线搜索或信赖域控制近似误差,让每一次局部计算逐渐推动迭代走向真正的最优点。