
AI 与工程数学 / 系统课时
用步长控制收敛速度
用步长控制收敛速度
梯度方向告诉我们“往哪走”,步长决定“走多远”。同一个目标函数和同一个初值,仅改变步长,就可能出现缓慢收敛、快速下降或来回震荡甚至发散。本节比较固定步长与 Armijo 回溯线搜索,并把“充分下降”写成可执行的判断条件。
学习目标
- 能解释固定步长过小、合适和过大时的典型现象
- 能写出 Armijo 充分下降条件并理解回溯线搜索流程
- 能用目标值和梯度范数验证步长策略是否有效
固定步长为什么可能失控
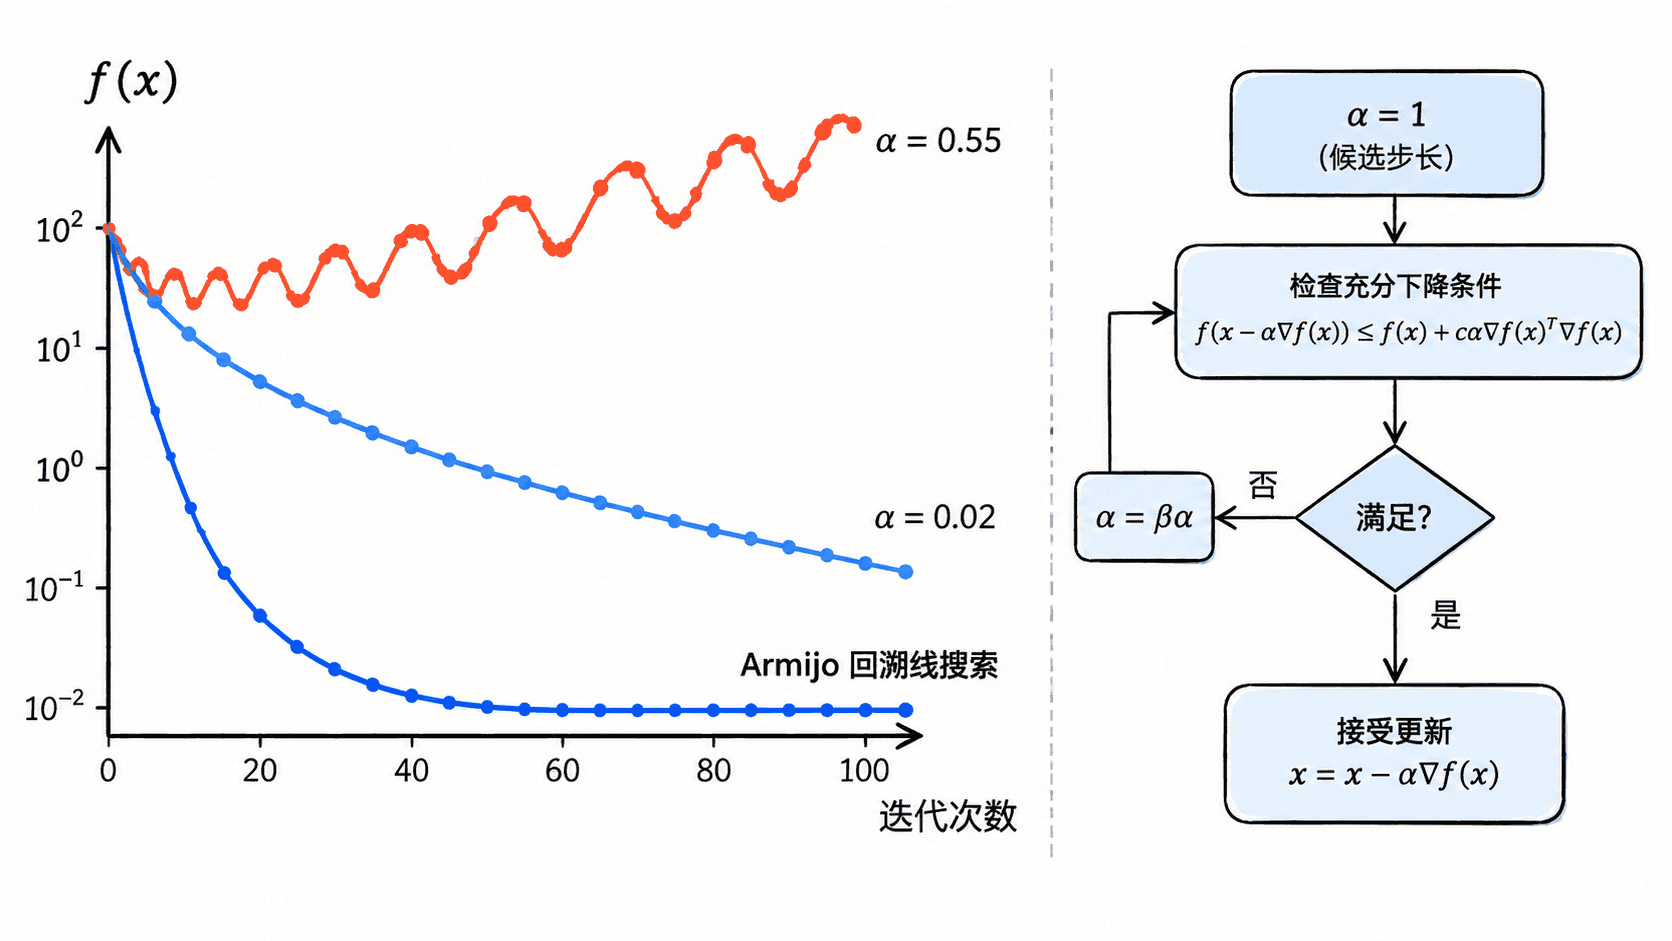
仍使用 ,沿负梯度方向更新。固定步长最简单,但它完全不看当前位置的局部曲率:步长过小,每次下降有限;步长过大,则可能跨过谷底,在两侧反复跳跃,甚至越跳越远。
对同一个初值 , 会稳定但很慢; 在这个函数上已经过大,目标值会不断放大。固定步长的优点是实现和计算成本低,缺点是需要人工调参,而且一个全程不变的值未必适合所有迭代阶段。
Armijo 条件要求下降得足够多
线搜索不再预先承诺一个固定步长,而是在当前下降方向上试探。Armijo 条件常写成:
其中 是很小的正数。右边给出了“这一步至少应该下降多少”的门槛。如果候选步长不能满足,就把步长乘以缩减系数 ,例如从 1 依次尝试 0.5、0.25、0.125,直到条件成立。
这种方法的关键不是找到当前方向上的精确最佳步长,而是用较低成本排除明显过大的更新,让每次接受的步长都具备足够下降性。
用程序比较三种结果
下面的示例让固定步长各执行 6 次更新,并让 Armijo 从候选步长 1 开始回溯。回溯中使用 、;当梯度范数已经近似为 0 时提前停止。
from math import sqrt

def f(x, y):
    return (x - 1) ** 2 + 2 * (y + 2) ** 2

def grad(x, y):
    return 2 * (x - 1), 4 * (y + 2)

def norm(gx, gy):
    return sqrt(gx * gx + gy * gy)

def run_fixed(alpha, steps=6):
    x, y = 4.0, 2.0
    for _ in range(steps):
        gx, gy = grad(x, y)
        x -= alpha * gx
        y -= alpha * gy
    gx, gy = grad(x, y)
    return f(x, y), norm(gx, gy)

def run_armijo(max_steps=6, c=1e-4, beta=0.5):
    x, y = 4.0, 2.0
    accepted = []
    for _ in range(max_steps):
        gx, gy = grad(x, y)
        if norm(gx, gy) < 1e-12:
            break

        current = f(x, y)
        g2 = gx * gx + gy * gy
        alpha = 1.0

        # 只接受满足充分下降条件的候选步长。
        while f(x - alpha * gx, y - alpha * gy) > current - c * alpha * g2:
            alpha *= beta

        accepted.append(alpha)
        x -= alpha * gx
        y -= alpha * gy

    gx, gy = grad(x, y)
    return f(x, y), norm(gx, gy), accepted

for alpha in (0.02, 0.55):
    value, gnorm = run_fixed(alpha)
    print(f"fixed alpha={alpha:.2f}: f={value:.6f}, ||g||={gnorm:.6f}")

value, gnorm, accepted = run_armijo()
print(f"Armijo: f={value:.6f}, ||g||={gnorm:.6f}, accepted={accepted}")
预期输出:
fixed alpha=0.02: f=17.279712, ||g||=10.778689
fixed alpha=0.55: f=285.315214, ||g||=47.775744
Armijo: f=0.000000, ||g||=0.000000, accepted=[0.5, 0.25]
固定小步长的目标值确实下降,但 6 步后仍离最优点很远;过大的固定步长把目标值从初始的 41 推高到 285.315214,说明迭代已经发散。Armijo 则先把候选步长 1 缩到 0.5,下一步接受 0.25,并在这个二次函数上直接到达极小点。
什么时候选固定步长或线搜索
固定步长适合问题尺度稳定、已经有可靠经验值,或者单次迭代必须尽可能便宜的场景。若目标函数曲率变化明显,或者你经常看到目标值忽高忽低,回溯线搜索通常更稳健。
Armijo 的价值在于把调步长从“凭感觉选一个数”变成可验证规则:先尝试较积极的更新,若下降不充分就逐级收缩,只接受满足条件的步长。这样既能避免明显过大的更新,也比一开始就使用极小固定步长更有机会获得较快收敛。