
AI 与工程数学 / 系统课时
读懂求解器的终止状态
读懂求解器的终止状态
优化程序“停了”不等于“求到答案了”。这一节把 SciPy 返回的 OptimizeResult 当成诊断报告来读:先看 success 和 message,再结合迭代次数、函数调用次数、梯度大小和约束残差,判断它究竟是正常收敛、达到上限,还是在搜索过程中失败。
学习目标
- 能用
success、message、nit和nfev判断求解器为何停止 - 能用梯度范数和约束残差验证一次“成功”是否可信
- 能区分正常收敛、迭代上限、线搜索失败和可能不可行等结束原因
不要只看 success
result.success 是第一道判断,但不是完整结论。它表示当前求解方法认为自己的成功终止条件已经满足。继续查看 message,才能知道究竟是哪一种内部条件触发了停止。
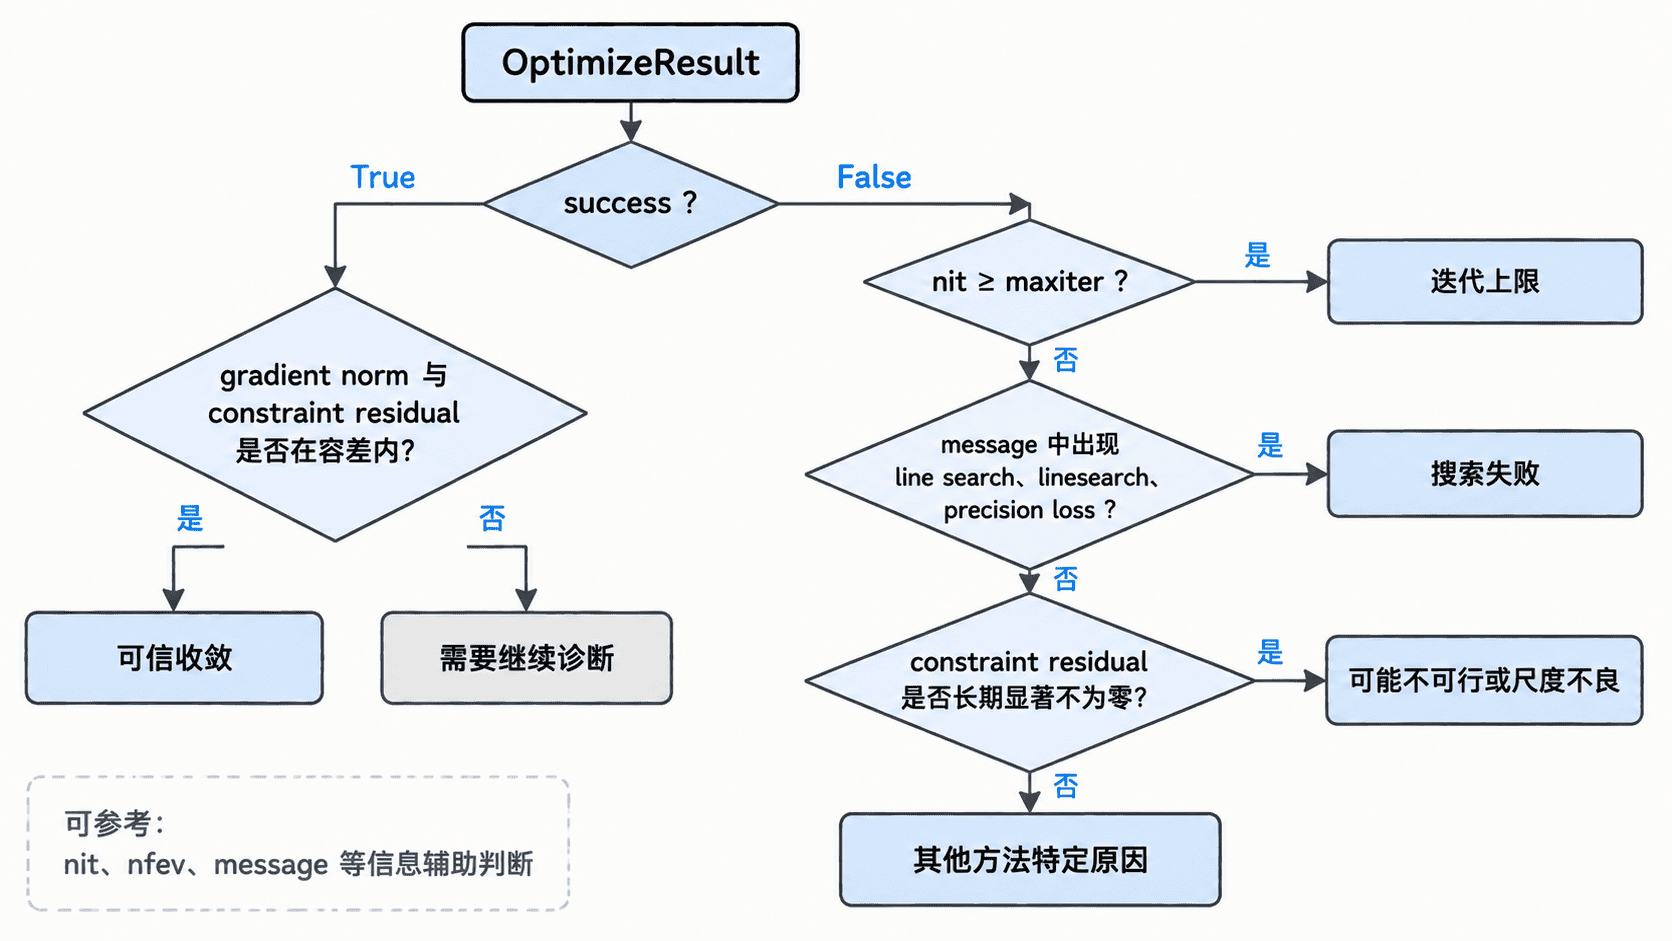
nit 是迭代次数,nfev 是目标函数评估次数。如果 success=False,同时 nit 已经达到设置的 maxiter,首先应判断为迭代预算耗尽,而不是直接断言模型无解。对于可微问题,还应检查最终点附近的梯度;对于约束问题,还必须检查约束违反量。
用同一个问题制造两种结束结果
下面先正常求解一个带线性约束的二次问题,再把 maxiter 压到 1,故意制造“尚未收敛就被迫停止”的情况。诊断函数读取核心状态字段,并自己计算梯度范数和约束残差。
import numpy as np
from scipy.optimize import LinearConstraint, minimize

def objective(x):
    return (x[0] - 1.0) ** 2 + (x[1] - 2.0) ** 2

def gradient(x):
    return np.array([
        2.0 * (x[0] - 1.0),
        2.0 * (x[1] - 2.0),
    ])

constraint = LinearConstraint(
    np.array([[1.0, 1.0]]),
    lb=np.array([2.5]),
    ub=np.array([np.inf]),
)

def diagnose(result, maxiter):
    grad_norm = np.linalg.norm(gradient(result.x))
    residual = max(0.0, 2.5 - float(result.x.sum()))
    message = str(result.message)
    lower_message = message.lower()

    if result.success:
        category = 'converged'
    elif result.nit >= maxiter:
        category = 'iteration_limit'
    elif any(key in lower_message for key in (
        'line search', 'linesearch', 'directional derivative', 'precision loss'
    )):
        category = 'search_failure'
    elif 'infeas' in lower_message:
        category = 'possible_infeasible'
    else:
        category = 'other_failure'

    print('category:', category)
    print('success:', result.success)
    print('message:', message)
    print('nit:', result.nit)
    print('nfev:', result.nfev)
    print('grad_norm:', round(grad_norm, 8))
    print('constraint_residual:', round(residual, 8))

x0 = np.array([3.0, 3.0])

ok = minimize(
    objective,
    x0,
    method='SLSQP',
    jac=gradient,
    constraints=[constraint],
    options={'maxiter': 100},
)

limited = minimize(
    objective,
    x0,
    method='SLSQP',
    jac=gradient,
    constraints=[constraint],
    options={'maxiter': 1},
)

print('normal run')
diagnose(ok, maxiter=100)

print('limited run')
diagnose(limited, maxiter=1)
预期输出
normal run
category: converged
success: True
message: <SUCCESS_MESSAGE>
nit: <NIT>
nfev: <NFEV>
grad_norm: <NEAR_ZERO_VALUE>
constraint_residual: 0.0
limited run
category: iteration_limit
success: False
message: <ITERATION_LIMIT_MESSAGE>
nit: 1
nfev: <NFEV>
grad_norm: <POSITIVE_VALUE>
constraint_residual: 0.0<SUCCESS_MESSAGE>、<ITERATION_LIMIT_MESSAGE>、<NIT>、<NFEV> 和浮点数值可能随 SciPy 版本及运行环境略有差异。这个示例真正要验证的是:正常运行最终被判断为 converged,而 maxiter=1 的运行被判断为 iteration_limit。
四类常见终止原因
真正收敛通常表现为 success=True,并且梯度范数或求解器提供的一阶最优性指标已经足够小,所有约束残差也处于允许容差内。只看到成功标志,却发现约束仍明显违反,就不能直接接受结果。
达到迭代上限时,常见组合是 success=False,并且 nit 接近或等于 maxiter。此时可以检查初值是否离有效区域太远、变量尺度是否差异悬殊、导数是否正确,再决定是否增加迭代预算。
线搜索或搜索方向失败表示算法无法找到满足内部下降条件的有效步长。常见根因包括梯度实现错误、目标函数不够光滑、变量尺度不合适,以及函数在局部区域出现 NaN、inf 或严重数值误差。不同算法的 message 文案并不统一,因此关键字只能辅助定位。
不可行则意味着约束之间可能没有共同满足的点。例如一个变量同时被要求 x >= 10 和 x <= 5。这类问题往往会持续保留显著约束残差,或者由特定求解器报告不兼容约束。此时单纯增加 maxiter 没有意义,应回到模型检查上下界、单位、约束方向和相互冲突的条件。
建立自己的终止验收规则
生产代码最好不要把 result.success 直接等价成业务上的“求解成功”。更稳妥的规则通常同时检查:求解器是否成功、最终目标值是否有限、一阶最优性指标是否进入容差,以及全部约束是否得到满足。
还应把 message、nit、nfev 和最终残差记录下来。它们不仅用于失败排查,也能帮助发现同一个模型在数据规模变化后是否突然需要更多迭代或函数调用。
终止状态的正确读法不是记住某一条 message,而是把“为什么停止”“当前点是否接近最优”“约束是否满足”三件事合在一起判断。只有这三项都说得通,一次求解结果才值得被后续业务逻辑接受。