
AI 与工程数学 / 系统课时
用罚函数把约束并入目标
用罚函数把约束并入目标
当求解器不方便直接处理约束时,可以把“违反约束的代价”加入目标函数,先把约束问题改写成无约束问题。本节用一个一维例子观察罚参数如何控制可行性,并解释为什么罚参数过大反而可能让数值求解变难。
学习目标
- 能把不等式约束写成外罚函数,并区分原目标值与罚后目标值
- 能通过数值实验观察罚参数、约束违反量与近似解之间的关系
- 能解释罚参数过大带来的病态尺度和求解困难
从约束到罚项
考虑约束优化问题:
无约束最优点是 ,但它违反 。真正的约束最优解位于边界 。外罚函数的做法,是定义约束违反量
再构造新的无约束目标:
其中 是罚参数。可行点满足 ,不会受到惩罚;越过边界越远,罚项越大。
罚参数怎样改变解
在这个例子里,只要罚函数最优点仍位于 ,一阶条件给出
因此
当 增大时, 会从无约束最优点 逐渐逼近边界 ,但对任何有限的 ,这里的二次罚函数一般只得到“近似可行”的解。
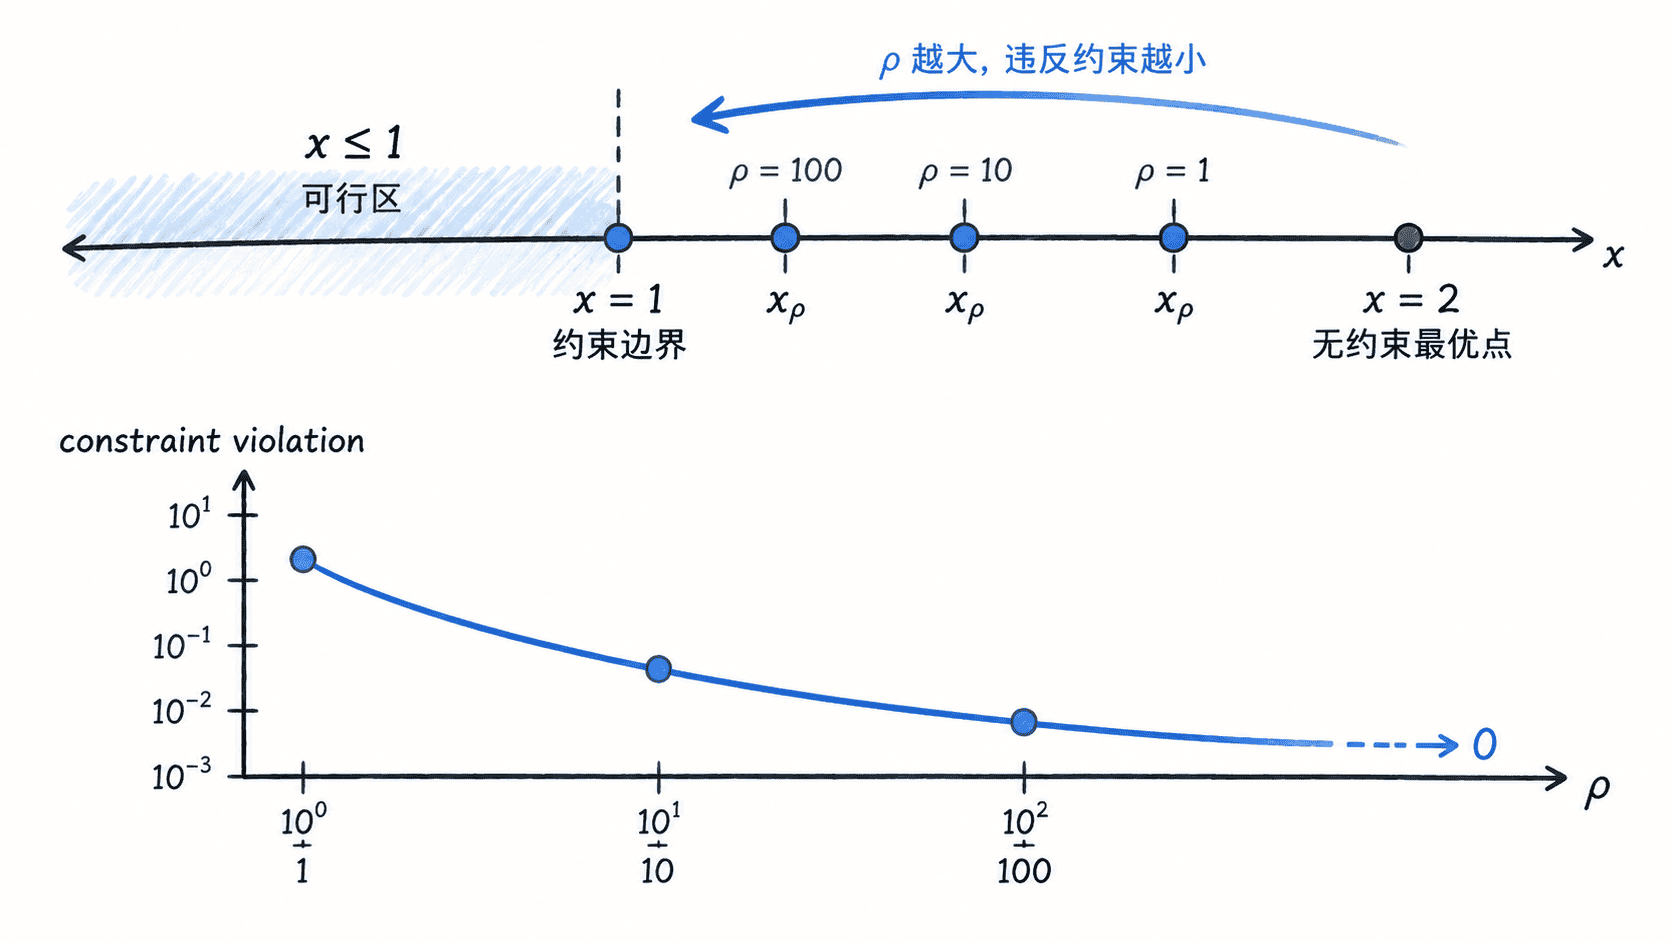
用数值实验观察权衡
下面直接计算不同罚参数对应的解析最优点,不依赖优化库,便于把变化看清楚。
python
def penalty_solution(rho: float) -> tuple[float, float, float]:
    # 对二次罚函数求一阶条件后的解析解
    x = (2.0 + rho) / (1.0 + rho)
    violation = max(0.0, x - 1.0)
    original_objective = (x - 2.0) ** 2
    return x, violation, original_objective


for rho in (1.0, 10.0, 100.0, 1000.0):
    x, violation, f = penalty_solution(rho)
    print(f"rho={rho:6.1f}  x={x:.6f}  violation={violation:.6f}  f={f:.6f}")
预期输出:
text
rho=   1.0  x=1.500000  violation=0.500000  f=0.250000
rho=  10.0  x=1.090909  violation=0.090909  f=0.826446
rho= 100.0  x=1.009901  violation=0.009901  f=0.980296
rho=1000.0  x=1.000999  violation=0.000999  f=0.998003
结果体现了一个关键权衡:罚参数越大,约束违反越小;与此同时,解被更强地推离原始无约束最优点,因此原目标值逐渐接近真正约束最优解的目标值 。
罚参数为什么不能无限放大
从理论上看,让 很大似乎可以逼近可行解,但数值计算会出现尺度失衡:罚项的曲率可能远大于原目标,使目标函数在某些方向极陡、另一些方向较平。对于多维问题,这会放大条件数,导致线搜索困难、步长很小或舍入误差更明显。
工程上更常用逐步增大罚参数的策略,例如从较小的 开始求解,再把上一次结果作为下一次更大罚参数的初值,而不是一开始就设置极大的常数。
什么时候使用罚函数
罚函数适合快速把简单约束并入现有无约束求解流程,也适合帮助理解“目标优化”和“约束可行性”之间的竞争关系。真正落地时,应同时记录原目标值、罚后目标值和最大约束违反量,不能只看到罚后目标下降就认为约束已经满足。
按自己的节奏,确认真正理解。