
AI 与工程数学 / 系统课时
用牛顿法利用二阶曲率
用牛顿法利用二阶曲率
梯度只告诉我们函数当前往哪里下降,牛顿法还利用 Hessian 描述不同方向的曲率,从而同时修正搜索方向和步长尺度。本节从局部二次模型推导牛顿步,并用一个二维问题验证它为何能快速逼近极小点。
学习目标
- 从二次局部模型推导牛顿方向
- 理解 Hessian 如何根据不同方向的曲率缩放梯度
- 判断 Hessian 非正定或求解成本过高时为什么不能直接使用标准牛顿步
从二次局部模型得到牛顿步
在当前点 附近,用二阶 Taylor 信息构造局部模型:
其中 是梯度, 是 Hessian。若这个二次模型是凸的,对 求极小值需要满足:
因此牛顿步为:
实际程序中通常不会显式计算 Hessian 的逆矩阵,而是直接求解线性方程 。这样既更高效,也能减少数值误差。
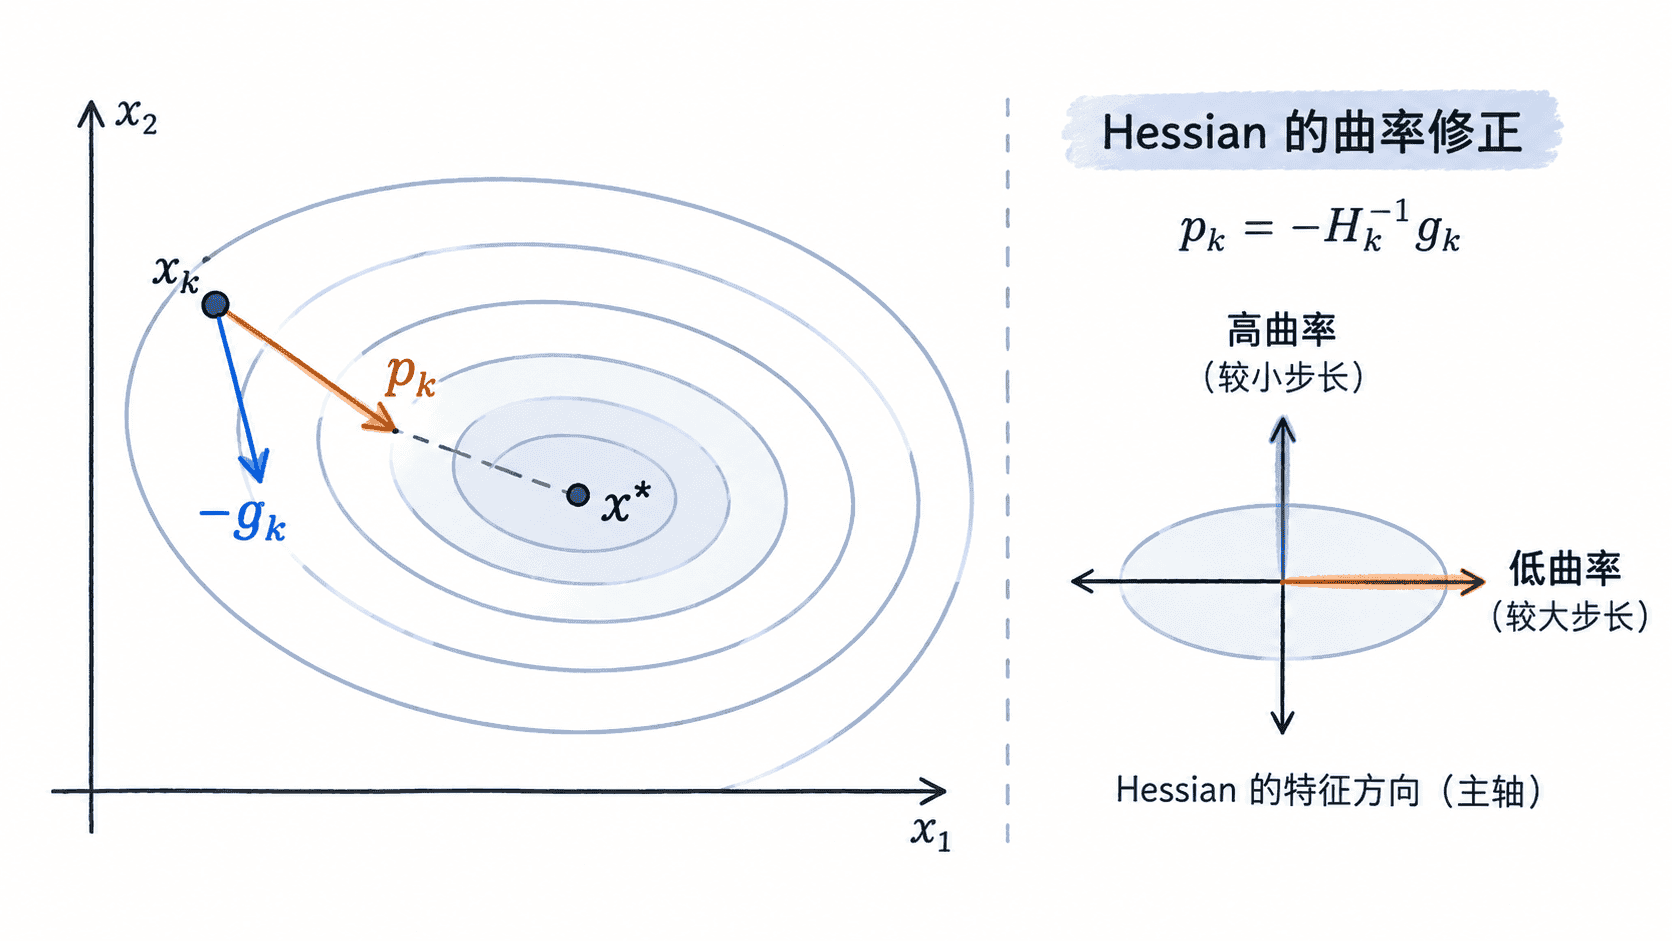
Hessian 如何修正方向和尺度
如果 Hessian 可以分解为 ,那么牛顿步可以理解为先把梯度投影到 Hessian 的主曲率方向,再按各方向曲率的倒数缩放,最后变换回原坐标。
曲率大的方向意味着函数变化快,牛顿法会缩短该方向的步幅;曲率小的方向变化平缓,则会适当放大步幅。因此在狭长的椭圆形等高线上,牛顿方向通常比单纯的负梯度方向更直接。
当目标函数本身就是正定二次函数时,二次局部模型与真实函数完全一致。只要 Hessian 可逆,从任意起点计算一次精确牛顿步就能直接到达最优点。
用二维二次函数验证牛顿步
考虑函数 。它的 Hessian 恒为正定矩阵,下面从 出发直接求解 。示例手写二维线性方程求解器,是为了看清牛顿步;实际工程应使用成熟的线性代数求解器。
def objective(x, y):
    return (x - 2) ** 2 + 4 * (y + 1) ** 2 + (x - 2) * (y + 1)


def gradient(x, y):
    # 梯度来自目标函数的一阶偏导
    return 2 * (x - 2) + (y + 1), 8 * (y + 1) + (x - 2)


def solve_2x2(a, b, c, d, r1, r2):
    # 求解 [[a,b],[c,d]] * p = [r1,r2]
    det = a * d - b * c
    if abs(det) < 1e-12:
        raise ValueError('Hessian is singular')
    return (r1 * d - b * r2) / det, (a * r2 - r1 * c) / det


x, y = 0.0, 0.0
gx, gy = gradient(x, y)
px, py = solve_2x2(2.0, 1.0, 1.0, 8.0, -gx, -gy)
x_next, y_next = x + px, y + py

print(f'gradient = ({gx:.1f}, {gy:.1f})')
print(f'newton_step = ({px:.1f}, {py:.1f})')
print(f'next_point = ({x_next:.1f}, {y_next:.1f})')
print(f'f(next_point) = {objective(x_next, y_next):.1f}')
预期输出:
gradient = (-3.0, 6.0)
newton_step = (2.0, -1.0)
next_point = (2.0, -1.0)
f(next_point) = 0.0
这里一步到达 ,不是因为所有非线性问题都能一步收敛,而是因为该示例本身就是正定二次函数,Newton 使用的二次模型恰好等于真实目标函数。
什么时候不能直接接受牛顿步
标准牛顿方向成为可靠下降方向的重要条件是 Hessian 正定。如果 Hessian 存在负特征值,当前点附近可能包含鞍点方向,此时 甚至可能让目标函数增大;Hessian 接近奇异时,线性方程也会变得非常敏感。
另一个限制是成本。对 维问题,完整 Hessian 需要约 的存储,而直接分解稠密 Hessian 的计算成本通常可达到 。当变量规模很大、二阶导难以获得或 Hessian 结构不适合高效求解时,拟牛顿法、共轭梯度或 Hessian-vector product 往往更合适。
牛顿法真正值得使用的场景,是能够稳定获得二阶曲率,并且线性系统可以可靠、高效地求解;它的优势来自曲率校正,而不是简单地把梯度下降换成一个更复杂的公式。