
AI 与工程数学 / 系统课时
解释凸问题为何没有坏局部解
解释凸问题为何没有坏局部解
这一节解决一个最常见的优化疑问:算法停在某个局部最低点时,能不能把它当成真正的最优解。对凸目标函数来说,答案是可以:只要约束集合也是凸的,任何局部最小值都是全局最小值,因此不必再担心隐藏着更低的“坏局部解”。
学习目标
- 用凸函数定义和割线几何解释“局部最小即全局最小”
- 区分凸问题与非凸问题在初始化敏感性上的差异
- 用一个数值示例验证凸函数不存在更差的局部极小值
从凸函数的定义看形状约束
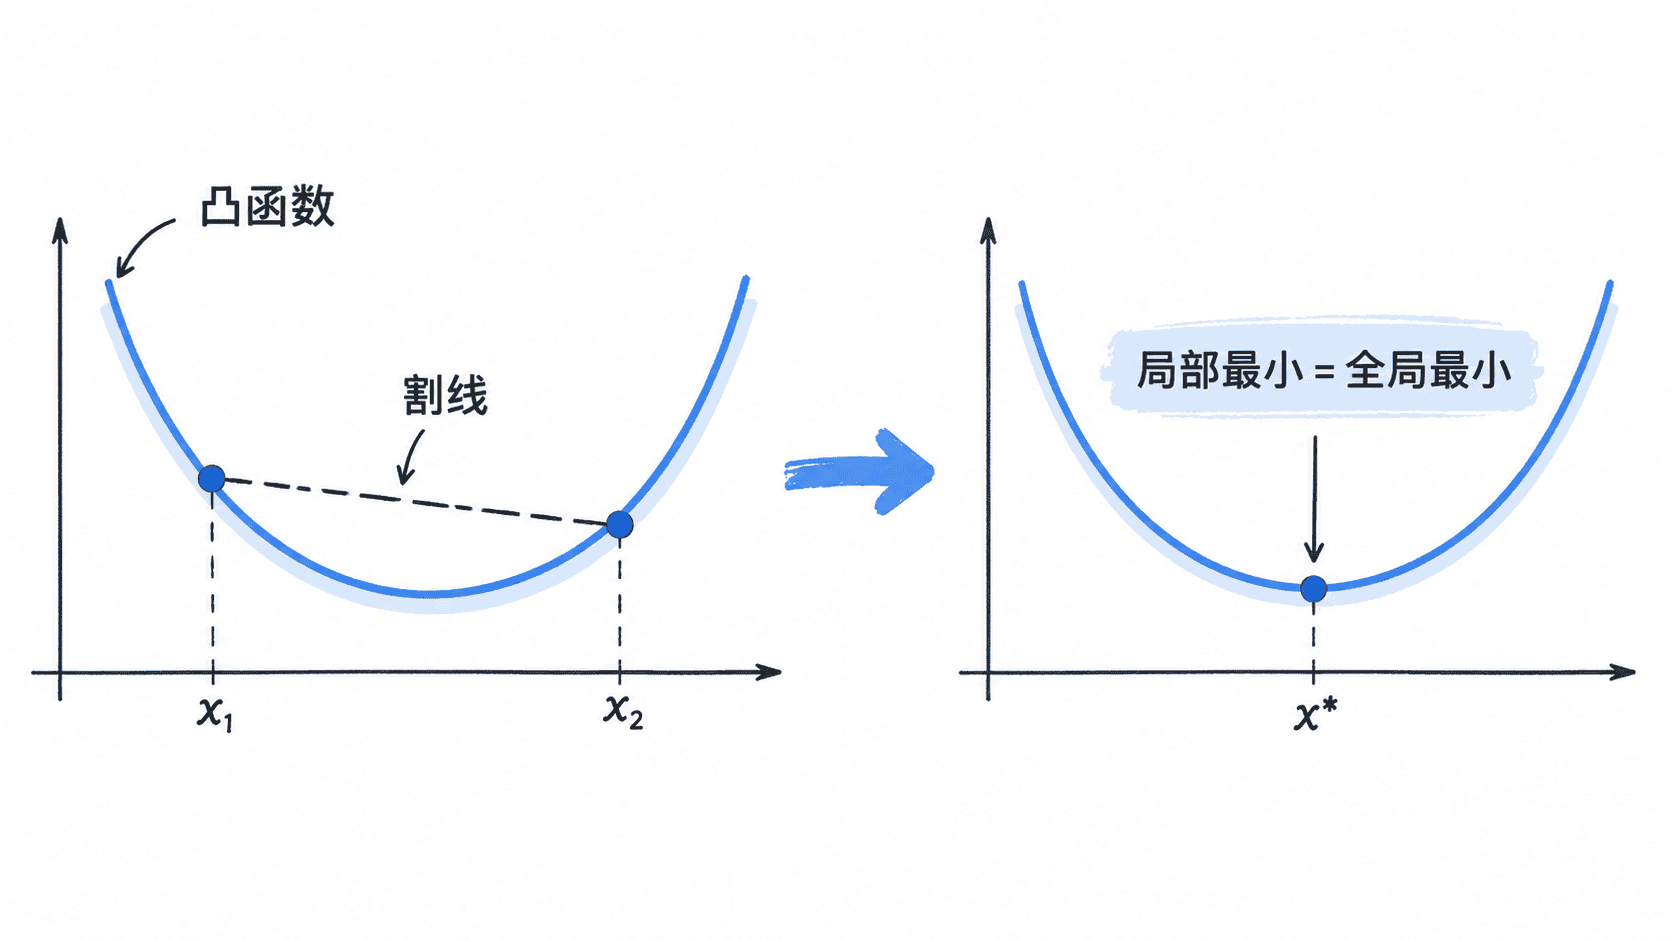
函数 在凸集上是凸函数,意味着任意两点 与 都满足:
右边是两端函数值的线性插值,也就是连接曲线上两点的割线高度。这个不等式要求两点之间的函数图像始终不高于割线,因此函数不能在中间鼓出一个新的山峰,再形成彼此隔离的多个低谷。
为什么局部最小一定是全局最小
设 是一个局部最小值。假设它不是全局最小值,那么一定存在另一个可行点 ,使得 。
因为可行域是凸集,所以从 朝 走一小步得到的点
仍然可行。由凸性可得:
当 足够小时, 可以任意接近 ,却拥有更小的函数值。这与“ 在附近已经最小”矛盾。因此,凸问题里的局部最小值不可能比其他某个可行点更差。
初始化为何通常不再决定解的好坏
非凸问题可能存在多个深浅不同的低谷,算法从不同起点出发,可能落入不同局部极小值。凸问题没有这种“坏低谷”,所以初始化通常影响的是迭代路径和收敛速度,而不是最终解的质量。
这并不意味着任何算法都会自动收敛。步长过大、停止条件错误或数值精度不足,仍可能让算法震荡、发散或提前停止。凸性解决的是最优解结构问题,不替代具体算法的收敛条件。
用数值搜索验证结论
下面用凸函数 做一次简单网格搜索。该函数只有一个碗形低谷,理论上的最小值位于 。
import numpy as np

def f(x: np.ndarray) -> np.ndarray:
    return (x - 3.0) ** 2 + 1.0

xs = np.linspace(-2.0, 8.0, 1001)
ys = f(xs)
best_index = int(np.argmin(ys))

print(f"x* = {xs[best_index]:.2f}")
print(f"f(x*) = {ys[best_index]:.2f}")
预期输出:
x* = 3.00
f(x*) = 1.00
网格中没有出现另一个更低的局部极小值。实际优化算法不会靠穷举搜索,但这个结果直观展示了凸函数的核心性质:一旦找到局部最小点,就已经找到了全局最小点。
什么时候可以放心使用这个判断
看到“目标函数凸”还不够,判断一个优化问题是否属于凸问题时,应同时检查目标函数与约束。无约束情况下,只需确认目标函数凸;带约束时,还要保证等式约束是仿射的、不等式约束能形成凸可行域。
若这些条件成立,就可以把“有没有坏局部极小值”的担忧从问题清单中划掉,把注意力放到算法选择、收敛速度和数值稳定性上。