
Python / 系统课时
事件循环一轮怎样调度任务
事件循环一轮怎样调度任务
事件循环看起来像是在“同时”运行很多协程,实际却是在单线程里反复处理已就绪回调、I/O 就绪事件和到期定时器。本节把一轮循环拆开,帮助你判断任务为什么现在运行、为什么要等到下一轮。
学习目标
- 区分就绪回调、I/O 事件和定时器在事件循环中的角色。
- 按一轮循环的顺序解释“等待、入队、执行”发生在哪里。
- 用可运行示例识别新加入回调为什么通常要等到下一轮。
一轮里有哪些待处理工作
事件循环并不是扫描所有协程并逐个询问“你能不能运行”。协程只有在被包装为 Task 并进入可恢复状态后,才会通过回调机制参与调度。理解一轮循环时,可以先关注三类来源。
就绪队列保存现在就能执行的回调,例如 call_soon() 注册的回调、刚创建任务的首次推进,以及某个 Future 完成后安排的任务恢复动作。
定时器队列保存尚未到期的 call_later()、call_at() 等回调。它们到达截止时间后才会被移入可执行范围,因此“定时器到期”不等于“立刻抢占当前代码”。
I/O 事件由底层事件通知机制发现,例如监听 Socket 变为可读。事件循环把对应处理回调加入就绪队列,后续仍按普通回调方式执行。
典型的一轮调度顺序
以 CPython 的默认 asyncio 事件循环实现作为心智模型,一轮通常可以理解为以下过程。这个顺序适合解释行为,但不应把私有实现细节当成跨版本 API 契约。
- 清理无效的定时器,并检查当前是否已经有就绪回调。
- 计算 I/O 轮询最多可以等待多久;已有就绪任务时通常不会长时间阻塞。
- 向操作系统查询已经就绪的 I/O 事件,并把对应回调加入就绪队列。
- 把达到触发时间的定时器加入就绪队列。
- 截取这一轮准备执行的就绪回调数量,按队列顺序逐个运行。
- 回调执行期间新安排的
call_soon()回调进入队列,但不会插到这一轮已经截取的批次前面。
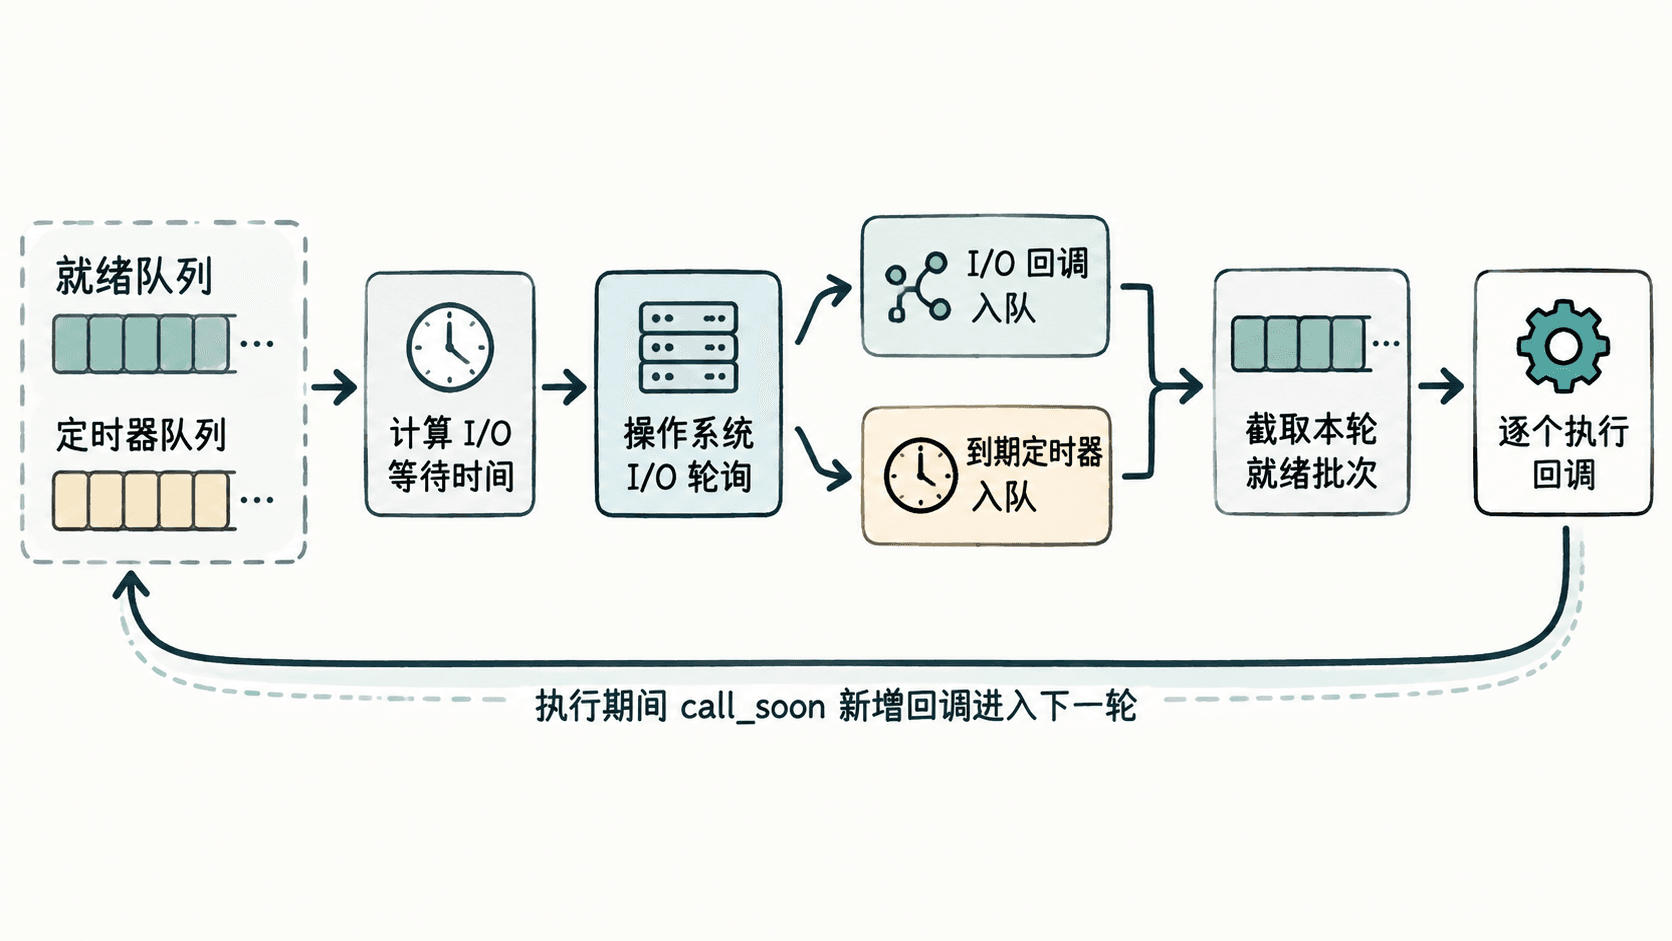
这也解释了为什么事件循环能兼顾 I/O 与大量连接:等待 I/O 时线程可以休眠,而事件就绪后只运行少量 Python 回调。反过来,如果某个回调执行很久,事件循环就没有机会进入下一轮,其他连接、定时器和任务都会一起延迟。
用代码观察批次边界
下面的程序把两个回调先放入就绪队列,其中 first() 在运行时再安排 second()。Event 只用于让主协程等待这组回调执行完成。
import asyncio

async def main():
    loop = asyncio.get_running_loop()
    done = asyncio.Event()

    def second():
        print("ready:second")
        done.set()

    def first():
        print("ready:first")
        # 当前回调执行时新增的回调进入后续调度批次。
        loop.call_soon(second)

    loop.call_soon(first)
    loop.call_soon(lambda: print("ready:peer"))

    print("task:yield")
    # 主协程暂停,让事件循环开始处理已经就绪的回调。
    await done.wait()
    print("task:resume")

asyncio.run(main())
预期输出
task:yield
ready:first
ready:peer
ready:second
task:resume
first() 虽然先安排了 second(),但 ready:peer 已经属于当前待执行批次,所以先完成。second() 设置事件后,主协程的恢复动作又被安排进就绪队列,因此最后才打印 task:resume。这类顺序用于理解调度边界,不应被当成业务代码依赖的隐式优先级。
三个容易误判的点
await 不等于“每次都切到下一轮”。如果被等待对象已经完成,协程可能继续向下执行;只有真正挂起时,控制权才交回事件循环。需要主动让出执行权时,await asyncio.sleep(0) 是常见做法,但它也不应该用来修补错误的并发设计。
定时器也没有抢占能力。即使 call_later() 的截止时间已经到达,只要当前回调还没有返回,它就不能中断正在运行的 Python 代码。因此 CPU 密集循环、同步文件 I/O 或阻塞式网络调用都会拖慢整个事件循环。
最后,事件循环调度的是“已就绪的工作”,不是按协程数量平均分配时间片。设计异步程序时,真正要保证的是每次回到 Python 的处理足够短,并在需要等待外部结果时及时挂起。