
Python / 系统课时
CPU 高但请求没变快怎么办
CPU 高但请求没变快怎么办
异步服务把并发调高后,如果 CPU 已经很高但吞吐不再增长,继续增加协程通常只会让排队更严重。排查时要把一次请求拆成 CPU 计算、序列化、锁等待和 I/O 等待,确认时间到底花在哪里,再决定是优化代码、减少竞争还是扩展进程。
学习目标
- 能区分 CPU 计算、序列化、锁竞争与 I/O 等待造成的不同症状。
- 会用进程 CPU 时间和分段墙钟时间定位请求瓶颈。
- 能根据瓶颈类型选择进程池、缩短临界区或优化 I/O,而不是盲目增加协程数。
先确认高 CPU 和慢请求是否来自同一段代码
“CPU 高”是进程层面的现象,“请求慢”是单次请求的墙钟时间。两者只有结合起来才有诊断意义:如果请求总耗时几乎都对应进程 CPU 时间,问题多半在计算或序列化;如果请求很慢但进程 CPU 时间很少,则更像锁等待或 I/O 等待。
下面的完整示例故意放入四类耗时,并分别计时。实际服务可以把同样的计时点放到路由处理、编码响应、临界区和外部调用周围。
import asyncio
import json
import time

def cpu_work() -> int:
    total = 0
    # 纯 Python 循环会占用事件循环线程。
    for i in range(500_000):
        total += (i * i) % 97
    return total

async def hold_lock(lock: asyncio.Lock) -> None:
    async with lock:
        await asyncio.sleep(0.05)

async def handle_request() -> None:
    wall_start = time.perf_counter()
    cpu_start = time.process_time()

    start = time.perf_counter()
    result = cpu_work()
    cpu_ms = (time.perf_counter() - start) * 1000

    start = time.perf_counter()
    json.dumps({"result": result, "items": list(range(50_000))})
    serialize_ms = (time.perf_counter() - start) * 1000

    lock = asyncio.Lock()
    holder = asyncio.create_task(hold_lock(lock))
    await asyncio.sleep(0)  # 让 holder 先取得锁。
    start = time.perf_counter()
    await lock.acquire()
    lock_wait_ms = (time.perf_counter() - start) * 1000
    lock.release()
    await holder

    start = time.perf_counter()
    await asyncio.sleep(0.02)  # 模拟真正会让出事件循环的 I/O 等待。
    io_wait_ms = (time.perf_counter() - start) * 1000

    process_cpu_ms = (time.process_time() - cpu_start) * 1000
    total_ms = (time.perf_counter() - wall_start) * 1000

    print(f"cpu_ms={cpu_ms:.1f}")
    print(f"serialize_ms={serialize_ms:.1f}")
    print(f"lock_wait_ms={lock_wait_ms:.1f}")
    print(f"io_wait_ms={io_wait_ms:.1f}")
    print(f"process_cpu_ms={process_cpu_ms:.1f}")
    print(f"total_ms={total_ms:.1f}")

if __name__ == "__main__":
    asyncio.run(handle_request())
预期输出
cpu_ms=<TIME>
serialize_ms=<TIME>
lock_wait_ms=<TIME>
io_wait_ms=<TIME>
process_cpu_ms=<TIME>
total_ms=<TIME>
<TIME> 代表本机实际毫秒值。这个示例中,锁等待约受 50 ms 睡眠影响,I/O 等待约受 20 ms 睡眠影响;CPU 和序列化时间取决于机器。重点不是比较绝对数字,而是看哪一段在真实请求中占比最高。
用分段计时判断根因
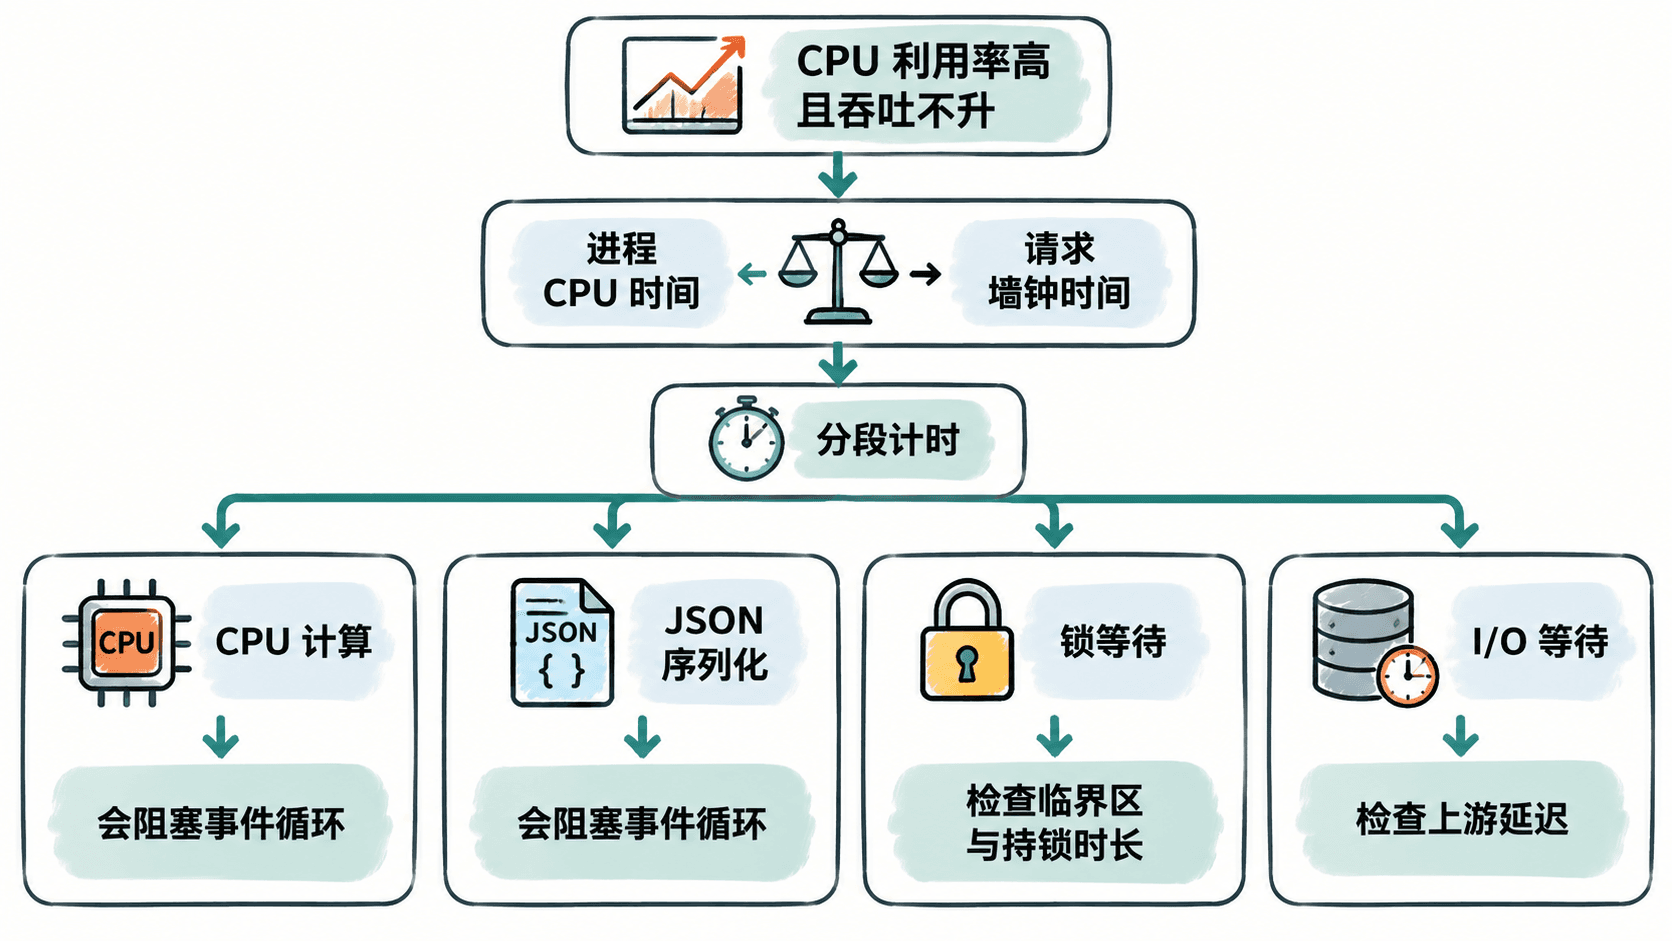
如果 process_cpu_ms 接近 total_ms,并且 cpu_ms 或 serialize_ms 占主要部分,说明单个事件循环线程正在做大量同步 CPU 工作。此时增加协程只会让更多任务排队,吞吐不会线性增长,尾延迟还可能变差。
如果 lock_wait_ms 很高而进程 CPU 时间并不高,重点检查 asyncio.Lock 的持锁范围。等待锁本身不会持续消耗 CPU;但如果临界区内部又做了 CPU 计算,就可能同时出现高 CPU 和高锁等待。
如果 io_wait_ms 很高而进程 CPU 时间较低,则应检查数据库、缓存、DNS、上游 HTTP 服务以及连接池。异步 I/O 的价值在于等待期间可以服务其他请求,因此这类问题通常不应通过“把代码放进进程池”解决。
对症处理而不是继续加并发
纯 Python CPU 计算受 GIL 影响,放进 asyncio.to_thread() 可以避免直接卡住事件循环,但通常不能提高纯 Python 计算吞吐;需要并行计算时更适合 ProcessPoolExecutor 或独立计算服务。序列化瓶颈则应先减少返回数据量、避免重复编码,并测量替换序列化方案是否真的降低 CPU。
锁竞争要先缩短临界区,避免在持锁期间执行不必要的 await、序列化或计算;如果锁保护的是可分片状态,可以按 key 拆锁,降低所有请求争用同一把锁的概率。
I/O 等待应检查超时、连接池大小、上游延迟和重试放大。只有当 CPU、序列化、锁等待和 I/O 都分别量化后,才值得调整 worker 数或并发上限;否则“再加协程”只是在改变排队位置。