
Python / 系统课时
连接数暴涨怎样定位
连接数暴涨怎样定位
连接数突然上升时,先别把“连接多”直接等同于“连接泄漏”。真正需要区分的是:连接处于什么 Socket 状态、连接池是否复用、失败请求是否在重试,以及应用并发是否突破了预期上限。把这几类证据对齐,才能判断连接究竟卡在哪里。
学习目标
- 用 Socket 状态分布区分建立中、已建立、等待回收和异常未关闭的连接
- 结合连接池与重试指标识别连接泄漏和重试风暴
- 建立从操作系统到应用层的连接数排查顺序
先看连接状态,不先看总数
总连接数只能说明“有很多 Socket”,不能说明原因。Linux 上常见的几个状态含义不同:ESTAB 高表示大量连接仍在使用或保持;TIME-WAIT 高通常说明短连接创建频繁;CLOSE-WAIT 持续累积往往意味着对端已经关闭,而本地应用没有及时关闭 Socket;SYN-SENT 大量出现则要怀疑对端不可达、网络异常或连接建立超时。
先执行下面的命令统计 TCP 状态分布:
LC_ALL=C ss -tanH | awk '{print $1}' | sort | uniq -c | sort -nr预期输出
<N> ESTAB
<N> TIME-WAIT
<N> CLOSE-WAIT
<N> SYN-SENT
<N> 是当前主机上的动态连接数量,实际状态种类和顺序可能不同。排查时重点看某一状态是否持续单向增长,而不是某次采样值是否“看起来很大”。
把 Socket、连接池和重试放到一张图里
连接暴涨通常不是单点问题。请求先占用应用并发槽位,再从连接池借连接或新建 Socket,失败后还可能进入重试。如果重试没有退避,短时间内会同时推高任务数、建连速率和 Socket 数量。
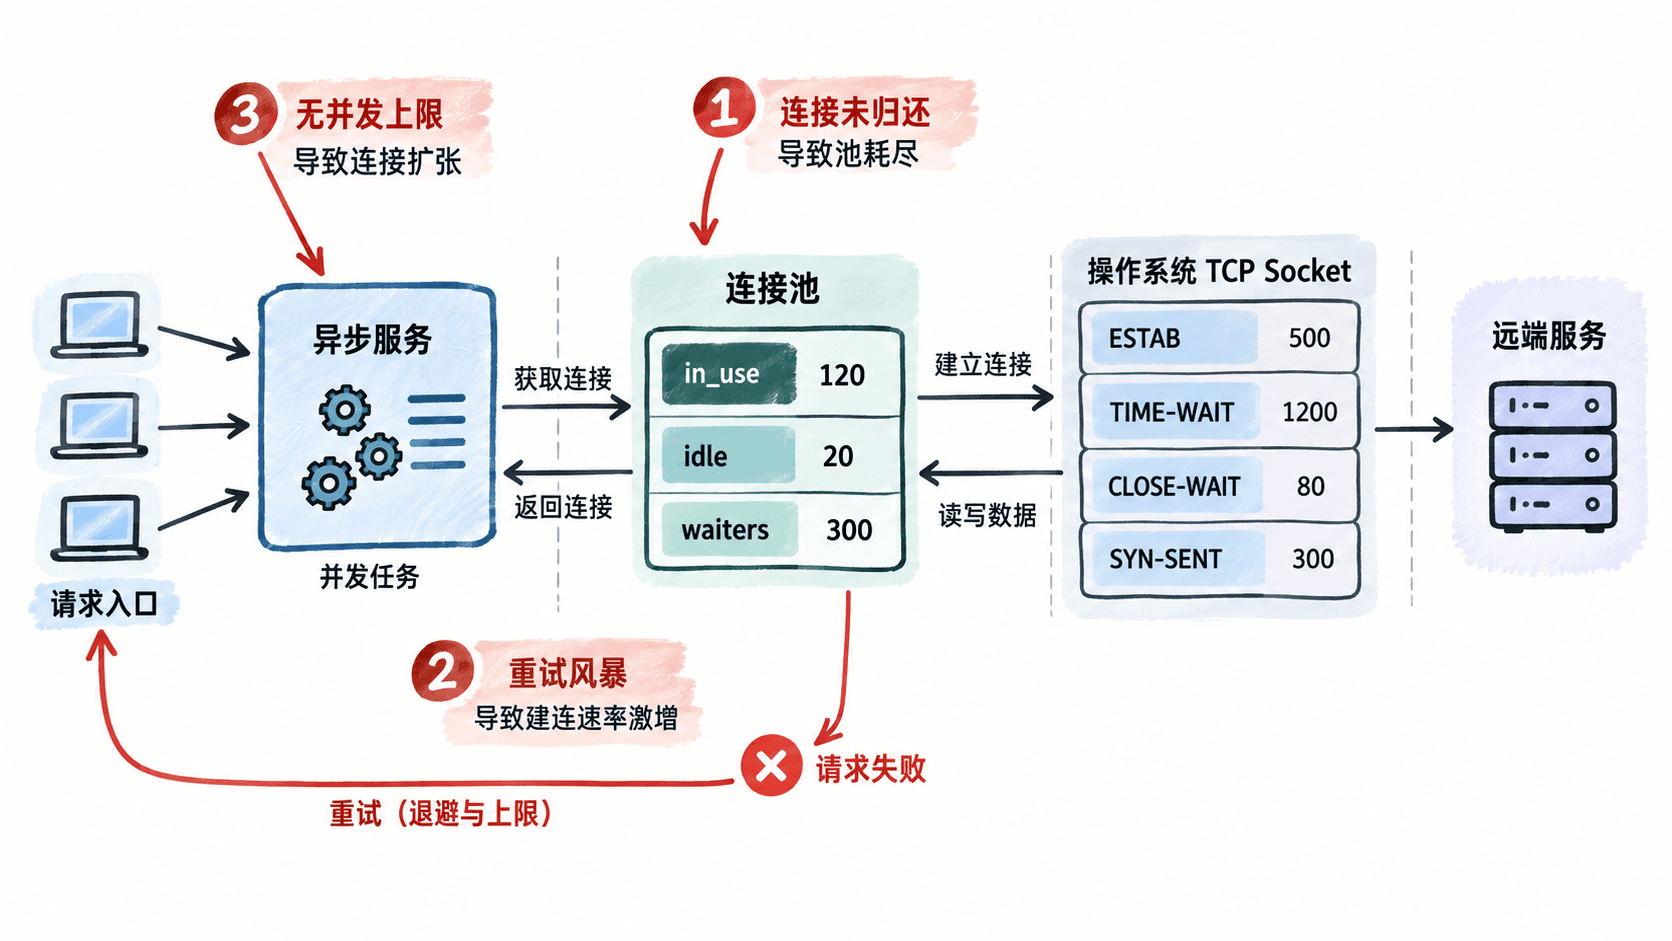
因此,应用层至少要同时观察连接池的已占用连接数、空闲连接数、等待者数量、获取连接耗时,以及请求重试次数。只有 ESTAB 高而池内连接数稳定,可能只是正常长连接;如果池的 in_use 长期贴着上限且 waiters 增长,则更像连接未释放或下游长期占用。
用状态组合判断三类典型问题
连接泄漏最常见的证据不是“总连接数高”,而是连接生命周期无法闭合。例如 CLOSE-WAIT 持续增长,或连接池借出数量只升不降,都说明应用侧可能漏掉了关闭、归还或异常路径清理。
重试风暴通常表现为错误率升高后,连接建立速率随之飙升,SYN-SENT、TIME-WAIT 或短时 ESTAB 同步增加。此时如果没有指数退避、最大重试次数和随机抖动,失败请求会制造更多新请求,最终把下游和本机端口资源一起拖垮。
并发失控则常见于“每个请求都新建连接”或没有全局并发限制。应用任务数和 ESTAB 一起上涨,但单个请求逻辑并没有泄漏;根因是系统允许同时存在的工作量超过了连接池或下游承载能力。
| 证据组合 | 更可能的原因 | 修复方向 |
|---|---|---|
CLOSE-WAIT 持续增长 |
本地未正确关闭连接 | 检查异常路径和上下文管理 |
TIME-WAIT 很高且建连频繁 |
短连接过多 | 启用连接复用并检查 keep-alive |
SYN-SENT 增长且超时变多 |
对端或网络异常 | 降低重试压力并检查网络路径 |
池 in_use 满、waiters 增长 |
下游慢或连接未归还 | 查借还逻辑和下游耗时 |
任务数与 ESTAB 同时上涨 |
应用并发失控 | 增加并发上限与背压 |
修复后要验证连接生命周期
修复连接问题时,优先确保每个连接都在成功、超时、取消和异常路径上被正确释放。然后再检查连接池上限、请求并发上限、超时、重试次数与退避策略是否协调;这些限制如果彼此独立设置,很容易形成“任务上限 1000、连接池只有 50、重试又无上限”的新积压。
验证时连续观察多个采样周期:连接池等待者应回落,CLOSE-WAIT 或 SYN-SENT 不再单向增长,错误恢复后建连速率也应下降。只有操作系统状态和应用连接池同时恢复稳定,才能确认不是把问题从一层转移到了另一层。