
Python / 系统课时
同步库为什么会卡住事件循环
同步库为什么会卡住事件循环
异步程序里最难发现的卡顿,常常不是少写了 await,而是在事件循环线程中直接调用了同步网络库、慢磁盘操作或耗时计算。理解阻塞发生在哪个线程,才能决定是换异步库、放入线程,还是交给独立进程。
学习目标
- 识别同步 I/O 占住事件循环时的典型表现
- 使用
asyncio.to_thread()隔离阻塞型同步调用 - 区分异步原生库、线程池与进程池各自适合的场景
卡住的本质
一个 asyncio 事件循环通常由单个线程驱动。协程只有在执行到可让出控制权的 await 时,其他任务才有机会继续。如果协程直接调用 requests.get()、同步 open().read(),或任何需要较长时间才返回的普通函数,这段时间事件循环无法切换到别的协程。
因此,“函数写在 async def 里”并不会自动变成异步。真正重要的是调用链中的耗时操作是否会把事件循环线程占住。
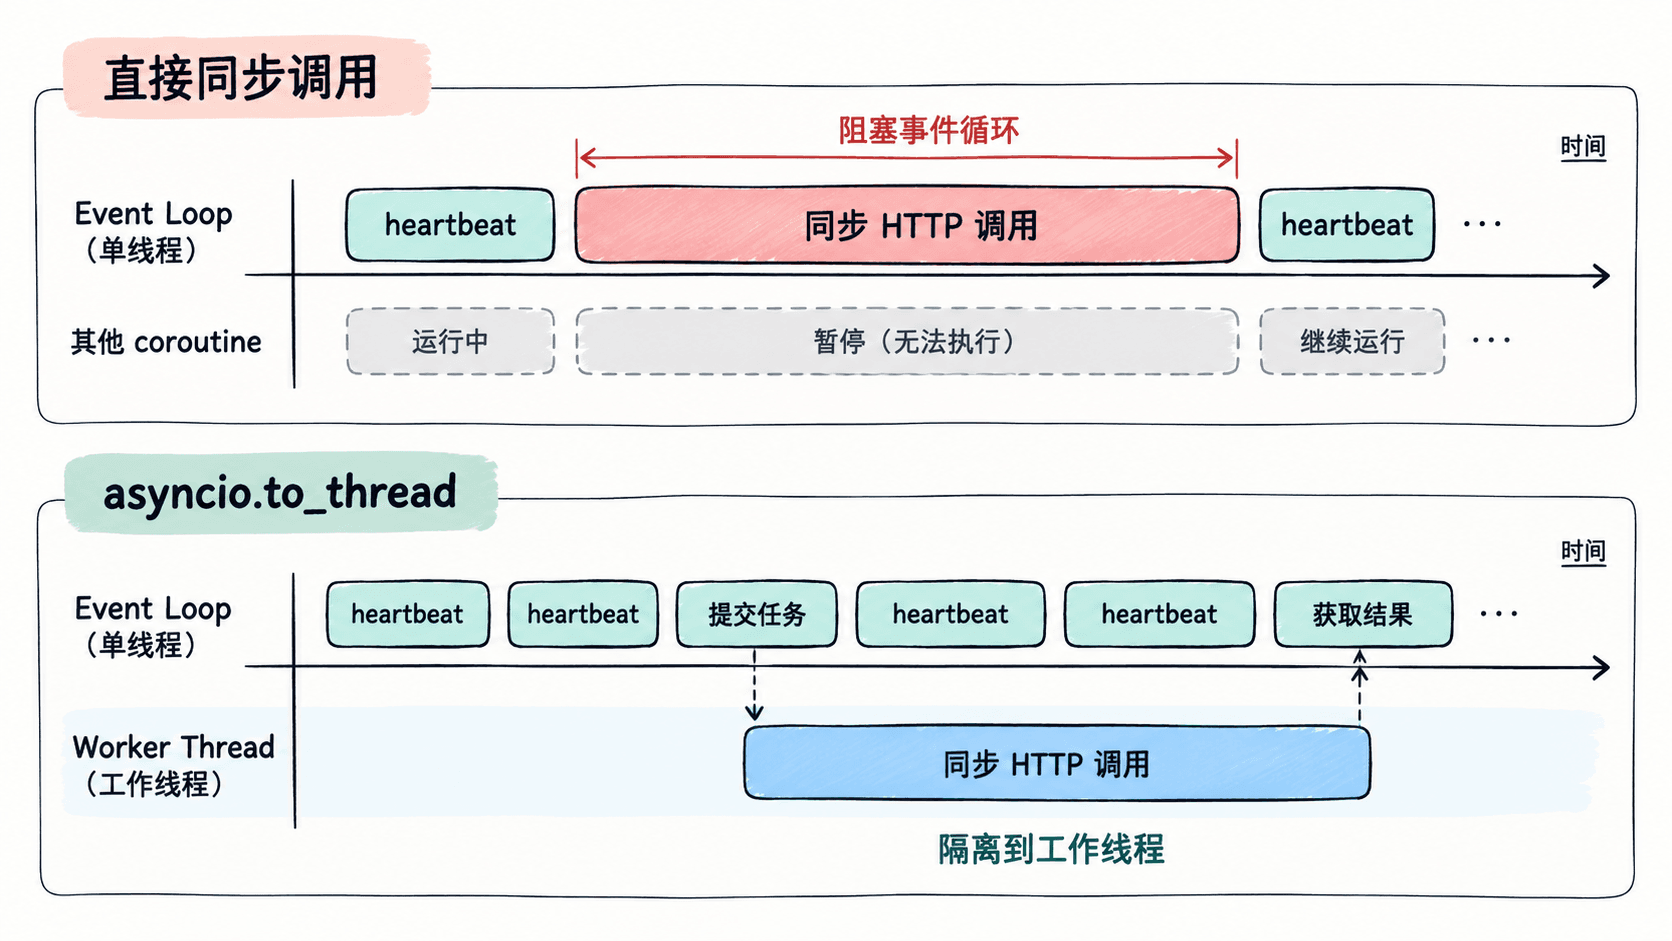
用最小实验观察卡顿
下面只使用标准库创建一个本地慢 HTTP 服务。客户端的 urllib.request.urlopen() 是同步调用,它和 requests.get() 一样会等待网络结果;示例先直接在协程中调用它,再用 asyncio.to_thread() 隔离同一个函数,从心跳输出顺序观察差异。
import asyncio
import threading
import time
import urllib.request
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

class SlowHandler(BaseHTTPRequestHandler):
    def do_GET(self) -> None:
        time.sleep(0.8)
        body = b"ok"
        self.send_response(200)
        self.send_header("Content-Length", str(len(body)))
        self.end_headers()
        self.wfile.write(body)

    def log_message(self, format: str, *args: object) -> None:
        # 关闭默认访问日志,避免干扰实验输出。
        pass

def sync_fetch(url: str) -> str:
    with urllib.request.urlopen(url, timeout=2) as response:
        return response.read().decode()

async def heartbeat(label: str) -> None:
    for index in range(4):
        print(f"{label} heartbeat {index}")
        await asyncio.sleep(0.2)

async def direct_case(url: str) -> None:
    pulse = asyncio.create_task(heartbeat("direct"))
    await asyncio.sleep(0)
    body = sync_fetch(url)  # 直接占住事件循环线程约 0.8 秒。
    print(f"direct body={body}")
    await pulse

async def thread_case(url: str) -> None:
    pulse = asyncio.create_task(heartbeat("thread"))
    fetch = asyncio.create_task(asyncio.to_thread(sync_fetch, url))
    await asyncio.gather(pulse, fetch)
    print(f"thread body={fetch.result()}")

async def main(url: str) -> None:
    await direct_case(url)
    await thread_case(url)

server = ThreadingHTTPServer(("127.0.0.1", 0), SlowHandler)
thread = threading.Thread(target=server.serve_forever, daemon=True)
thread.start()

try:
    port = server.server_address[1]
    asyncio.run(main(f"http://127.0.0.1:{port}/"))
finally:
    server.shutdown()
    server.server_close()
预期输出
direct heartbeat 0
direct body=ok
direct heartbeat 1
direct heartbeat 2
direct heartbeat 3
thread heartbeat 0
thread heartbeat 1
thread heartbeat 2
thread heartbeat 3
thread body=ok
不同机器的线程调度可能让最后两行出现轻微先后差异,但关键现象不会变:直接同步请求期间心跳停止,而放入工作线程后,事件循环仍能继续调度心跳任务。
隔离同步调用的选择
如果第三方服务同时提供成熟的异步客户端,优先使用异步原生 API,因为它通常能更自然地处理连接池、超时和取消。现有代码暂时只能使用同步库时,I/O 型调用可用 asyncio.to_thread() 包装,例如 await asyncio.to_thread(requests.get, url, timeout=5)。
to_thread() 解决的是“不要堵住事件循环”,并不会让底层同步函数获得真正的异步取消能力。协程被取消后,已经在线程中运行的阻塞函数通常还会继续执行到返回。因此外部 HTTP 请求仍要设置库自身的连接和读取超时。
对于纯 Python 的重 CPU 计算,线程虽然能让事件循环更容易保持响应,但仍可能受到 GIL 竞争影响;这类任务更适合 ProcessPoolExecutor 或独立工作进程。需要自定义线程池大小、复用专用执行器时,再考虑 loop.run_in_executor()。
不能只看有没有 await
排查“异步服务偶发卡死”时,应沿请求路径寻找同步边界,而不是只搜索 await。常见风险包括同步 HTTP SDK、数据库驱动、DNS 或证书处理中的阻塞步骤、慢文件系统、压缩解压,以及在协程中一次执行过久的 CPU 循环。
一个实用判断是:如果某个普通函数可能花几十毫秒到数秒才返回,而且它运行在事件循环线程中,就需要确认它是否会阻塞。高并发网络服务里,优先替换为异步实现;无法替换的 I/O 放线程池;重 CPU 工作放进程池。这样才能让“并发很多协程”真正转化为可用吞吐,而不是把大量协程排队堵在同一个线程后面。