
Python / 系统课时
怎么发现事件循环被阻塞
怎么发现事件循环被阻塞
异步服务出现延迟尖峰时,CPU 未必很高,连接数也可能正常,真正的问题可能是某段同步代码长时间占住事件循环线程。本节把 asyncio 调试告警与 event loop lag 指标结合起来,建立从发现异常到定位阻塞函数的排查路径。
学习目标
- 使用 asyncio 调试模式发现执行时间过长的 Task 或 callback。
- 用事件循环调度延迟衡量阻塞对整个服务的影响。
- 按证据定位
time.sleep、同步客户端和 CPU 密集代码等常见根因。
阻塞最先表现为调度延迟
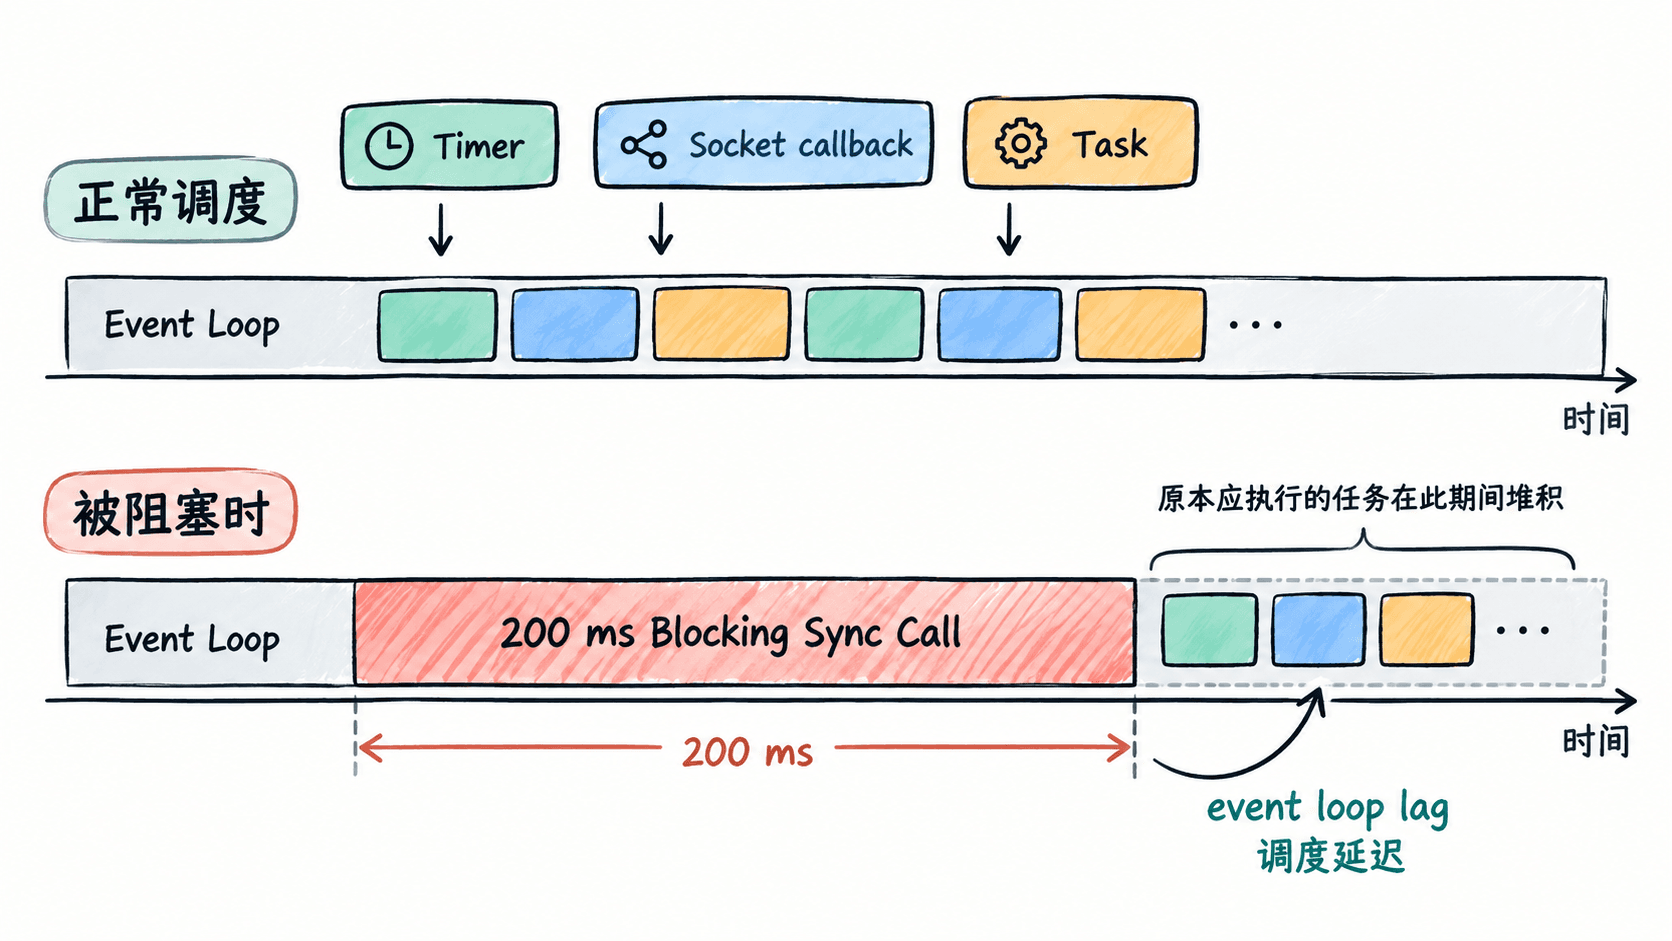
事件循环正常运行时,定时器、socket 回调和可继续执行的协程会频繁获得调度机会。如果某个同步调用占住线程 200 ms,那么原计划在这段时间执行的工作只能排队;业务上通常表现为一批请求同时变慢,而不是只有调用阻塞函数的那个请求变慢。
最实用的运行指标之一是 event loop lag:周期性安排一个很短的定时任务,再比较它实际恢复执行的时间与计划时间。延迟持续接近零通常说明循环能及时调度;突然出现几十或几百毫秒的峰值,则值得继续检查同一时间段的慢任务日志。
用调试模式制造并捕获一次阻塞
asyncio 的 debug 模式会额外检查慢 callback 和 Task 执行步骤。loop.slow_callback_duration 的单位是秒,可以在测试或预发布环境降低阈值,让几十毫秒级的异常更容易暴露。
下面的程序同时开启慢任务告警和一个简单的 loop lag 探针。blocking_handler 故意调用同步的 time.sleep,用于复现事件循环被占用的现象。
import asyncio
import logging
import time


logging.basicConfig(level=logging.WARNING)


async def lag_probe(interval: float = 0.05, rounds: int = 4) -> None:
    loop = asyncio.get_running_loop()
    expected = loop.time() + interval

    for _ in range(rounds):
        await asyncio.sleep(interval)
        now = loop.time()
        lag_ms = (now - expected) * 1000
        print(f"loop_lag_ms={lag_ms:.0f}")
        expected = now + interval


async def blocking_handler() -> None:
    # 故意阻塞事件循环,用来观察 debug 告警和调度延迟。
    time.sleep(0.20)
    await asyncio.sleep(0)


async def main() -> None:
    loop = asyncio.get_running_loop()
    loop.slow_callback_duration = 0.05

    probe = asyncio.create_task(lag_probe())
    await asyncio.sleep(0.06)
    await blocking_handler()
    await probe


if __name__ == "__main__":
    asyncio.run(main(), debug=True)
预期输出
loop_lag_ms=<N>
WARNING:asyncio:Executing <TASK_REPR> took 0.200 seconds
loop_lag_ms=<N>
loop_lag_ms=<N>
loop_lag_ms=<N><TASK_REPR>、实际耗时和 <N> 会随 Python 版本、操作系统和机器负载变化。这里要观察的是两条证据是否同时出现:asyncio 报告某个 Task 的一次执行步骤超过阈值,同时 loop lag 在相近时间明显抬高。
把告警和指标连成定位链路
单独看到请求延迟升高,还不能证明事件循环被阻塞;下列顺序更容易缩小范围:
- 先确认业务延迟尖峰是否与 event loop lag 同时出现。
- 在可控环境开启 asyncio debug,并把
slow_callback_duration调到符合服务延迟预算的阈值。 - 根据慢 Task 告警对应的代码路径,寻找没有
await的长计算或直接执行的同步函数。 - 修复后重复同一负载,确认慢任务告警消失,loop lag 与请求尾延迟同时下降。
不要依赖事件循环的 _ready、_scheduled 等私有字段做长期监控,这些并不是稳定的公共接口。生产指标更适合记录调度延迟、请求延迟、CPU 使用率以及线程池或进程池自身的容量和排队情况。
优先检查这些同步热点
最常见的阻塞来源包括 time.sleep、同步 HTTP 客户端、同步数据库驱动、慢文件系统访问、大对象序列化以及纯 Python 长循环。发现它们后,应先判断是否有原生异步 API;没有时,再把不可避免的阻塞 I/O 移到线程池,把明显的 CPU 密集工作移到进程池或独立计算服务。
真正可靠的判定不是“看到一条慢日志”,而是让业务延迟、事件循环调度延迟和具体代码位置形成同一条证据链。这样才能区分事件循环阻塞、外部服务变慢和单纯资源不足,避免把所有延迟问题都误判成 asyncio 本身性能差。