
Python / 系统课时
线上故障按什么顺序排查
线上故障按什么顺序排查
异步服务出现超时、吞吐骤降或连接堆积时,最怕一上来就盯某个协程。更可靠的方法是按客户端、事件循环、任务队列、连接池、操作系统资源逐层缩小范围,用同一时间窗口的证据判断故障到底卡在哪一层。
学习目标
- 建立固定的分层排查顺序,避免在错误层级反复调参。
- 能用延迟、队列、连接池和系统资源指标区分常见根因。
- 修复后用相同请求与指标验证问题是否真正消失。
先判断故障发生在哪一层
先确认现象是“请求进不来”“进来了但排队”“协程运行慢”“下游拿不到连接”,还是“进程被系统资源限制”。顺序从调用方一路向内,是因为外层证据最便宜,而且能避免把下游慢误判成事件循环慢。
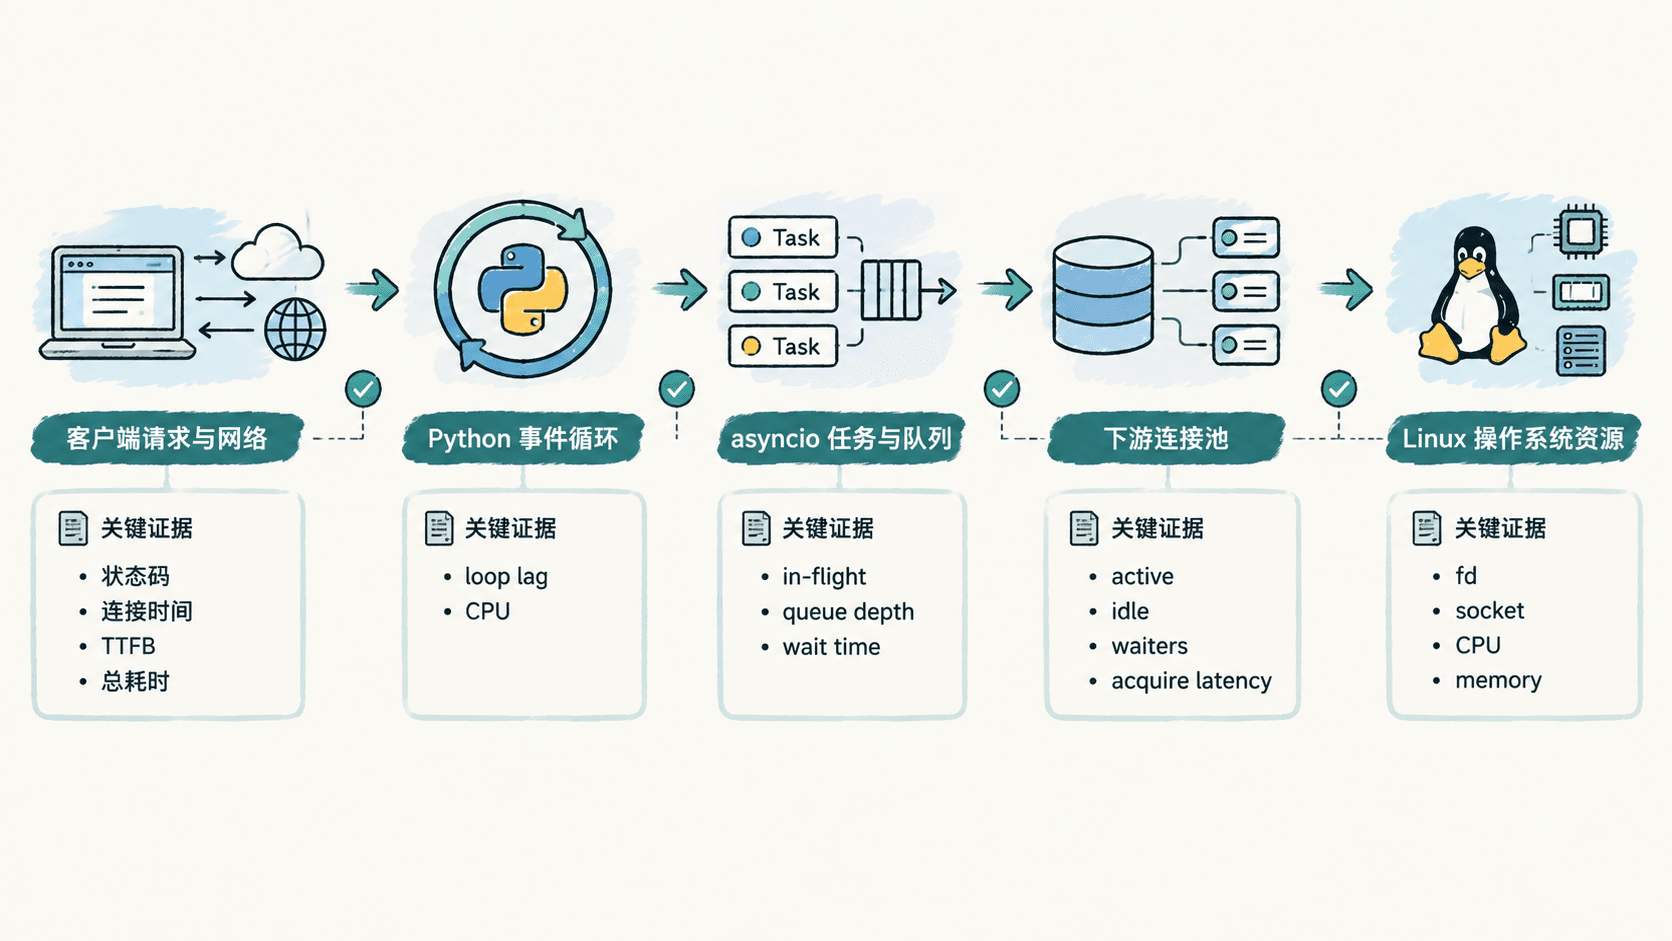
一个实用判定是:如果客户端连 TCP 都慢,先看网络和监听资源;连接快但首字节很慢,再看事件循环、排队和下游;服务内部指标正常而客户端仍慢,再回到代理、负载均衡和网络链路。
从客户端证据开始
先用同一台机器、同一个地址重复请求,记录状态码、建立连接时间、首字节时间和总耗时。下面脚本只依赖 curl,把最关键的四个值打印出来;把参数换成实际健康检查地址即可。
#!/usr/bin/env bash
set -euo pipefail
url="${1:-http://127.0.0.1:8000/health}"
curl -sS -o /dev/null --max-time 3 -w 'status=%{http_code} connect=%{time_connect}s ttfb=%{time_starttransfer}s total=%{time_total}s' "$url"
echo
预期输出(数值随环境变化):
status=<STATUS> connect=<TIME>s ttfb=<TIME>s total=<TIME>s如果 connect 已经高,应用代码通常还没开始处理请求;如果 connect 正常而 ttfb 明显升高,才值得继续看进程内部。不要只看平均值,至少对比正常时段与故障时段的高分位延迟。
看事件循环和任务是否堵住
事件循环层重点看 loop lag、进程 CPU 和长时间运行的同步代码。CPU 接近单核上限且 loop lag 同时升高,常见原因是 CPU 密集计算、同步文件或网络调用混进协程;CPU 不高但 loop lag 上升,则要继续排查阻塞调用、线程池耗尽或调度抖动。
任务层不要依赖 asyncio 私有字段,而是在业务侧暴露稳定指标,例如当前 in-flight 请求数、asyncio.Queue.qsize()、任务等待时长和超时数。队列深度持续上涨且处理速率没有同步提高,说明问题已经从“瞬时抖动”变成“生产速度长期高于消费速度”。
再查连接池与下游
当任务数量正常但请求仍卡住,检查数据库、HTTP 客户端或缓存连接池。最有价值的指标是 active、idle、waiters 和 acquire latency:大量 waiters 加上高获取延迟,说明协程不是没被调度,而是在等有限连接。
这时要同时看下游自身延迟和错误率。若下游变慢,盲目扩大连接池可能把压力继续放大;若连接泄漏导致 idle 长期为零,则应优先修复上下文管理和关闭路径,而不是继续提高并发上限。
最后检查操作系统资源
应用层证据都正常时,再看文件描述符、socket 状态、CPU、内存和端口资源。可用 ulimit -n 检查进程可用文件描述符上限,用 ss -s 看 socket 汇总,用 /proc/<PID>/fd 观察描述符数量是否持续增长。
典型对应关系很直接:文件描述符逼近上限会导致新连接失败;大量 TIME-WAIT 或连接数异常增长提示连接复用、关闭或流量模式有问题;系统内存紧张、频繁回收或 Swap 抖动则会把所有协程一起拖慢。
用同一组证据闭环修复
每次只改一个主要变量,然后复现相同流量,再对比客户端耗时、loop lag、队列等待、连接池等待和系统资源。只有症状消失且相关指标回到正常区间,才算完成根因验证。
分层排查的价值不是“每层都看一遍”,而是让每一步都回答一个明确问题:请求卡在进入服务之前、事件循环调度、任务排队、下游资源,还是操作系统限制。这样才能把线上排障从猜测变成可重复的证据链。