
Python / 系统课时
连接池为什么能降低延迟
连接池为什么能降低延迟
连接池的价值不只是“少建几个连接”,而是把昂贵的连接建立成本从每个请求里移出去,并给并发请求设置一个可控的入口。本节用本地服务观察连接复用,再把池大小、任务并发和下游容量放到同一条链路里分析。
学习目标
- 解释连接复用如何减少 TCP 与 TLS 建连开销。
- 区分协程并发数、连接池上限和下游可承载并发。
- 使用
aiohttp.TCPConnector验证连接池限制和复用效果。
连接复用省掉了什么
以 HTTP/1.1 为例,如果每个请求都新建连接,客户端至少要承担 TCP 建连;HTTPS 还要完成 TLS 握手。短请求本身只处理几十毫秒时,这些固定成本会显得尤其明显。
连接池会保留已经建立、仍可复用的连接。后续请求命中空闲连接后,可以直接发送 HTTP 请求,不必重新走完整建连路径。连接池因此既减少延迟,也减少频繁创建和销毁 socket 带来的系统开销。
并发数和连接数不是一回事
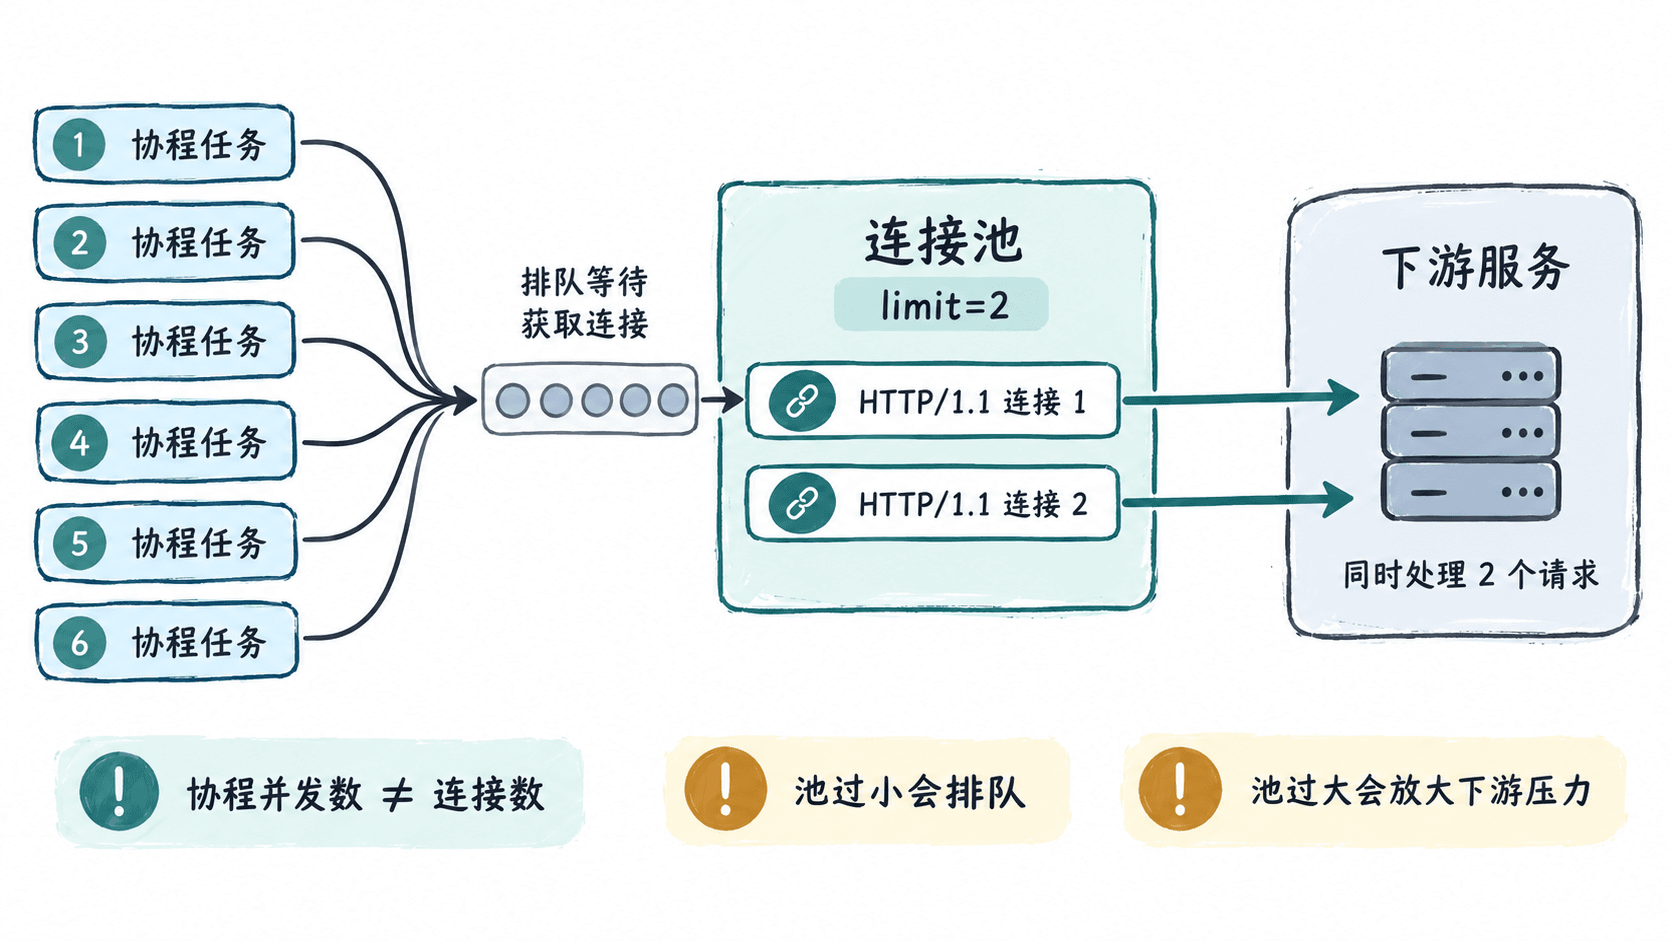
假设程序同时创建 100 个请求协程,并不代表会同时建立 100 条连接。以 aiohttp 的 HTTP/1.1 客户端为例,TCPConnector(limit=20) 会把总连接数限制在 20 左右,其余请求需要等待连接可用。
真正能同时压到下游的请求量,还受下游处理能力影响。应用自身并发很高、连接池也很大,但下游只能稳定处理少量并发时,扩大连接池只会把等待从本地队列转移到网络和下游,甚至引发超时、限流或连接耗尽。
用本地服务观察池上限
下面程序启动一个本地 aiohttp.web 服务,再同时发起 6 个请求。服务每次处理都暂停 0.1 秒,因此前两个请求会占住连接;客户端连接池上限设为 2,后续请求只能等待连接被复用。
import asyncio

from aiohttp import ClientSession, TCPConnector, web

seen_transports: set[int] = set()
active_requests = 0
max_active_requests = 0

async def handle(request: web.Request) -> web.Response:
    global active_requests, max_active_requests

    seen_transports.add(id(request.transport))
    active_requests += 1
    max_active_requests = max(max_active_requests, active_requests)

    await asyncio.sleep(0.1)

    active_requests -= 1
    return web.Response(text="ok")

async def main() -> None:
    app = web.Application()
    app.router.add_get("/", handle)

    runner = web.AppRunner(app)
    await runner.setup()
    site = web.TCPSite(runner, "127.0.0.1", 8080)
    await site.start()

    try:
        connector = TCPConnector(limit=2)

        async with ClientSession(connector=connector) as session:
            async def fetch() -> str:
                async with session.get("http://127.0.0.1:8080/") as response:
                    return await response.text()

            results = await asyncio.gather(*(fetch() for _ in range(6)))

        print(f"responses={results}")
        print(f"unique_connections={len(seen_transports)}")
        print(f"max_server_concurrency={max_active_requests}")
    finally:
        await runner.cleanup()

if __name__ == "__main__":
    asyncio.run(main())
预期输出
responses=['ok', 'ok', 'ok', 'ok', 'ok', 'ok']
unique_connections=2
max_server_concurrency=2
这里的端口固定为 8080;如果本机端口已被占用,应换成其他未占用端口。示例的重点不是某个延迟数字,而是 6 个协程只通过 2 条连接轮流完成请求。
池大小应该由谁决定
连接池上限通常从下游容量反推,而不是从本机能创建多少协程开始。先确认单个下游实例可接受的并发,再考虑你的服务实例数、每个实例的池大小,以及同一进程中是否还有其他调用方共享下游。
池太小会让大量请求在客户端等待空闲连接;池太大则可能把突发并发直接压给下游。实际调优时应同时观察连接等待时间、请求总延迟、下游错误率和资源使用率,而不是只看吞吐。
limit 也不是每秒请求数限制器。连接归还后可以立刻服务下一次请求,因此一个只有 20 条连接的池,每秒完全可能处理远多于 20 个短请求。需要控制 QPS 时,应使用限流器或令牌桶等独立机制。
复用失效时先查什么
最常见的问题是“每个请求都创建一个 ClientSession”,这样每次都会拥有新的连接池,复用自然失效。另一个问题是响应体没有被完整消费或响应没有正确关闭,导致连接不能及时回到池中。
如果延迟突然升高,应先区分是在等待连接、建立新连接,还是下游本身变慢。连接池真正解决的是连接复用与并发边界问题;它不能替代下游容量规划,也不会自动修复慢接口。