
Python / 系统课时
用并发压测找出瓶颈
用并发压测找出瓶颈
并发压测不是把连接数调到最大,而是用可重复的负载逐步逼近系统边界,再把吞吐、延迟、错误率和资源使用放到同一时间线上判断。本节实现一个 asyncio 压测客户端,并用分阶段实验区分服务处理慢、并发上限和客户端自身过载。
学习目标
- 用固定并发度生成持续 TCP 请求,并记录成功数、错误数和请求延迟
- 根据吞吐、P50/P95、错误率与 CPU、内存、网络占用判断瓶颈位置
- 通过递增并发和控制变量设计可复现的压测场景
先定义压测观察点
一次有效压测至少要同时回答四个问题:单位时间完成了多少请求、典型请求多快、尾部请求有多慢、失败是否开始增加。只看 RPS 会掩盖排队问题,只看平均延迟又会把少量慢请求冲淡,因此示例同时输出 RPS、P50、P95、错误数和错误率。
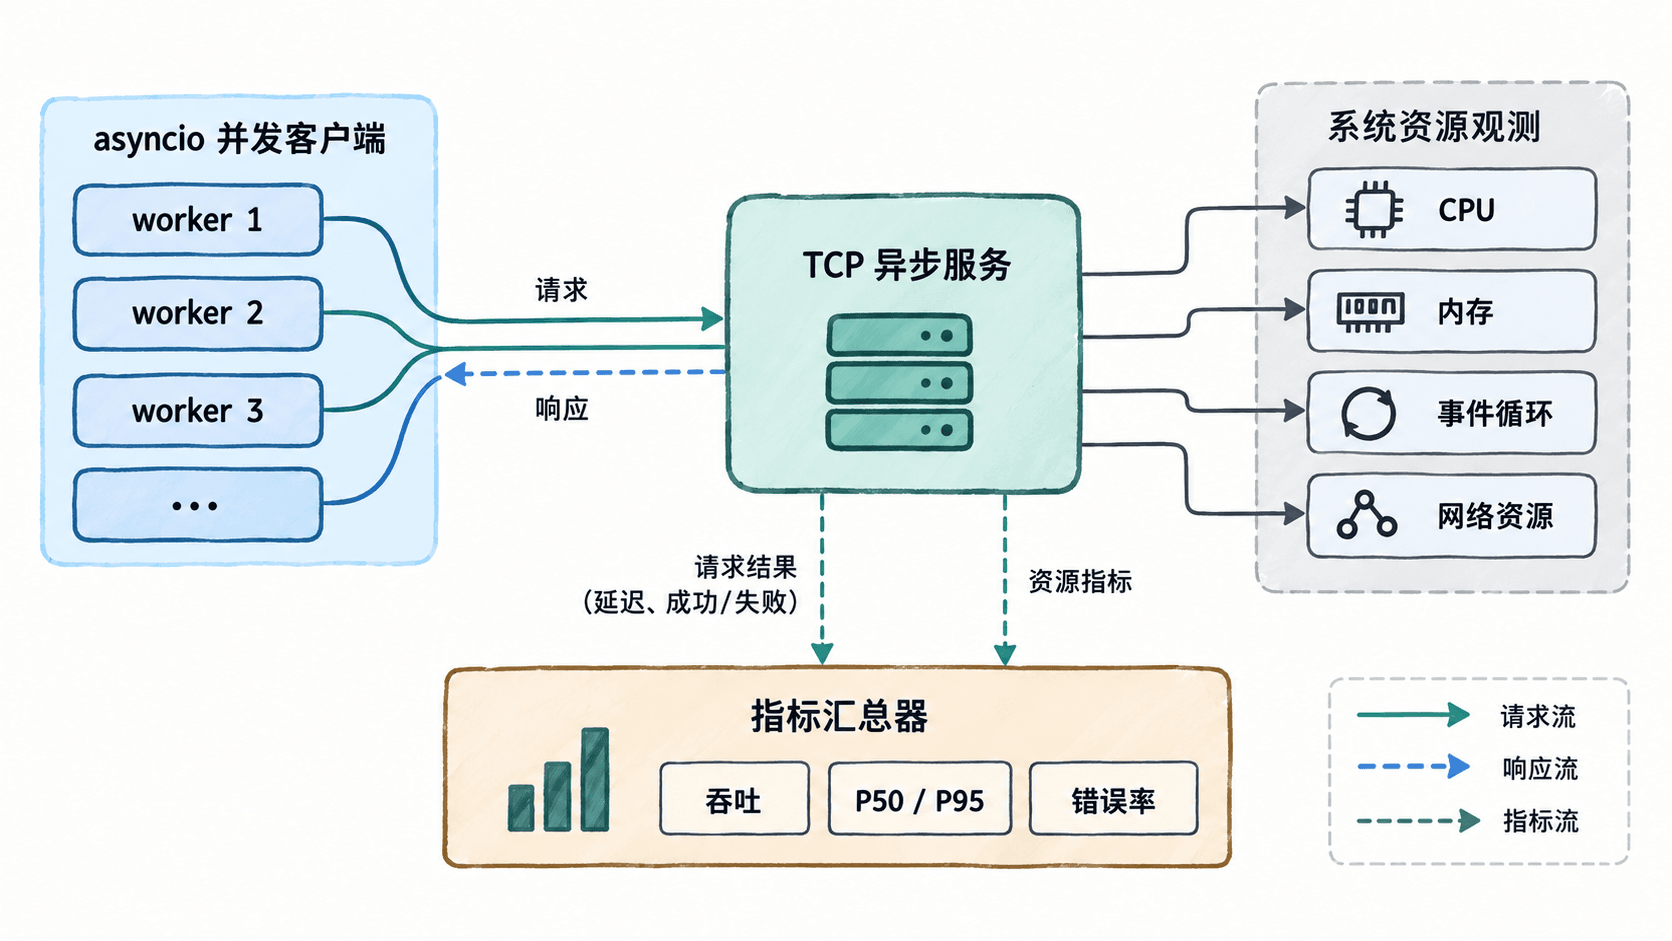
为了让实验可独立运行,下面脚本同时提供测试服务和压测模式。服务收到一行数据就返回 OK,并可人为增加处理延迟;压测模式让每个 worker 维持一个长连接,持续发送请求直到测试时间结束。
实现可重复的并发压测
将以下代码保存为 load_lab.py。先在一个终端运行 python load_lab.py server --port 9000 --delay-ms 0,再在另一个终端运行 python load_lab.py load --port 9000 --concurrency 100 --seconds 5。示例协议很小,但压测方法同样适用于你自己的 TCP 服务。
import argparse
import asyncio
import time

async def handle_client(
    reader: asyncio.StreamReader,
    writer: asyncio.StreamWriter,
    delay_ms: float,
) -> None:
    try:
        while True:
            line = await reader.readline()
            if not line:
                return

            if delay_ms > 0:
                await asyncio.sleep(delay_ms / 1000)

            writer.write(b"OK\n")
            await writer.drain()
    finally:
        writer.close()
        try:
            await writer.wait_closed()
        except ConnectionError:
            pass

async def run_server(args: argparse.Namespace) -> None:
    tasks = set()

    def on_client(reader: asyncio.StreamReader, writer: asyncio.StreamWriter) -> None:
        task = asyncio.create_task(handle_client(reader, writer, args.delay_ms))
        tasks.add(task)
        task.add_done_callback(tasks.discard)

    server = await asyncio.start_server(on_client, args.host, args.port)
    print(
        f"server listening on {args.host}:{args.port} "
        f"delay_ms={args.delay_ms}"
    )
    async with server:
        await server.serve_forever()

def percentile(values: list[float], ratio: float) -> float:
    ordered = sorted(values)
    if not ordered:
        return 0.0
    index = int((len(ordered) - 1) * ratio)
    return ordered[index] * 1000

async def run_load(args: argparse.Namespace) -> None:
    loop = asyncio.get_running_loop()
    deadline = loop.time() + args.seconds
    latencies = []
    ok = 0
    errors = 0

    async def worker() -> None:
        nonlocal ok, errors

        try:
            reader, writer = await asyncio.open_connection(args.host, args.port)
        except OSError:
            errors += 1
            return

        try:
            while loop.time() < deadline:
                started = time.perf_counter()
                try:
                    writer.write(b"ping\n")
                    await writer.drain()
                    response = await asyncio.wait_for(
                        reader.readline(),
                        timeout=args.timeout,
                    )
                except (TimeoutError, ConnectionError):
                    errors += 1
                    return

                if response != b"OK\n":
                    errors += 1
                    return

                latencies.append(time.perf_counter() - started)
                ok += 1
        finally:
            writer.close()
            await writer.wait_closed()

    started = time.perf_counter()
    await asyncio.gather(
        *(worker() for _ in range(args.concurrency))
    )
    elapsed = time.perf_counter() - started

    total = ok + errors
    error_rate = errors / total * 100 if total else 0.0
    print(
        f"completed={ok} "
        f"rps={ok / elapsed:.1f} "
        f"p50_ms={percentile(latencies, 0.50):.2f} "
        f"p95_ms={percentile(latencies, 0.95):.2f} "
        f"errors={errors} "
        f"error_rate={error_rate:.2f}%"
    )

def parse_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser()
    sub = parser.add_subparsers(dest="mode", required=True)

    server = sub.add_parser("server")
    server.add_argument("--host", default="127.0.0.1")
    server.add_argument("--port", type=int, default=9000)
    server.add_argument("--delay-ms", type=float, default=0.0)

    load = sub.add_parser("load")
    load.add_argument("--host", default="127.0.0.1")
    load.add_argument("--port", type=int, default=9000)
    load.add_argument("--concurrency", type=int, default=100)
    load.add_argument("--seconds", type=float, default=5.0)
    load.add_argument("--timeout", type=float, default=1.0)

    return parser.parse_args()

async def main() -> None:
    args = parse_args()
    if args.mode == "server":
        await run_server(args)
    else:
        await run_load(args)

if __name__ == "__main__":
    asyncio.run(main())
预期输出
server listening on 127.0.0.1:9000 delay_ms=0.0
completed=<COUNT> rps=<RPS> p50_ms=<MS> p95_ms=<MS> errors=<COUNT> error_rate=<PERCENT>%<COUNT>、<RPS>、<MS> 和 <PERCENT> 会随机器性能、并发度和调度情况变化。关键不是追求某个固定数字,而是保证同一环境、同一代码版本下的测试参数可复现。
用阶梯负载找拐点
不要一开始就用极高并发。更有效的方法是固定每轮测试时长,依次把并发度从 10、50、100 提升到 200 或更高,并记录每轮的 RPS、P95 和错误率。若 RPS 继续增长且 P95 基本稳定,说明系统还有余量;若 RPS 增长趋缓而 P95 快速上升,通常已经出现排队。
然后只改变一个变量。把服务的 --delay-ms 从 0 调到 20,可以人为制造服务端处理时间,观察吞吐上限如何下降;保持服务不变却不断提高压测客户端并发,如果客户端 CPU 已经接近饱和,那么测到的可能是压测机上限,而不是服务端上限。
| 现象 | 更可能的限制因素 | 下一步检查 |
|---|---|---|
| RPS 不再增长,P95 持续上升 | 服务端排队或下游变慢 | CPU、事件循环延迟、数据库或外部调用 |
| 错误率突然升高 | 连接数、文件描述符、超时或限流 | 服务日志、连接上限、超时配置 |
| 服务端资源很低,客户端 CPU 很高 | 压测端先到上限 | 降低单机并发或拆分多台压测机 |
| CPU 不高但网络接近带宽上限 | 网络吞吐成为瓶颈 | 网卡吞吐、包量、跨机链路 |
把资源使用和请求指标对齐
吞吐与延迟只能告诉你“变慢了”,资源指标才帮助判断“为什么”。压测期间应同时记录服务进程 CPU、内存、打开连接数和网络吞吐;Linux 可用 top、pidstat、ss 等工具,容器环境则可查看运行时或监控系统中的对应指标。
判断时要对齐时间窗口。例如某一轮并发从 100 提高到 200 后,P95 翻倍而 CPU 从 60% 升到接近 100%,CPU 饱和是强线索;如果 CPU 仍低但连接数卡在固定值,优先检查连接限制;如果所有本机指标都正常而请求延迟抬升,应继续看数据库、缓存或远程 API。
如何确认瓶颈已经被找到
真正的瓶颈应能通过控制变量被重复触发和缓解。比如把并发度提高时 P95 稳定恶化,而提升服务端 CPU 配额后同样负载下 P95 明显下降,这比“CPU 看起来很高”更有说服力。反过来,如果调整某项资源后吞吐和延迟几乎不变,就不应把它当作根因。
压测的目标不是制造一个最大的 RPS 数字,而是找到吞吐停止线性增长、尾延迟开始失控或错误率抬升的拐点,再用资源证据验证限制因素。这样得到的结论才可以指导容量规划和下一轮优化。