
Python / 系统课时
流式响应怎么边收边处理
流式响应怎么边收边处理
面对大文件下载、NDJSON、SSE 或持续输出接口,最危险的做法不是“慢”,而是先把整个响应读进内存。流式处理的关键是让网络数据按块进入程序,消费完当前块再继续读取,从而把峰值内存与响应总大小解耦。
学习目标
- 理解一次性读取与流式读取对内存占用的差异
- 使用异步迭代按块消费 HTTP 响应
- 根据数据边界、处理速度和内存预算选择分块策略
为什么要流式处理
如果调用 await response.read(),客户端会持续收取数据并把完整响应聚合成一个 bytes 对象。响应只有几 KB 时很方便,但下载数百 MB 文件或连接持续数小时的流式接口时,内存占用会随已接收数据增长。
流式读取则只把当前可处理的数据块交给业务逻辑。应用可以边计算、边解析、边写入下游,而不是等“全部到齐”才开始。aiohttp 的 response.content 是 StreamReader,可通过异步迭代与 iter_chunked() 逐块读取。
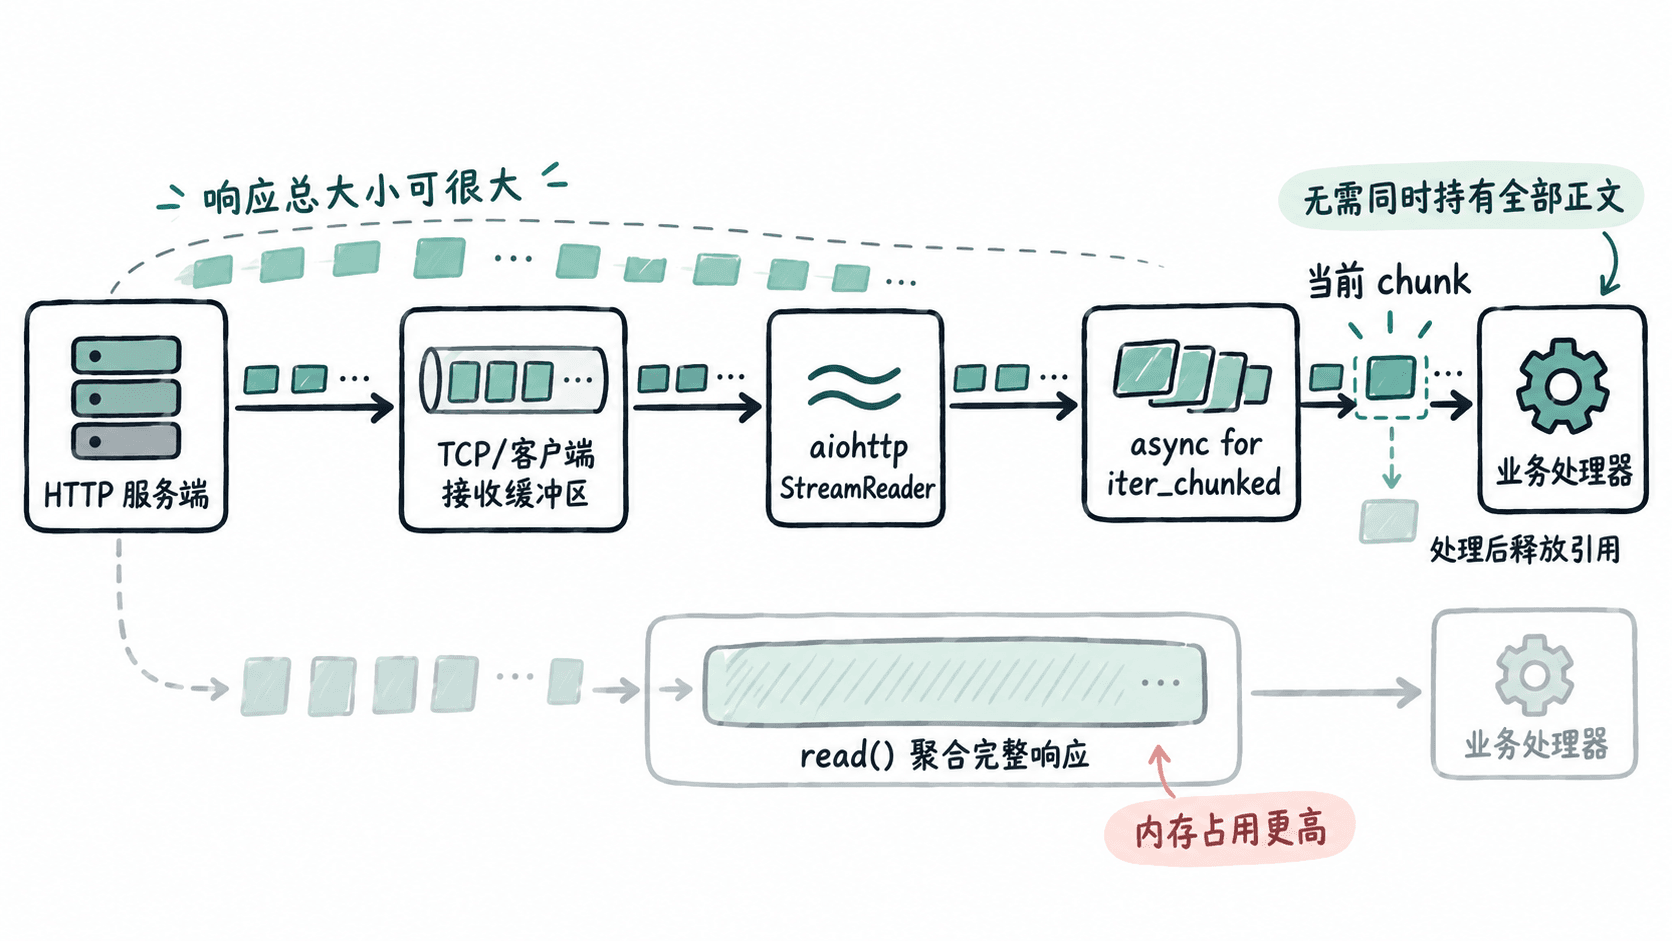
用异步迭代分块消费
下面的示例在本机启动一个 aiohttp HTTP 服务,服务端分五次写出数据;客户端使用 iter_chunked(8) 消费响应,并只累计字节数和观察到的最大块大小,不保存完整正文。运行前需要环境中已安装 aiohttp。
import asyncio

from aiohttp import ClientSession, web

async def stream_handler(request: web.Request) -> web.StreamResponse:
    response = web.StreamResponse(status=200)
    await response.prepare(request)

    # 每次写出 8 字节,模拟服务端持续产生数据。
    for index in range(5):
        await response.write(f"chunk-{index}\n".encode())
        await asyncio.sleep(0.05)

    await response.write_eof()
    return response

async def main() -> None:
    app = web.Application()
    app.router.add_get("/stream", stream_handler)

    runner = web.AppRunner(app)
    await runner.setup()
    site = web.TCPSite(runner, "127.0.0.1", 0)
    await site.start()

    # 0 表示让系统分配可用端口;实际端口从已绑定 socket 读取。
    port = runner.addresses[0][1]

    try:
        async with ClientSession() as session:
            async with session.get(f"http://127.0.0.1:{port}/stream") as response:
                total_bytes = 0
                peak_chunk = 0

                async for chunk in response.content.iter_chunked(8):
                    total_bytes += len(chunk)
                    peak_chunk = max(peak_chunk, len(chunk))
                    # 真实业务可在这里增量解析、计算摘要或写入下游。

                print(
                    f"status={response.status}, "
                    f"total_bytes={total_bytes}, "
                    f"peak_chunk<=8={peak_chunk <= 8}"
                )
    finally:
        await runner.cleanup()

asyncio.run(main())
预期输出
status=200, total_bytes=40, peak_chunk<=8=Trueiter_chunked(8) 保证每次交给应用的块不超过 8 字节,但不保证网络层恰好按服务端每次 write() 的边界交付。因此业务逻辑不能把“一次迭代”误认为“一条完整消息”;如果协议有行、JSON 对象或自定义帧边界,应继续做增量解析。
分块大小真正影响什么
块太大时,单次处理需要更多临时内存,也可能让 CPU 密集的解析阶段长时间占住事件循环;块太小时,Python 循环次数和函数调用开销会上升。常见做法是从几十 KB 量级开始,再根据吞吐、延迟和对象大小实测调整,而不是追求某个固定“最佳值”。
更重要的是消费速度。async for 循环里的处理如果会等待网络或其他异步资源,应正常 await,让事件循环调度其他任务;如果处理本身是很重的同步 CPU 计算,即使读取是异步的,也会把事件循环卡住。此时应把计算拆小或移到进程池,而不是盲目减小网络块。
什么时候选择哪种读取方式
响应体很小且必须一次性解析时,直接 read() 或 json() 最简单;大文件、对象存储下载、代理转发和长连接输出适合分块读取;按行产生的日志或 NDJSON 更适合按行消费。无论使用哪种方式,都要给请求设置合理超时,并在取消任务时让 async with 正常退出,以便连接归还连接池。
判断是否真正做到流式处理,可以看一个简单标准:业务处理一段时间后,进程内存应主要受“当前缓冲与当前处理对象”影响,而不是随着响应累计字节数持续线性增长。