
Python / 系统课时
Task 怎样让多个请求并发
Task 怎样让多个请求并发
网络请求大部分时间都在等待数据返回。若每个请求都立刻 await,后一个请求只能等前一个结束;把协程先包装成 Task,事件循环就能在等待 I/O 时切换到其他任务。本篇用可运行示例直观看出两种写法的耗时差异。
学习目标
- 区分“顺序等待协程”和“先创建 Task 再统一等待”
- 使用
asyncio.create_task()启动多个并发任务 - 判断 Task 并发适用的 I/O 场景与常见阻塞点
顺序 await 为什么仍然是串行
await 的含义是“暂停当前协程,直到这个 awaitable 完成”。如果循环里创建一个协程后马上 await 它,当前协程会等结果回来才进入下一次循环,因此三个网络等待会首尾相接。
真正的并发关键不是写了多少个 async def,而是是否让多个等待中的协程同时进入事件循环。asyncio.create_task(coro) 会把协程包装成 Task,并安排它尽快运行;当前协程继续向下执行,直到之后显式等待这些 Task。
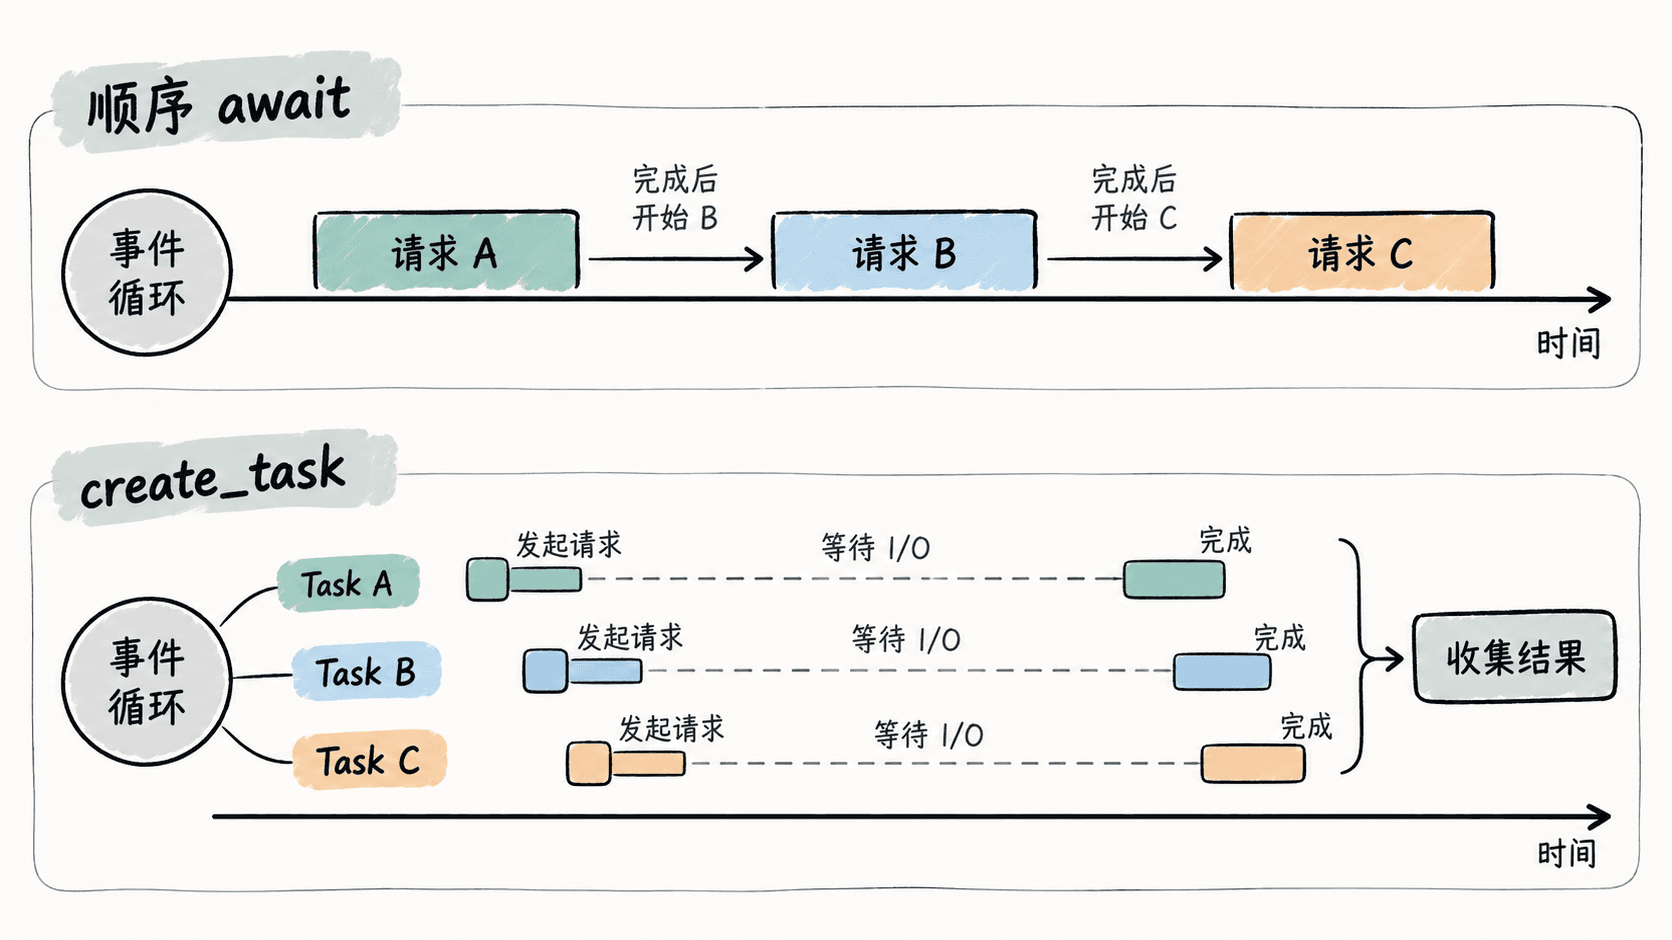
用 create_task 并发调度
下面同时实现顺序版本和 Task 版本。asyncio.sleep() 用来模拟网络等待,它会把控制权交还事件循环,因此很适合观察调度差异。
import asyncio
import time

async def request(name: str, delay: float) -> str:
    # 模拟等待网络响应;等待期间事件循环可以运行其他 Task。
    await asyncio.sleep(delay)
    return name

async def run_sequential() -> list[str]:
    results = []
    for name, delay in [("A", 0.30), ("B", 0.20), ("C", 0.10)]:
        results.append(await request(name, delay))
    return results

async def run_concurrent() -> list[str]:
    tasks = [
        asyncio.create_task(request("A", 0.30)),
        asyncio.create_task(request("B", 0.20)),
        asyncio.create_task(request("C", 0.10)),
    ]
    # gather 按传入顺序返回结果,即使任务实际完成顺序不同。
    return await asyncio.gather(*tasks)

async def main() -> None:
    start = time.perf_counter()
    sequential = await run_sequential()
    sequential_time = time.perf_counter() - start

    start = time.perf_counter()
    concurrent = await run_concurrent()
    concurrent_time = time.perf_counter() - start

    print("顺序结果:", sequential)
    print(f"顺序耗时: {sequential_time:.2f}s")
    print("并发结果:", concurrent)
    print(f"并发耗时: {concurrent_time:.2f}s")

if __name__ == "__main__":
    asyncio.run(main())
预期输出
顺序结果: ['A', 'B', 'C']
顺序耗时: <TIME>
并发结果: ['A', 'B', 'C']
并发耗时: <TIME>
<TIME> 会随机器和调度略有变化;在这个示例里,顺序版本通常接近三个延迟之和约 0.60 秒,并发版本接近最长单次延迟约 0.30 秒。gather() 返回值仍按 Task 的传入顺序排列,不代表完成顺序也是 A、B、C。
并发不等于无限创建 Task
Task 适合大量“等待时间明显高于 CPU 计算时间”的操作,例如 HTTP 请求、数据库访问、Socket 收发。若协程内部执行长时间 CPU 计算、同步文件操作或阻塞式网络库,事件循环仍会被卡住,创建更多 Task 也不会提升吞吐。
生产代码还应限制并发量。一次创建数万条请求可能压垮连接池、对端服务或本机文件描述符,可用 asyncio.Semaphore、连接池上限或工作队列控制同时在途的 Task 数量。核心原则是:先把独立 I/O 变成可并发 Task,再为并发规模设置边界。