
Python / 系统课时
为什么网络 I/O 会拖慢线程
为什么网络 I/O 会拖慢线程
网络服务真正消耗线程的往往不是计算,而是等待:连接建立、数据到达和对端响应都可能让一次系统调用停住。理解线程在阻塞 I/O 中“做了什么”和“没做什么”,才能看懂为什么并发连接一多,线程数量、上下文切换和内存占用会迅速上升。
学习目标
- 解释阻塞网络调用为什么会让线程停在等待状态
- 区分 CPU 计算时间与网络 I/O 等待时间
- 理解“一连接一线程”在高并发下的资源成本
阻塞发生在等待数据时
以 recv() 为例:当套接字中已经有数据,内核可以立即把数据复制给进程;当没有数据时,阻塞套接字上的 recv() 不会返回“暂时没有”,而是让当前线程进入等待,直到数据到达、连接关闭或调用被其他条件中断。
这段时间 CPU 并没有持续执行你的 Python 代码。线程只是保留着自己的栈、调度状态和关联资源,等待内核把它重新唤醒。因此,“线程被拖慢”更准确地说,是业务执行路径被 I/O 等待占住了。
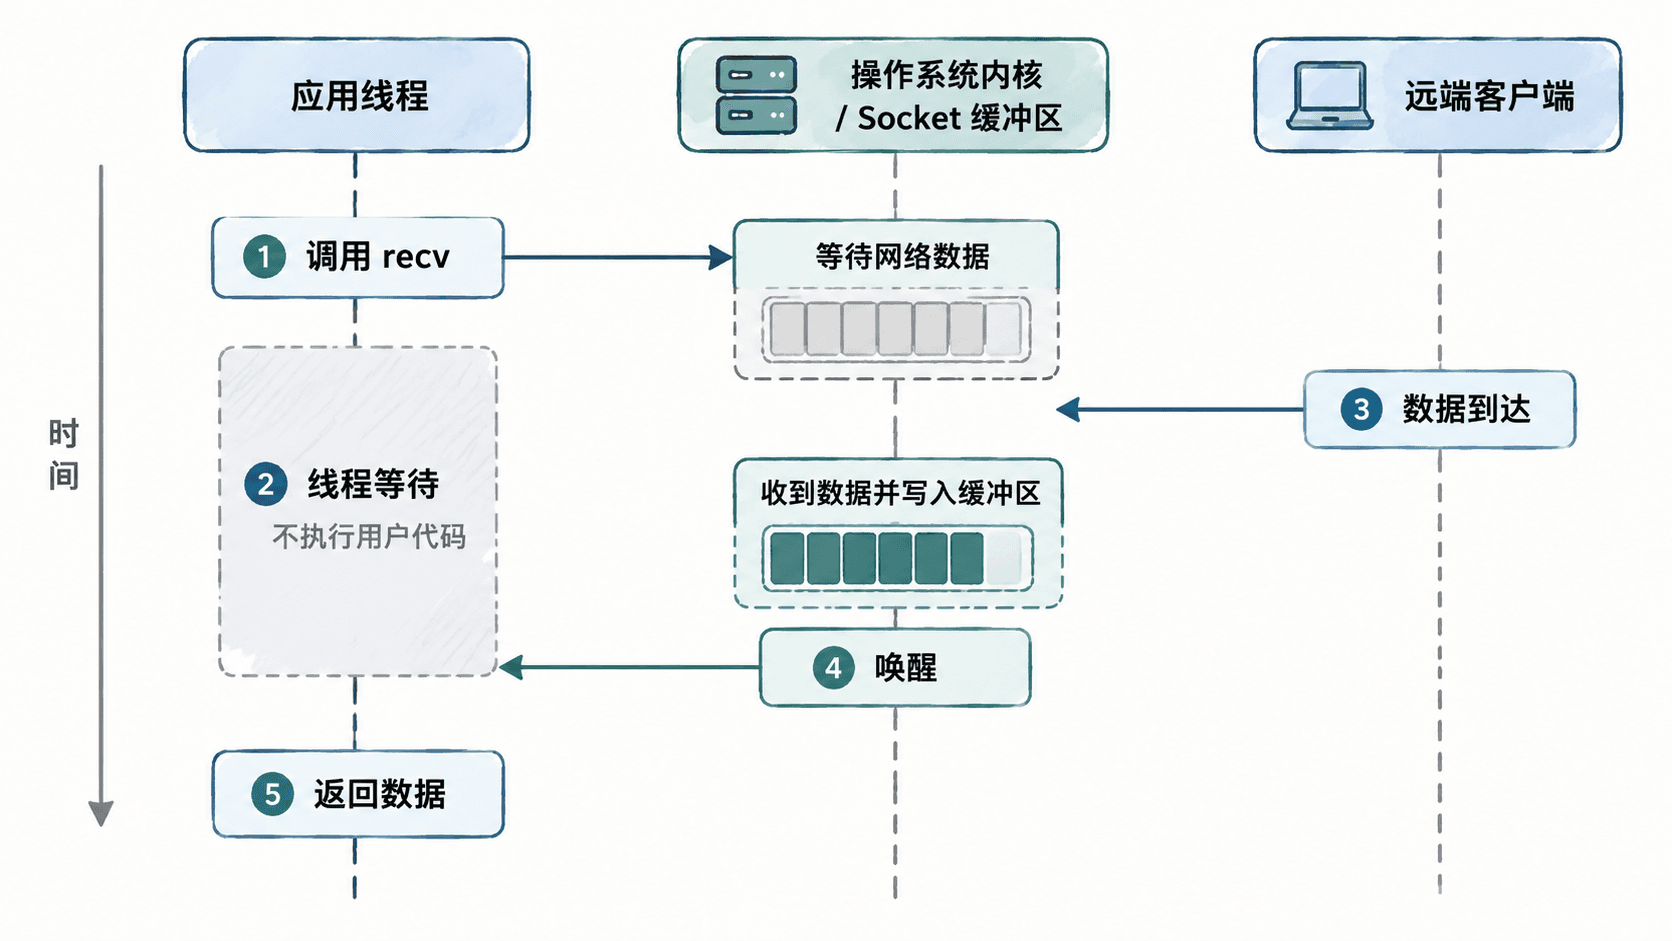
下面用 socket.socketpair() 在本机制造一对相连套接字,让读取端先执行阻塞 recv(),另一条线程延迟发送数据。
import socket
import threading
import time

left, right = socket.socketpair()

def delayed_send() -> None:
    time.sleep(1)
    right.sendall(b"hello")

sender = threading.Thread(target=delayed_send)
sender.start()

started = time.perf_counter()
data = left.recv(5)  # 此处会等待,直到另一端真正发送数据
elapsed = time.perf_counter() - started

print(data.decode())
print(f"waited={elapsed:.2f}s")

sender.join()
left.close()
right.close()
预期输出
hello
waited=<TIME>s
其中 <TIME> 通常接近 1 秒,实际值会受系统调度影响。关键不是精确时长,而是主线程在 recv() 返回前无法继续执行后面的 print()。
等待时间为什么会放大并发成本
假设一个请求只需要 2 毫秒 CPU 计算,却要等待 100 毫秒网络数据。如果每个连接都由独立线程同步处理,那么大量线程会同时处于等待状态。它们虽然不持续占用 CPU,却仍然需要线程栈、调度信息以及操作系统管理成本。
连接数量继续上升时,问题通常不是“CPU 算不过来”,而是线程数量先变得笨重:内存占用增加,调度器需要管理更多可运行或待唤醒线程,线程切换也会侵蚀吞吐量。
线程模型的瓶颈在哪里
“一连接一线程”的直觉是:某个连接在等,就让另一个线程去处理别的连接。这个办法确实能获得并发,但并发度逐渐接近几千、几万连接时,线程不再是便宜的抽象。
异步 I/O 的目标不是让网络变快,也不是消灭等待,而是让一个线程在某个连接等待时,把执行权交给其他任务。这样,少量线程可以承载大量“多数时间都在等”的网络连接。
判断是否值得使用异步模型时,先看负载是不是 I/O 等待占主导且连接数高。如果任务主要消耗 CPU,换成异步 I/O 并不会自动获得并行计算能力。