
Python / 系统课时
重试为什么可能放大故障
重试为什么可能放大故障
异步服务失败后立即重试,看似提高成功率,却可能在后端最脆弱时制造第二波甚至多波请求。要让重试真正帮助恢复,需要同时限制“重试什么、重试几次、隔多久再试”,并用抖动打散大量客户端的同步节奏。
学习目标
- 解释无条件重试如何形成连接洪峰、排队和超时的正反馈。
- 区分适合重试的瞬时故障与不应重试的确定性失败。
- 实现带最大次数、指数退避、延迟上限和抖动的异步重试。
重试会制造第二波流量
假设 1000 个请求同时因为依赖服务过载而超时。如果每个任务立即重试,后端刚释放一批资源就会收到新的 1000 个连接;若它们再次超时,又会形成下一轮重试。异步程序能同时挂起大量任务,因此这个放大过程往往比同步程序更快。
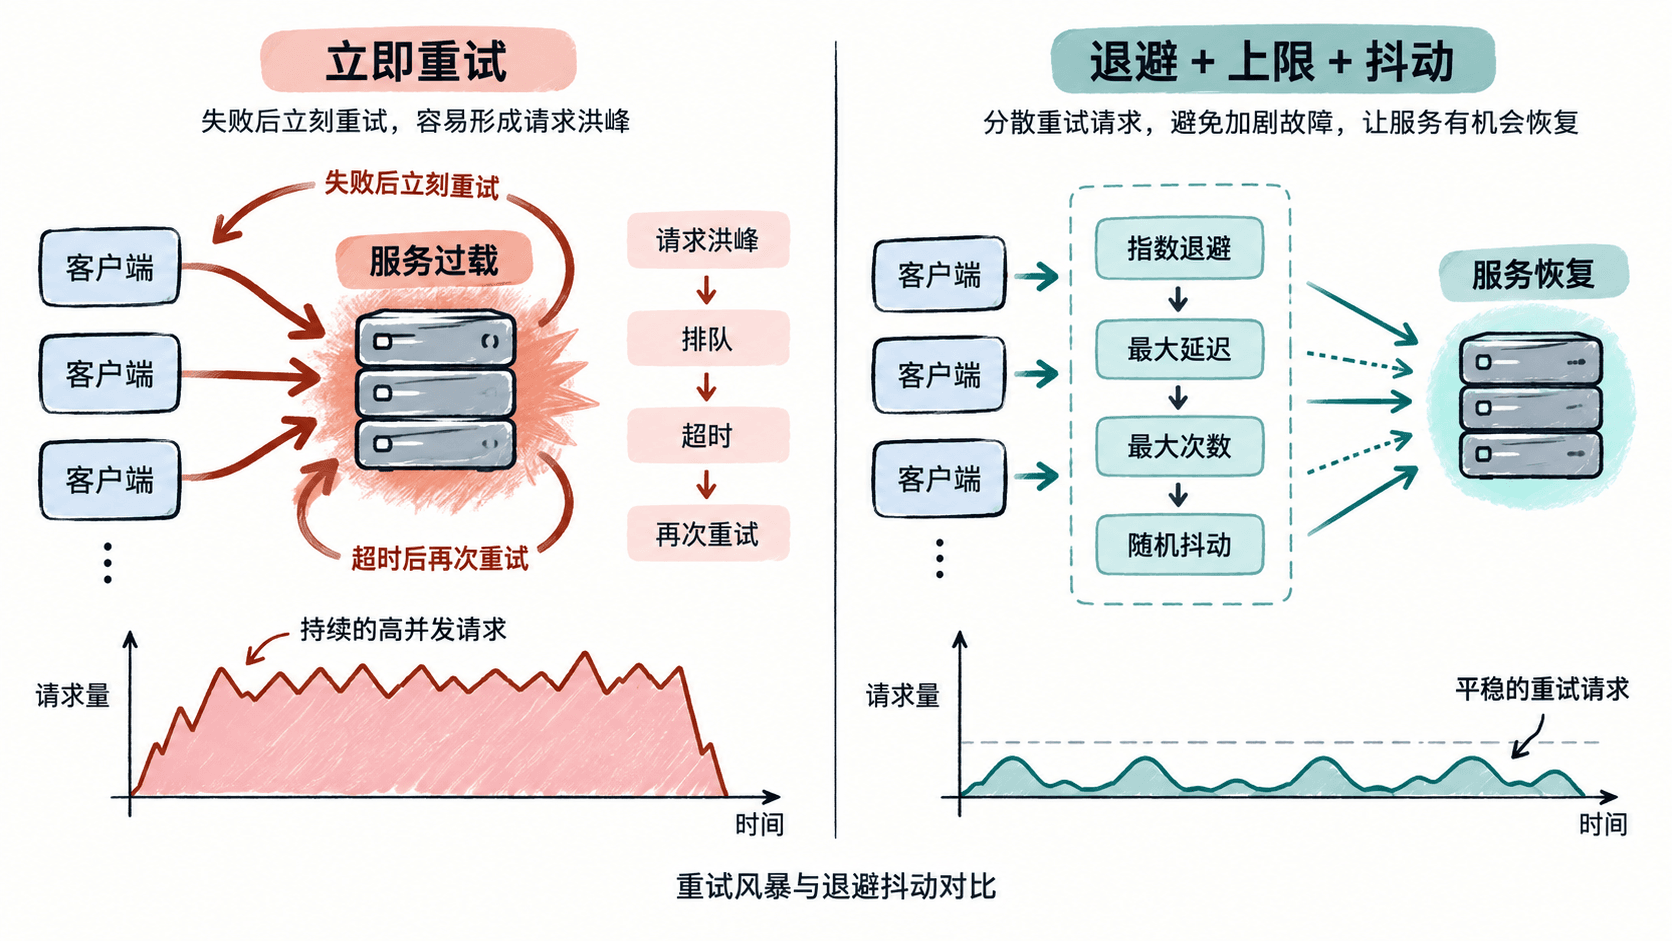
真正危险的不是“有重试”,而是所有任务在相同时间、以相同频率重试。这样会把一次短暂故障变成持续拥塞,并在客户端侧留下越来越多等待中的任务、连接和超时计时器。
先判断失败是否值得重试
重试只适合“再次尝试可能成功”的失败。例如连接暂时断开、服务端短暂不可用或读取超时,可以在业务允许时有限重试。参数错误、认证失败、协议解析失败等确定性问题,重复发送通常只会浪费资源。
网络写操作还要额外考虑幂等性:如果客户端没有收到响应,并不能证明服务端没有处理请求。对创建订单、扣款等操作直接重试,可能造成重复副作用;这类操作需要幂等键、请求去重或明确的服务端语义配合。
用退避、上限和抖动控制节奏
下面的示例只重试 ConnectionError。每次失败后按指数方式增加最大等待时间,并设置最大延迟;随后在 0 到当前上限之间随机选择实际等待时间。演示使用固定随机种子,只为让输出可重复,生产环境不要让所有客户端使用同一个固定种子。
import asyncio
import random
from collections.abc import Awaitable, Callable


async def retry(
    operation: Callable[[], Awaitable[str]],
    *,
    max_attempts: int = 4,
    base_delay: float = 0.1,
    max_delay: float = 0.25,
    rng: random.Random,
) -> str:
    for attempt in range(1, max_attempts + 1):
        try:
            return await operation()
        except ConnectionError:
            if attempt == max_attempts:
                raise

            # 指数退避先决定等待上限,再用抖动打散并发任务。
            cap = min(base_delay * (2 ** (attempt - 1)), max_delay)
            delay = rng.uniform(0.0, cap)
            print(f"attempt {attempt} failed; retry in {delay:.3f}s")
            await asyncio.sleep(delay)

    raise RuntimeError("unreachable")


async def main() -> None:
    state = {"calls": 0}

    async def flaky_call() -> str:
        state["calls"] += 1
        if state["calls"] < 4:
            raise ConnectionError("temporary outage")
        return "ok"

    result = await retry(flaky_call, rng=random.Random(7))
    print(f"result={result} calls={state['calls']}")


asyncio.run(main())
预期输出
attempt 1 failed; retry in 0.032s
attempt 2 failed; retry in 0.030s
attempt 3 failed; retry in 0.163s
result=ok calls=4这里有四道保护:max_attempts 控制总尝试次数,指数退避减少持续施压,max_delay 防止等待无限增长,随机抖动让不同任务错开重试时间。真实服务还应把总超时预算算进去,避免单次请求因为多轮重试占用过长时间。
给并发重试再加一道闸门
退避解决的是“什么时候再试”,但不能保证同时重试的任务数量足够小。高并发客户端通常还会在调用依赖服务前放置 asyncio.Semaphore 等并发限制,让重试流量也必须经过同一容量闸门,而不是每个失败任务都独立冲向后端。
用指标验证重试没有反噬
上线后至少同时观察原始请求量、重试请求量、超时率、并发连接数和端到端延迟。若依赖故障时重试量快速接近甚至超过原始请求量,而成功率没有同步改善,说明重试正在消耗恢复能力。
合理的异步重试不是“失败就再来一次”,而是一个受预算约束的流量控制机制:只重试可能恢复的错误,限制次数和并发,用退避与抖动错峰,并在达到上限后及时把失败返回给调用方。