
Python / 系统课时
Semaphore 怎么限制并发请求
Semaphore 怎么限制并发请求
当协程可以一次创建成百上千个请求时,真正危险的往往不是 Python 本身,而是数据库、HTTP 服务或其他下游先被压垮。本节用 asyncio.Semaphore 给高成本操作设置并发上限,并通过可运行示例验证限制确实生效。
学习目标
- 理解 Semaphore 如何用固定数量的许可控制同时进入临界区的协程数
- 使用
async with为下游调用设置并发上限,并验证最大并发数 - 区分并发限制、请求速率限制以及任务总量限制
为什么要限制同时执行的请求
asyncio 允许大量协程同时等待 I/O,但“能并发”不等于“下游能承受”。例如一次性启动 500 个数据库查询,即使本地事件循环很轻松,也可能耗尽数据库连接池或触发远程接口限流。
Semaphore 可以理解为一组数量固定的“通行证”。协程进入受保护区域前取得一个许可,离开时归还;许可全部被占用后,新的协程会异步等待,而不是阻塞整个事件循环。
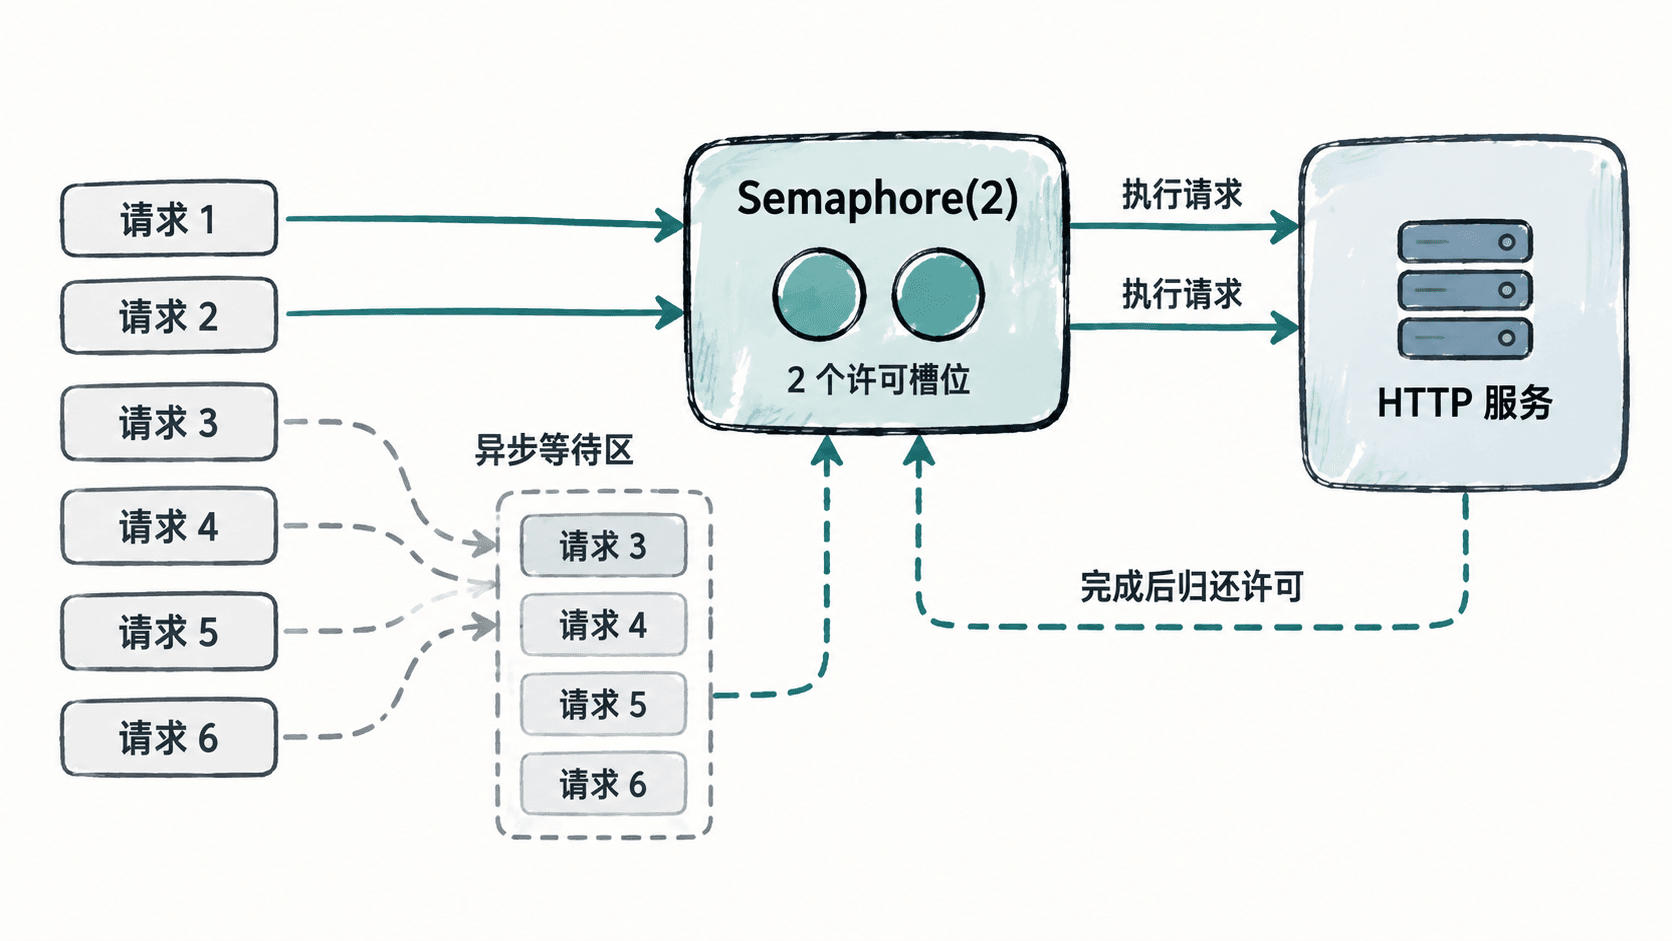
Semaphore 的工作方式
创建 asyncio.Semaphore(2) 表示最多允许两个协程同时持有许可。最安全的写法是 async with semaphore:进入代码块时自动执行获取许可,退出时自动释放,即使任务抛出异常,也不容易因为漏掉 release() 造成永久阻塞。
Semaphore 限制的是受保护代码段中的同时执行数量。如果先创建一百万个 Task,再让它们竞争一个 Semaphore,Task 本身仍然已经全部创建。因此,当任务来源无限或速度很快时,还需要配合有界 Queue 等机制控制待处理任务数量。
用代码验证最大并发数
下面创建 5 个模拟下游请求,但 Semaphore 只允许其中 2 个同时处于执行区。active 记录当前活动数,max_active 记录整个运行过程观察到的峰值。
import asyncio

active = 0
max_active = 0
counter_lock = asyncio.Lock()


async def call_downstream(name: str, semaphore: asyncio.Semaphore) -> str:
    global active, max_active

    async with semaphore:
        # 计数器只用于实验观测,不属于 Semaphore 的必要组成部分。
        async with counter_lock:
            active += 1
            max_active = max(max_active, active)

        await asyncio.sleep(0.05)

        async with counter_lock:
            active -= 1

        return f"{name}:ok"


async def main() -> None:
    semaphore = asyncio.Semaphore(2)
    tasks = [
        call_downstream(f"req-{i}", semaphore)
        for i in range(5)
    ]

    results = await asyncio.gather(*tasks)
    print(f"max_active={max_active}")
    print(f"completed={len(results)}")
    print(f"all_ok={all(item.endswith(':ok') for item in results)}")


asyncio.run(main())
预期输出
max_active=2
completed=5
all_ok=True
输出中的 max_active=2 直接证明:即使 5 个协程都已提交,受保护区域内同时运行的协程也没有超过两个。
并发限制不等于速率限制
Semaphore 回答的是“同一时刻最多允许多少个操作进行”。如果每个请求只耗时 1 毫秒,即使并发上限为 10,一秒仍可能完成大量请求。因此它不能替代“每秒最多 100 次”这类基于时间窗口的速率限制。
选择并发值时,应根据真正稀缺的资源确定,例如 HTTP 连接池容量、数据库最大连接数或 CPU 密集步骤可接受的并行度。通常先采用保守值,再结合延迟、错误率和下游负载逐步调整,而不是把数字简单设得越大越好。