
Python / 系统课时
任务积压时先看什么
任务积压时先看什么
异步服务出现延迟升高时,最先要回答的不是“并发够不够”,而是请求究竟堵在入口、内部队列、任务执行还是下游等待。把任务数量、队列长度、单次处理耗时和下游响应时间放在同一时间窗口观察,通常能很快定位积压层级。
学习目标
- 用任务数、队列长度和耗时指标判断积压发生在哪一层
- 区分“消费者处理慢”和“下游响应慢”这两类常见瓶颈
- 建立一套先观测、再限流或扩容的排查顺序
先把积压拆成四个观测面
任务积压通常是“进入速度长期大于离开速度”的结果,但只看总请求量无法知道瓶颈位置。建议在同一采样周期内至少记录四类指标:事件循环中的活跃任务数、业务队列长度、消费者处理耗时,以及访问数据库或 HTTP 服务的下游耗时。
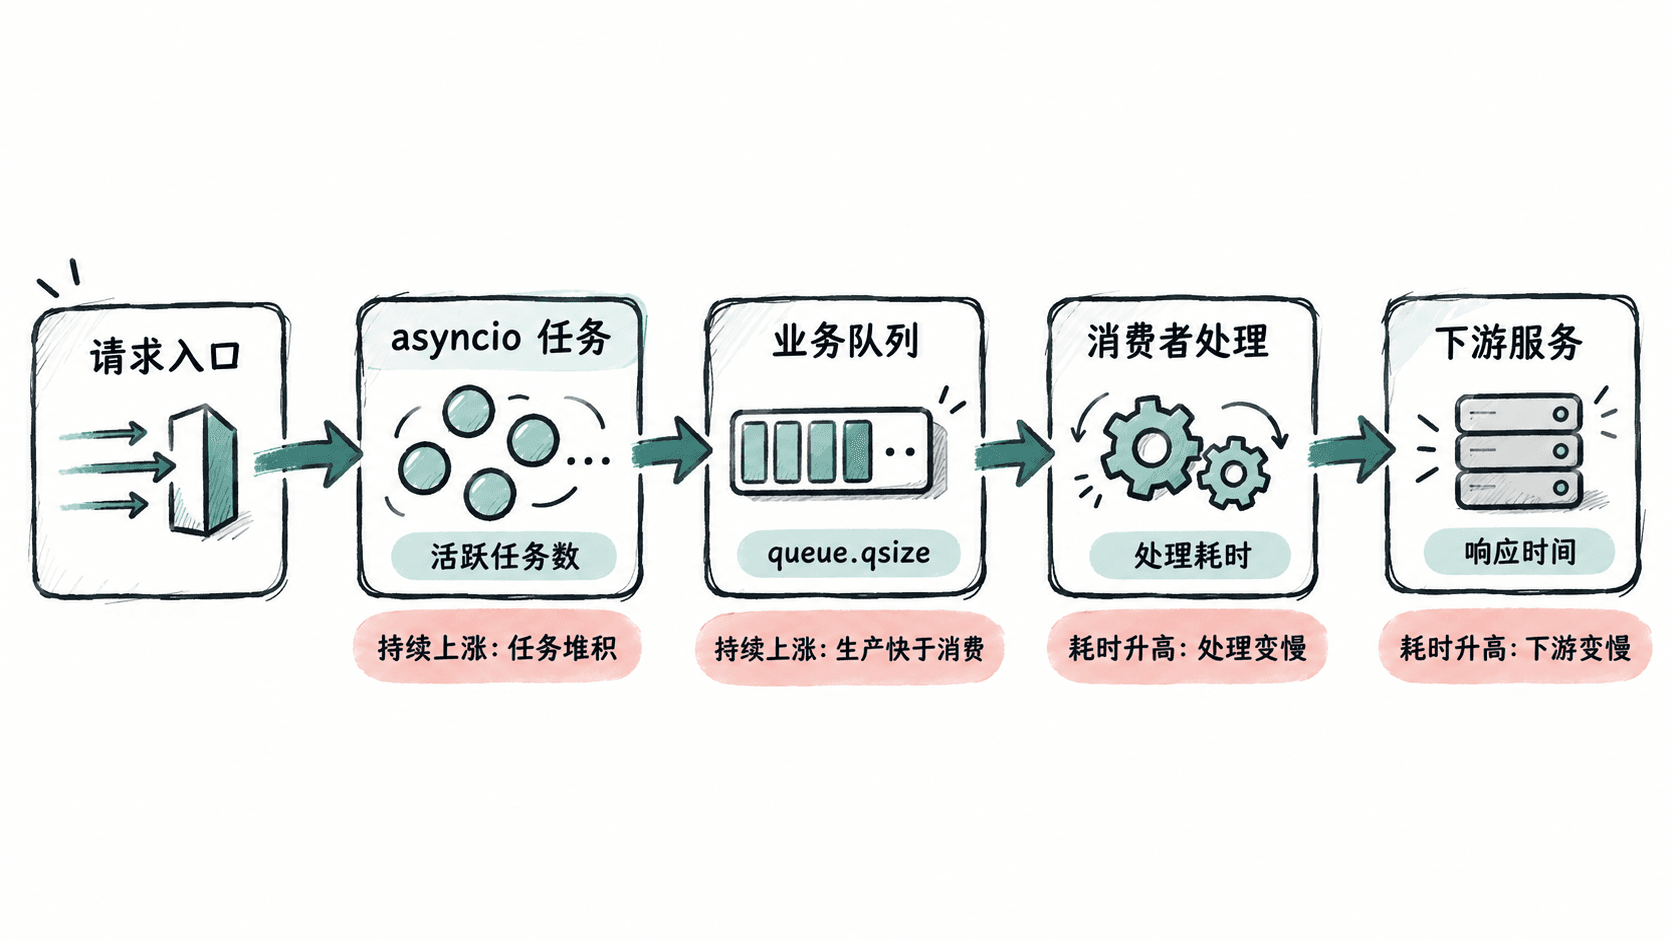
一个常见误区是只盯 asyncio.all_tasks()。任务数高可能是大量请求正在正常等待 I/O,也可能是泄漏;只有结合队列和耗时趋势,才能区分“健康并发”与“积压”。
用最小探针复现四类指标
下面的脚本模拟 10 个任务进入队列、2 个消费者处理,并把下游等待单独计时。它不是压测工具,但适合验证你要采集的指标是否齐全。
import asyncio
import time

async def downstream():
    start = time.perf_counter()
    await asyncio.sleep(0.12)
    return (time.perf_counter() - start) * 1000

async def worker(queue, samples):
    while True:
        item = await queue.get()
        started = time.perf_counter()
        downstream_ms = await downstream()
        await asyncio.sleep(0.05)
        total_ms = (time.perf_counter() - started) * 1000
        samples.append((total_ms, downstream_ms))
        queue.task_done()

async def main():
    queue = asyncio.Queue()
    samples = []

    for item in range(10):
        await queue.put(item)

    print(f"queued_before_workers={queue.qsize()}")

    workers = [asyncio.create_task(worker(queue, samples)) for _ in range(2)]
    print(f"active_tasks={len(asyncio.all_tasks())}")

    await queue.join()

    for task in workers:
        task.cancel()
    await asyncio.gather(*workers, return_exceptions=True)

    avg_total = sum(x[0] for x in samples) / len(samples)
    avg_downstream = sum(x[1] for x in samples) / len(samples)
    print(f"queued_after={queue.qsize()}")
    print(f"avg_process_ms={avg_total:.1f}")
    print(f"avg_downstream_ms={avg_downstream:.1f}")

asyncio.run(main())
预期输出
queued_before_workers=10
active_tasks=3
queued_after=0
avg_process_ms=<N>
avg_downstream_ms=<N>
其中 <N> 会随机器调度略有变化;正常情况下总处理耗时应明显高于下游等待耗时,因为示例还额外执行了约 50 ms 的本地处理。
根据指标组合判断瓶颈
如果活跃任务数持续上涨,而队列长度基本不变,优先检查任务是否卡在网络 I/O、锁、事件等待或未正确结束的后台协程。此时盲目增加消费者通常没有效果。
如果队列长度持续上涨,同时单次处理耗时稳定,说明消费者吞吐低于生产速度。应先确认消费者并发上限、CPU 使用率和队列入口速率,再决定增加 worker、批处理或限流。
如果队列长度和处理耗时一起上涨,再看下游响应时间。下游耗时同步变高,瓶颈多半在数据库、HTTP 服务或连接池;下游耗时稳定但处理耗时升高,则应继续检查本地 CPU 密集计算、序列化、锁竞争或阻塞调用。
| 现象 | 优先怀疑 | 下一步 |
|---|---|---|
| 任务数涨,队列不涨 | 协程长时间等待或泄漏 | 查看任务栈与未结束后台任务 |
| 队列涨,处理耗时稳定 | 消费能力不足 | 对比生产速率与消费速率 |
| 队列涨,下游耗时也涨 | 下游变慢 | 查连接池、超时率和依赖服务 |
| 处理耗时涨,下游稳定 | 本地处理变慢 | 查 CPU、阻塞调用和锁竞争 |
先止住增长,再做优化
确认积压层级后,修复顺序应从“控制进入量”开始,而不是直接放大并发。对无界队列设置容量,对入口设置并发上限或超时,可以阻止内存继续增长;若下游已经饱和,再提高并发只会把更多任务压到同一个瓶颈上。
验证修复时不要只看平均延迟。至少确认队列长度能回落、任务数不再单调增长、处理耗时和下游耗时恢复到稳定区间。只有“积压能够被持续消化”才说明问题真正解除。