
PostgreSQL / 系统课时
并行导出大型数据库
并行导出大型数据库
当单进程 pg_dump 无法在维护窗口内完成时,可以使用 directory 格式和多个 worker 并行导出。本课给出一套可验证的备份方法,并说明怎样从 I/O、CPU、网络、连接数与锁行为判断 --jobs 是否还能继续提高。
学习目标
- 使用 directory 格式和
--jobs执行可恢复的并行逻辑备份。 - 根据磁盘、CPU、网络与连接预算判断并行度是否过高。
- 区分初始表锁等待与并行 worker 的
NOWAIT二次锁失败。
理解 directory 并行导出的工作方式
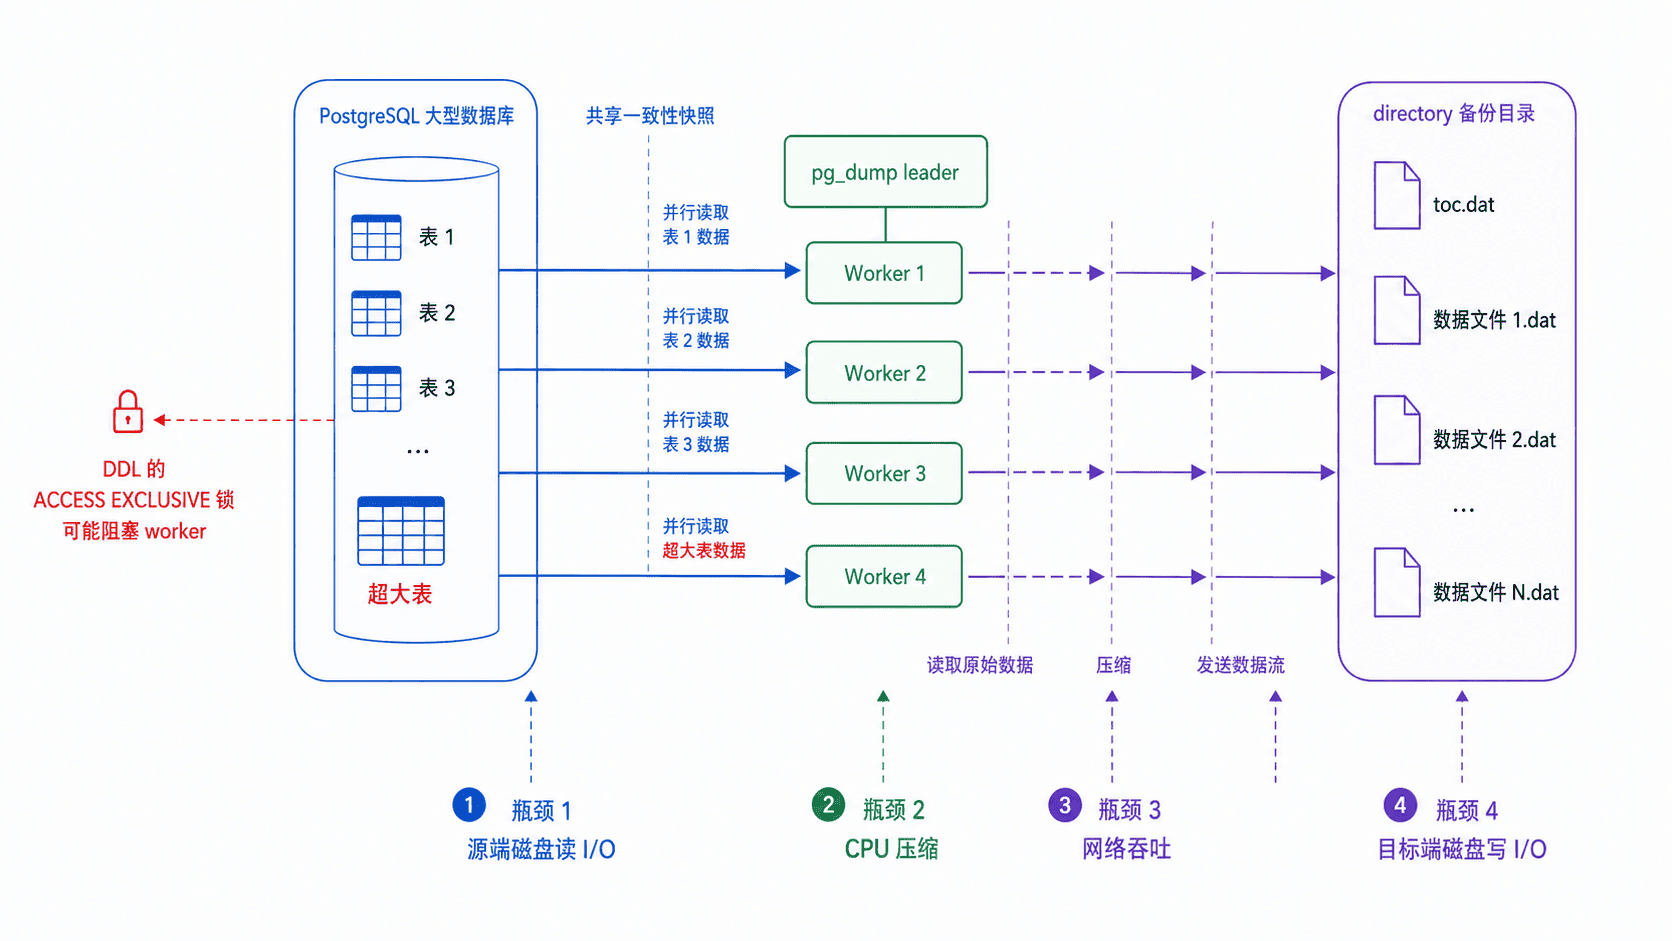
pg_dump --format=directory --jobs=N 会使用一个 leader 和多个 worker,在同步快照下并行导出可并行处理的表数据。directory 是唯一支持并行 dump 的输出格式;--jobs=N 还会让 pg_dump 总共建立 N + 1 个数据库连接,因此并行度也受 max_connections 和业务连接余量约束。
并行收益与对象分布有关。表较多时,worker 更容易持续拿到可执行任务;如果数据库主要由少数超大表构成,增加 worker 很快就会失去收益。与此同时,源端读 I/O、CPU、网络和目标端写 I/O 都会随并行度上升。
执行可验证的并行备份
备份账号需要能连接目标数据库并读取待导出的对象。密码应保存在权限受限的密码文件中,并通过 PGPASSFILE 引用,不要直接写进命令。下面从 4 个 worker 起步,并用 --lock-wait-timeout=30s 限制 dump 开始阶段获取共享表锁时的等待时间。
set -euo pipefail

export PGHOST="<HOST>"
export PGPORT="<PORT>"
export PGDATABASE="appdb"
export PGUSER="backup_user"
export PGAPPNAME="pg_dump"
export PGPASSFILE="<PATH>/.pgpass"

BACKUP_DIR="<PATH>/appdb-dir"
test ! -e "$BACKUP_DIR" || { echo "backup directory already exists"; exit 1; }

pg_dump \
  --format=directory \
  --jobs=4 \
  --lock-wait-timeout=30s \
  --file="$BACKUP_DIR"

pg_restore --list "$BACKUP_DIR" >/dev/null
test -f "$BACKUP_DIR/toc.dat" && echo "directory dump ready"
预期输出
directory dump readypg_dump 成功时通常不会输出进度;最后一行是脚本显式给出的验收结果。pg_restore --list 能确认归档目录的目录清单可读取,但它不能替代真实恢复演练。生产环境仍应定期在隔离实例执行 pg_restore 并验证关键对象和数据。
判断并行度是否遇到资源瓶颈
调大 --jobs 时要同时记录总耗时和线上负载。例如从 2 提升到 4 个 worker 后耗时明显下降,而从 4 提升到 8 后几乎不变,说明瓶颈已经从并发不足转移到存储、CPU、网络或任务本身的可并行性。
源端磁盘读延迟持续上升通常表示读 I/O 接近饱和;CPU 长时间高占用可能表示压缩和数据处理正在争抢计算资源;远程备份时若网络吞吐已接近上限,继续增加 worker 只会制造排队;目标备份盘写延迟升高也会抵消并行收益。
正确识别并行 dump 的锁冲突
--lock-wait-timeout 只用于限制 dump 开始阶段获取共享表锁的等待。并行模式下,leader 会先为后续需要处理的表取得 ACCESS SHARE 锁;如果这一步已被冲突锁阻塞,超过指定时间后 dump 会失败。
另一种情况发生在 leader 已经持有 ACCESS SHARE 之后:若其他会话再请求同一表的 ACCESS EXCLUSIVE,该独占锁会排队。worker 随后访问这张表时,为避免自己排在独占锁之后而与 leader 形成无法由服务器直接识别的等待环,会用 NOWAIT 再请求 ACCESS SHARE。如果不能立即取得,worker 会直接报错并使并行 dump 退出,不会等待到 --lock-wait-timeout。
下面的查询适合观察“初始共享表锁正在等待”的 pg_dump 会话。对于 worker 的 NOWAIT 二次锁失败,更可靠的证据是 pg_dump 的非零退出、stderr,以及当时是否有排队的 DDL。
psql -X --dbname=appdb --command="
SELECT
  pid,
  state,
  wait_event_type,
  wait_event,
  pg_blocking_pids(pid) AS blockers
FROM pg_stat_activity
WHERE application_name = 'pg_dump'
ORDER BY pid;"
初始表锁被阻塞时的预期结果形态
 pid   | state  | wait_event_type | wait_event | blockers
<PID>  | active | Lock            | relation   | {<PID>}
实际 PID 会随会话变化;没有初始锁等待时,wait_event_type、wait_event 和 blockers 通常为空。若并行备份突然退出,不要因为命令中配置了 --lock-wait-timeout 就把 worker 的 NOWAIT 失败解释成“等待超时”,应结合 stderr 与并发 DDL 的锁队列确认原因。
选择可持续的 jobs
实践中可以从 2~4 个 worker 起步,逐档提高并记录总耗时、源端读延迟、CPU、网络、目标盘写延迟和数据库连接数。当增加 worker 已无法明显缩短备份,或开始损害线上 SLI,就应停止加并行度。
如果数据库主要由少数超大表构成,单纯提高 --jobs 的收益通常有限。此时应评估对象拆分或分区、调整备份窗口,或者改用更适合大体量数据的物理备份方案,而不是继续堆高并行度。