
PostgreSQL / 系统课时
执行一致性的逻辑备份
执行一致性的逻辑备份
在线数据库持续写入时,逻辑备份既要保持同一数据视图,又不能长期暂停业务。本课用 pg_dump 完成可验证的一致性备份,并厘清并行 worker、选择性过滤、Large Object、扩展和全局对象的实际覆盖边界。
学习目标
- 理解
pg_dump如何依靠 MVCC 快照在并发读写期间保持逻辑一致性。 - 执行并行逻辑备份并确认生成的归档可被
pg_restore正常读取。 - 正确判断选择性备份、Large Object、扩展与全局对象的覆盖范围。
一致性来自 MVCC 快照
pg_dump 在一致性事务快照中读取数据库。快照建立前已经提交的数据可见,之后才提交的普通 INSERT、UPDATE、DELETE 不会被随意混入同一份导出,因此通常不需要为了逻辑一致性暂停业务写入。
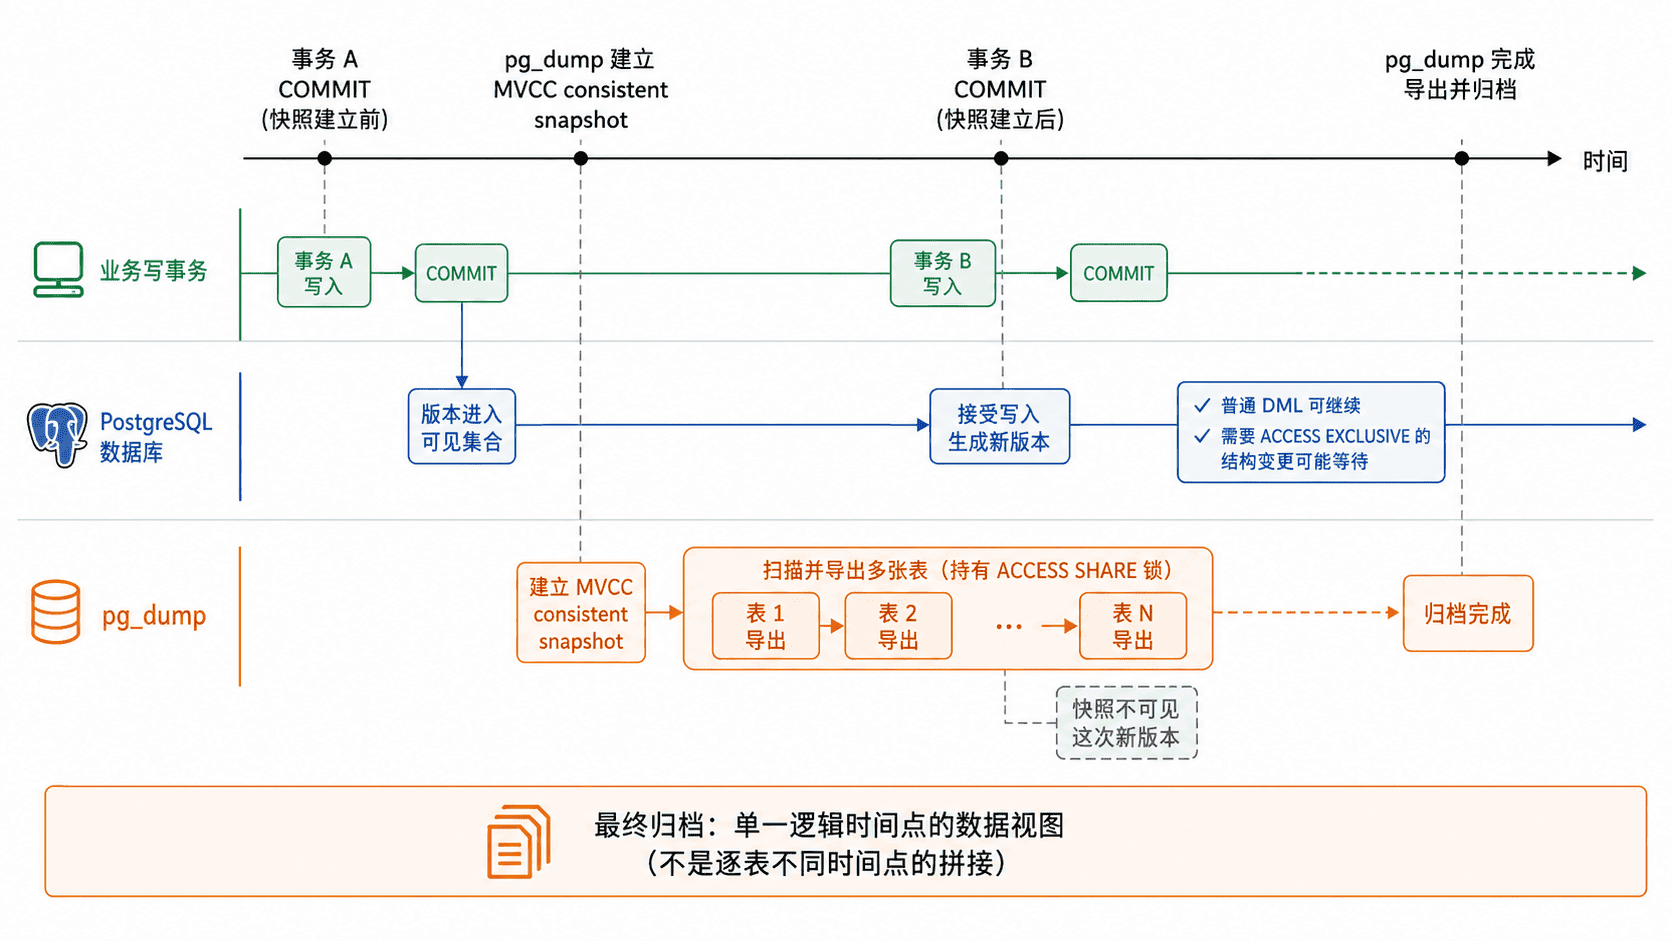
一致性快照不等于完全无锁。pg_dump 会对正在导出的表取得 ACCESS SHARE 锁,普通 DML 与它兼容,但需要 ACCESS EXCLUSIVE 的 DDL 可能等待,或者与备份形成锁竞争。因此,大型在线备份应避开集中执行高冲突结构变更的维护窗口。
使用 directory 格式并通过 -j 并行备份时,主进程会协调同步快照,各 worker 导入同一个快照,而不是各自在不同时间点读取数据。并行提高读取吞吐,但不会改变“一份备份对应一个一致性数据视图”的目标。
执行并行备份并确认归档可读取
下面使用 directory 格式启动 4 个并行任务,再让 pg_restore 读取归档目录。将 <TIME> 替换为本次备份的唯一时间标识;目标目录必须尚不存在,示例假设 appdb 可连接且当前用户拥有所需读取权限。
set -euo pipefail
mkdir -p ./backup
backup_dir='./backup/appdb-<TIME>'

# directory 格式支持 pg_dump -j 并行导出,所有 worker 使用协调后的同一快照。
pg_dump -d appdb -Fd -j 4 -f "$backup_dir"
pg_restore -l "$backup_dir" >/dev/null
printf 'archive readable\n'
预期输出
archive readablepg_restore -l 只能证明归档结构能够被读取,不能替代恢复演练。真正的可用性验证仍应在隔离数据库中执行恢复,并检查关键对象、数据量和代表性业务查询。
选择对象范围时不要误判 Large Object
使用 -n、--schema、-t 或 --table 会缩小导出范围,但 pg_dump 不会计算所选对象的完整依赖闭包。只选择两张表,并不意味着相关类型、函数、序列、扩展或其他业务依赖都会自动加入归档。
Large Object 也不是普通表行的一部分。使用表、schema 等选择性过滤后,Large Object 默认不会因为某个表列中保存了它的 OID 就被按引用关系自动追踪;此时显式指定 --large-objects 的含义是把 Large Object 这一类对象整体加入备份,而不是只导出被所选表实际引用的那些 Large Object。
因此,pg_dump -t ... --large-objects 不能当作“表及其 Large Object 引用闭包”的导出工具。在包含大量 Large Object 的数据库中,它可能额外带入许多与所选业务表无关的对象,同时仍不会自动补齐类型、函数、序列或其他依赖。
扩展、全局对象与 PITR 的边界
扩展需要区分数据库中的逻辑定义和服务器上的扩展软件。逻辑备份可以保存用于重新创建扩展的数据库定义,但不会打包目标主机上的共享库、control 文件或操作系统软件包;恢复前必须先安装兼容的扩展版本。
普通 pg_dump 只覆盖一个数据库。角色、角色成员关系和 tablespace 等集群级全局对象需要另行保存,可使用 pg_dumpall --globals-only 导出对应定义。这份全局对象输出不会与某个数据库的 pg_dump 共享同一个 MVCC 快照,因此应作为独立的恢复材料管理和验证。
在线逻辑备份真正需要守住的是一致性视图、DDL 冲突窗口和备份范围三条边界。命令成功只是第一步;能够在隔离环境中恢复,并证明依赖、Large Object、扩展和全局对象的处理符合预期,才算完成可用性验证。