
PostgreSQL / 系统课时
设计可靠的 WAL 归档存储
设计可靠的 WAL 归档存储
WAL 归档存储的目标不是“找个目录放文件”,而是让数据库主机丢失、磁盘损坏或恢复主机更换后,仍能连续取得恢复所需的 WAL。本课给出一套可落地的故障隔离、命名、权限、保留与验收方法,并说明文件系统和对象存储需要满足的关键条件。
学习目标
- 把 WAL 归档放到独立故障域,避免恢复链依赖单一数据库主机。
- 设计可区分集群、时间线且禁止静默覆盖的归档命名与写入规则。
- 用权限、保留策略和恢复验证证明归档存储不仅“能写”,而且“能恢复”。
先确定存储的故障边界
可靠归档至少要与 PGDATA 分离。独立文件系统或分区可以隔离容量耗尽与部分文件系统故障,但不能隔离同一磁盘或同一主机失效;部署在独立存储服务上的远端文件系统或对象存储,才能进一步隔离数据库主机故障。生产环境通常把本机目录当作短暂缓冲区,把远端、具备冗余能力的存储作为权威归档副本。
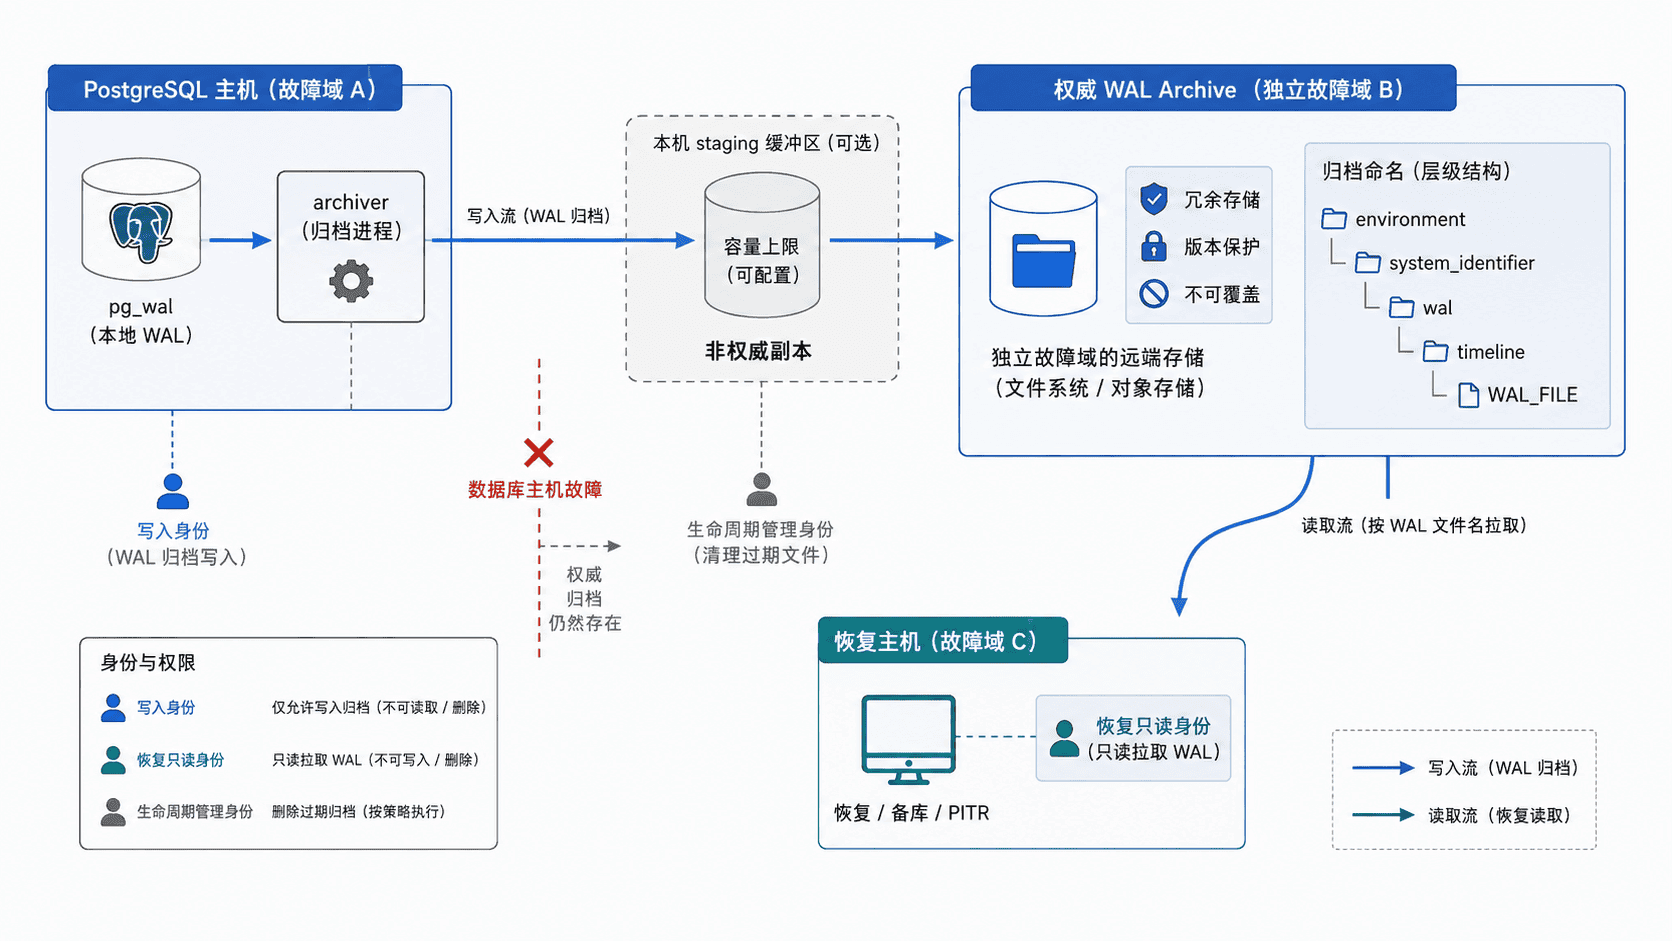
选型时不要只比较容量价格,而要确认四件事:数据库主机故障时归档是否仍存在;写入成功是否意味着数据已经达到预期持久级别;是否能防止同名对象被静默覆盖;恢复端能否在数据库主机完全不可用时独立读取。
设计不会冲突的命名和写入语义
WAL 文件名包含时间线信息,但不包含数据库集群的 system identifier。如果多套独立集群共用一个归档根目录,只用 %f 作为全局对象名可能发生碰撞。更安全的做法是先隔离环境与归档命名空间,再保存 system_identifier、时间线和原始 WAL 文件名,例如:
postgresql/
  prod/
    <CLUSTER_SLUG>/
      <SYSTEM_IDENTIFIER>/
        wal/
          <TIMELINE>/
<WAL_FILE>这是结构示例,不是必须逐字创建的固定目录。<CLUSTER_SLUG> 应由运维侧为独立归档域分配稳定名称;<SYSTEM_IDENTIFIER> 可由 pg_control_system() 读取;<TIMELINE> 可从 WAL 文件名的前 8 个十六进制字符派生。物理克隆如果要脱离原集群独立演进,也应使用新的 <CLUSTER_SLUG>,不能只依赖相同的 system_identifier。
写入语义应是 publish once:目标不存在时创建,目标已存在且内容一致时视为幂等成功,目标已存在但内容不同则立即失败并告警。文件系统应使用临时文件加“不覆盖式”的原子发布,不能依赖会覆盖目标的普通 mv;对象存储应使用条件创建或等价的不可覆盖机制,而不是普通 PUT 后再假设“最后一次写入就是正确版本”。
隔离权限与生命周期
归档写入身份只需要在自己的集群前缀下创建 WAL;恢复身份只需要读取;删除和生命周期策略应交给独立的管理身份。这样即使数据库主机凭据泄露,也不应具备批量删除历史 WAL 的能力。
保留策略必须围绕“仍被保留的基础备份能否完成恢复”设计,而不是简单按固定天数删除。只要某个基础备份仍承诺可做 PITR,就必须保留从该备份恢复起点开始、直到承诺目标时间范围内的连续 WAL;发生时间线切换时,还要保留对应的 timeline history 文件和后续分支所需 WAL。
如果使用对象存储,可再叠加服务端加密、跨故障域冗余、版本保护或对象锁等能力;如果使用远端文件系统,则至少需要独立主机或存储阵列、可靠挂载、容量告警和备份。无论哪种方案,本机单目录都不应是唯一归档副本。
用验收脚本证明目录可用
下面的检查脚本适用于“独立挂载的文件系统归档”场景,并假设归档根目录已由管理员创建、当前用户可写,且数据库角色有权调用 pg_control_system()。它验证集群命名空间、读写能力,以及归档目录与 PGDATA 是否位于不同文件系统。
#!/usr/bin/env bash
set -euo pipefail

base=/mnt/pg-archive/prod/orders-primary
system_id=$(psql -X -Atqc 'SELECT system_identifier FROM pg_control_system()')
pgdata=$(psql -X -Atqc 'SHOW data_directory')
archive_root="${base}/${system_id}/wal"

test -d "$archive_root"
test -w "$archive_root"

pgdata_dev=$(stat -c '%d' "$pgdata")
archive_dev=$(stat -c '%d' "$archive_root")

if [[ "$pgdata_dev" == "$archive_dev" ]]; then
  echo "archive filesystem is not isolated from PGDATA" >&2
  exit 1
fi

probe=$(mktemp "${archive_root}/.probe.XXXXXX")
copy=$(mktemp)
trap 'rm -f "$probe" "$copy"' EXIT

printf 'wal-archive-probe\n' > "$probe"
cat "$probe" > "$copy"
cmp -s "$probe" "$copy"

printf 'system_identifier=%s\n' "$system_id"
printf 'archive_root=%s\n' "$archive_root"
printf 'filesystem_is_separate=ok\n'
printf 'write_read_probe=ok\n'
预期输出中的 system identifier 取决于当前集群,实际值可能不同:
system_identifier=<ID>
archive_root=/mnt/pg-archive/prod/orders-primary/<ID>/wal
filesystem_is_separate=ok
write_read_probe=ok
这只能证明“独立挂载且可读写”,不能证明远端存储真的具备主机级故障隔离。如果归档目标是对象存储,应把验收项换成:条件创建成功、重复同名写入被拒绝或校验为一致、恢复身份可读、写入身份不可删、对象在预期冗余和保留策略下可见。
把存储验证延伸到恢复
归档监控只能证明 WAL 正在离开数据库,不能证明未来一定取得回来。至少要定期从归档存储抽取一个已完成 WAL,使用只读恢复身份下载到隔离目录,并校验大小或校验和;更高价值的验证是用真实基础备份加归档 WAL 启动一套临时恢复实例。
验收时同时观察 pg_stat_archiver 的失败计数、最近成功归档时间、归档端对象增长和容量水位。只有“持续写入、不能误覆盖、跨故障域保存、可由独立恢复端读取、保留窗口覆盖承诺的 PITR 范围”同时成立,这个归档存储才真正承担了恢复链的一部分。