
PostgreSQL / 系统课时
监控 WAL 归档状态与积压
监控 WAL 归档状态与积压
WAL 归档监控不能只看“有没有报错”,更要确认归档链是否持续推进。本课结合 pg_stat_archiver、.ready 积压与 PostgreSQL 日志,识别普通失败,也覆盖归档器异常退出后失败计数不增长的盲区。
学习目标
- 读取
pg_stat_archiver,正确解释成功、失败与统计重置 - 用
.ready数量和最老等待时间识别归档积压 - 用日志和积压信号识别
failed_count无法记录的归档器异常
先区分暂时空闲与真正停滞
last_archived_time 很久没有变化并不一定是故障。业务写入很少、尚未产生新的可归档 WAL 文件时,归档器本来就没有工作。更可靠的停滞信号是:已经存在 .ready 文件等待处理,最老等待时间持续增加,或者日志明确记录 archiver 异常。
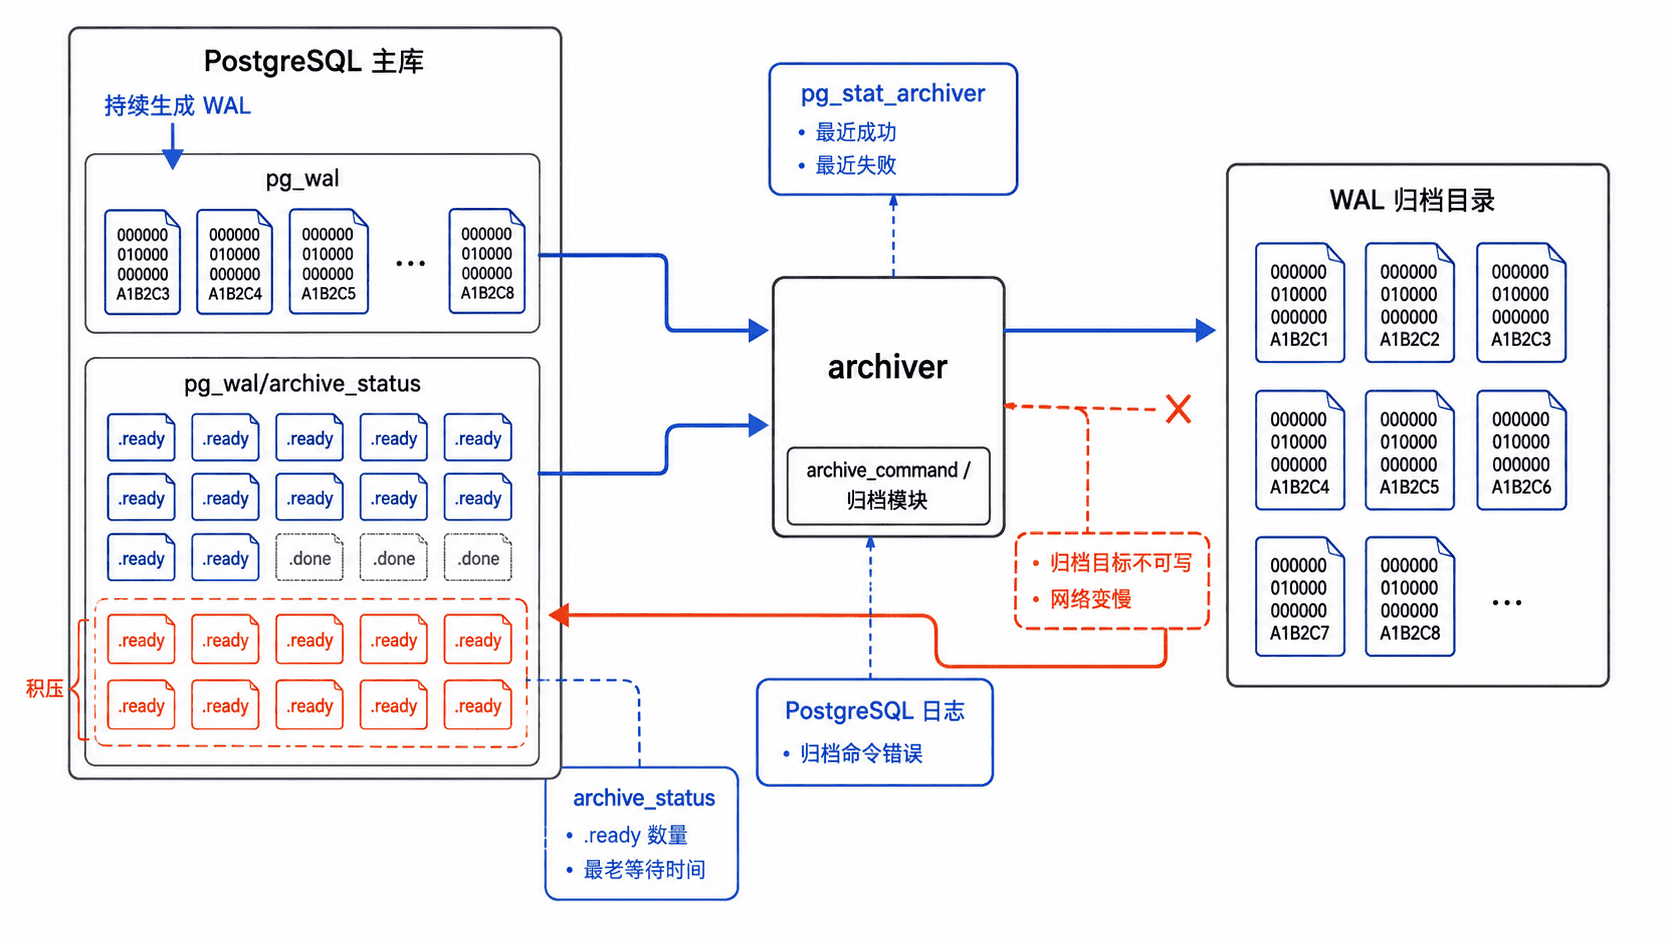
因此监控应同时回答三件事:最近一次成功是否推进、普通失败是否增加、当前是否存在等待归档的 WAL。只盯其中一项,既可能把低写入误判为故障,也可能漏掉 archiver 反复退出并重启的异常。
用统计视图观察成功与普通失败
先在主库读取归档器统计,并记录当前 WAL 位置。archived_count 与 failed_count 都是累计值,监控系统应比较采样窗口内的增量,同时检查 stats_reset;统计被重置后,应重新建立基线,而不是把计数回落当成负速率。
SELECT
    pg_current_wal_lsn() AS current_wal_lsn,
    archived_count,
    failed_count,
    last_archived_wal,
    last_archived_time,
    last_failed_wal,
    last_failed_time,
    stats_reset
FROM pg_stat_archiver;
预期结果
 current_wal_lsn | archived_count | failed_count |    last_archived_wal     | last_archived_time | last_failed_wal | last_failed_time | stats_reset
-----------------+----------------+--------------+--------------------------+--------------------+-----------------+------------------+------------
 <VALUE>         | <VALUE>        | <VALUE>      | 00000001000000AA0000003F | <TIME>             | <VALUE>         | <TIME>           | <TIME>
实际计数、LSN 和时间会不同。采样窗口内 failed_count 增加,可以确认发生了被统计系统记录的归档失败;计数没有增加则不能反推归档健康。
另外,last_archived_wal 只表示最近成功归档的 WAL 文件名。WAL 通常按从旧到新的顺序归档,但备库晋升、崩溃恢复等情况下不保证严格顺序,不能据此证明编号更小的所有 WAL 都已经成功归档。
用 archive_status 量化积压
等待归档的 WAL 会在 pg_wal/archive_status 中出现对应的 .ready 文件。下面的 Linux 命令统计等待数量,并用状态文件的修改时间近似计算最老等待项的年龄;执行前把 <PATH> 替换为实际 PGDATA。
PGDATA="<PATH>"
STATUS_DIR="$PGDATA/pg_wal/archive_status"
now_epoch=$(date +%s)

ready_count=$(find "$STATUS_DIR" -maxdepth 1 -type f -name '*.ready' | wc -l)
oldest_epoch=$(find "$STATUS_DIR" -maxdepth 1 -type f -name '*.ready' -printf '%T@\n' \
  | sort -n | head -n 1 | cut -d. -f1)

if [ -n "$oldest_epoch" ]; then
  oldest_age_seconds=$((now_epoch - oldest_epoch))
else
  oldest_age_seconds=0
fi

printf 'ready_count=%s\n' "$ready_count"
printf 'oldest_ready_age_seconds=%s\n' "$oldest_age_seconds"
预期输出
ready_count=<VALUE>
oldest_ready_age_seconds=<VALUE>
没有积压时,两项通常都是 0。数量持续增长说明归档吞吐跟不上 WAL 生成速度;数量未增长但 oldest_ready_age_seconds 持续变大,同样说明队首 WAL 长时间未被处理。这里的 find -printf 是 GNU find 语法,其他平台需改用等价的文件时间查询方式。
用日志覆盖统计盲区
当 failed_count 不增长但 .ready 持续积压时,应立即检查 PostgreSQL 日志,确认 archiver 是否退出、重启,或归档命令是否遭遇 shell、权限、容量、网络等错误。systemd 环境可先查看近期相关日志;服务单元名称需按实际部署调整。
journalctl -u postgresql --since "15 minutes ago" --no-pager \
  | grep -Ei 'archive|archiver|WAL' \
  | tail -n 30
预期输出
<TIME> <HOST> postgres[<PID>]: LOG: archive command failed with exit code <VALUE>
<TIME> <HOST> postgres[<PID>]: <ARCHIVER_EXIT_OR_RESTART_LOG>
具体文本会随 PostgreSQL 版本、失败方式和部署方式不同而变化,也可能没有匹配记录。日志出现 archiver 退出或重启,而 failed_count 没有同步增加,正是统计盲区的典型证据;此时应继续检查归档目标权限与容量、网络连通性、凭据以及 archive_command 或 archive_library 的实际错误。
把信号组合成告警
告警不要只写成“十分钟没归档”。更稳妥的规则是:采样窗口内 failed_count 增量大于零时告警;.ready 数量持续增长或最老等待时间超过归档延迟预算时告警;日志出现 archiver 异常退出或反复重启时告警。last_archived_time 长时间不变只作为辅助信号,必须结合待归档 WAL 是否存在来解释。
还应对 pg_wal 所在文件系统设置独立容量阈值。归档持续失败时,尚未安全归档的 WAL 不能按正常节奏回收或复用,pg_wal 可能不断膨胀,最终导致磁盘耗尽并影响数据库可用性。可靠的归档监控不是一个布尔值,而是同时跟踪失败增量、积压年龄、归档器异常和本地容量风险。