
PostgreSQL / 系统课时
排查 WAL 缺口与归档失败
排查 WAL 缺口与归档失败
PITR 卡住时,最重要的是找到“恢复链上第一个拿不到的 WAL”。本篇按源端归档状态、归档存储、WAL 文件连续性和 restore_command 返回结果逐层定位,并说明哪些故障能补救、哪些缺口无法绕过。
学习目标
- 从恢复日志锁定首个缺失 WAL,并区分源端归档失败与恢复端读取失败。
- 检查
pg_stat_archiver、归档存储和restore_command的关键证据。 - 修复可恢复故障,并判断真正 WAL 缺口何时必须更换恢复起点。
先锁定第一个失败的 WAL
不要先清理目录、重做备份或反复重启。先从 PostgreSQL 恢复日志记录首个无法获取的 WAL 文件名,例如 <WAL_SEGMENT>。后续检查都围绕这个文件展开,因为恢复必须沿正确的时间线顺序重放,后面的 WAL 即使存在,也不能跨过中间的必需段。
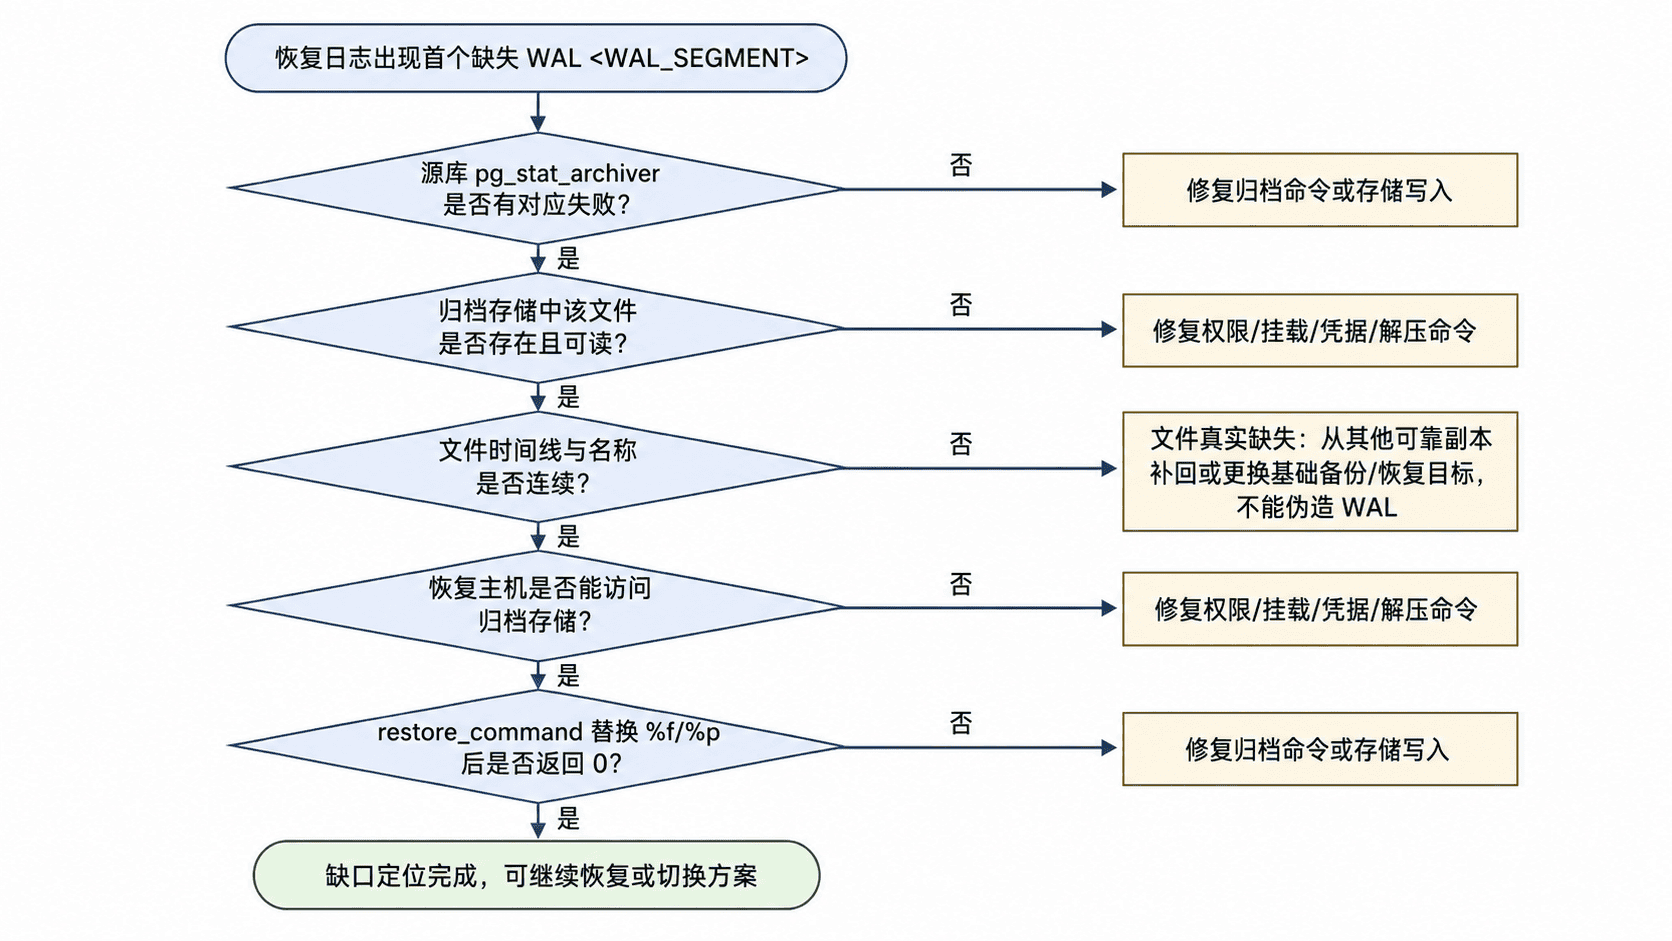
恢复过程中,PostgreSQL 可能尝试获取某个 timeline history 文件,而文件不存在并不一定代表致命故障。例如探测尚不存在的更高时间线时,日志可能记录一次取回失败,但恢复仍能沿当前有效时间线继续。判断关键是 PostgreSQL 是否随后明确要求某个 WAL 段且因无法取得它而停止推进;真正的必需 WAL 段缺失时,不能靠“跳过文件”维持一致性。
判断故障发生在归档端还是恢复端
先到产生 WAL 的源端检查归档配置和统计。failed_count 持续增加,且 last_failed_wal 与缺失段接近,通常说明归档命令正在失败,需要继续检查源端日志和归档目标。
SHOW archive_mode;
SHOW archive_command;

SELECT
    archived_count,
    failed_count,
    last_archived_wal,
    last_archived_time,
    last_failed_wal,
    last_failed_time
FROM pg_stat_archiver;
预期结果
 archive_mode
--------------
 on

 archive_command
-----------------
 <ARCHIVE_COMMAND>

 archived_count | failed_count | last_archived_wal | last_archived_time | last_failed_wal | last_failed_time
 <VALUE>        | <VALUE>      | <WAL_SEGMENT>     | <TIME>             | <WAL_SEGMENT>  | <TIME>
实际计数和时间会随实例运行而变化。如果 failed_count 持续增长,优先检查 PostgreSQL 日志中归档命令的错误信息,再核对目标挂载、对象存储凭据、磁盘空间和命令退出码。不要把 cp ... || true 这类“永远返回成功”的写法用于 archive_command,否则 PostgreSQL 会误以为 WAL 已安全归档,并允许对应 WAL 被后续回收,从而造成无法补回的缺口。
需要注意,pg_stat_archiver 反映的是当前实例归档进程的统计状态,不能单独证明某个历史 WAL 一定仍存在于归档介质中。最终仍要回到恢复日志点名的文件逐一验证。
检查归档存储中的文件与连续性
如果源端统计看起来正常,直接检查恢复日志点名的 <WAL_SEGMENT> 是否真的存在,并以运行 PostgreSQL 的系统用户验证可读性。下面示例适用于文件系统归档;对象存储应使用对应 CLI 做同样的存在性、权限和下载测试。
WAL_SEGMENT="<WAL_SEGMENT>"
ARCHIVE_DIR="<ARCHIVE_PATH>"

if sudo -u postgres test -r "${ARCHIVE_DIR}/${WAL_SEGMENT}"; then
  echo "readable: ${WAL_SEGMENT}"
else
  echo "missing-or-unreadable: ${WAL_SEGMENT}"
fi

df -P "${ARCHIVE_DIR}"
预期输出
readable: <WAL_SEGMENT>
Filesystem  1024-blocks  Used    Available  Capacity  Mounted on
<DEVICE>    <VALUE>      <VALUE> <VALUE>    <VALUE>%  <PATH>
若结果是 missing-or-unreadable,继续区分“文件不存在”和“postgres 用户无权读取”。文件存在但权限错误属于恢复端访问问题;文件根本不存在,则要查是否从未成功归档,或是否被生命周期策略、清理脚本等提前删除。
检查“连续性”时不要只按目录中文件名排序后观察相邻项。WAL 文件名还包含时间线信息,发生时间线切换后恢复可能同时需要对应的 .history 文件。最可靠的判断依据是恢复日志实际请求的顺序:每一个真正必需的文件都必须能够从归档介质取回。
验证 restore_command 的真实返回结果
restore_command 接收 %f 作为需要获取的 WAL 文件名,%p 作为 PostgreSQL 希望写入的目标路径。命令只有在成功取得正确文件时才能返回 0;文件不存在、凭据失效、解压失败或复制失败都应返回非零,让 PostgreSQL 知道本次取回没有成功。
先读取恢复实例实际使用的数据目录配置值,避免检查了错误的配置文件。
sudo -u postgres postgres -D "<PGDATA>" -C restore_command预期输出
<RESTORE_COMMAND>对于文件系统复制型配置,可以把日志中的缺失段复制到安全的临时目录,验证同一运行用户是否能够读取归档文件,而不要直接覆盖真实 pg_wal 目录。
WAL_SEGMENT="<WAL_SEGMENT>"
ARCHIVE_DIR="<ARCHIVE_PATH>"
TEST_DIR="$(sudo -u postgres mktemp -d)"

sudo -u postgres cp "${ARCHIVE_DIR}/${WAL_SEGMENT}" "${TEST_DIR}/${WAL_SEGMENT}"
printf 'exit_code=%s\n' "$?"
预期输出
exit_code=0如果这里失败而文件实际存在,根因通常在文件权限、挂载路径、SELinux/AppArmor、容器卷或存储凭据。若实际 restore_command 还包含下载、解压或其他处理步骤,应在安全临时路径中按相同用户验证整条命令的失败传播;尤其是包含管道的脚本,不能让前序命令失败后仍以 0 退出,否则会掩盖真实故障。
修复后验证恢复链继续前进
修复归档写入或恢复读取后,重新启动或继续恢复并观察日志。关键不是“错误少了”,而是 PostgreSQL 已成功取得原先失败的 <WAL_SEGMENT>,随后继续请求并重放后续 WAL。恢复实例已经进入可查询状态时,可以检查当前恢复状态和最后回放位置。
SELECT
    pg_is_in_recovery(),
    pg_last_wal_replay_lsn(),
    pg_last_xact_replay_timestamp();
预期结果
 pg_is_in_recovery | pg_last_wal_replay_lsn | pg_last_xact_replay_timestamp
 <VALUE>           | <LSN>                  | <TIME>
<LSN> 和 <TIME> 会随回放推进而变化。若恢复仍在进行,应结合连续两次查询或恢复日志确认回放位置持续前进,而不能只根据一次查询判断故障已经解除。
真正的必需 WAL 段若在所有可靠副本中都不存在,就不存在安全的“跳过”修复。可以从其他归档副本补回完全相同且完整的 WAL 段;如果没有任何副本,则只能改用不依赖该缺失段的恢复链,例如选择更晚且自身具备完整后续 WAL 的基础备份重新开始恢复。伪造空文件、修改 WAL 文件名或强行让 restore_command 返回成功都会破坏恢复链,不能作为补救方案。