
PostgreSQL / 系统课时
用 RPO 与 RTO 定义恢复目标
用 RPO 与 RTO 定义恢复目标
这篇把“尽量少丢数据、尽快恢复”变成可执行指标。你会用 RPO 约束可接受的数据丢失窗口,用 RTO 约束业务恢复时长,并把它们反推为基础备份、WAL 归档、监控和恢复演练要求。
学习目标
- 用时间轴准确区分 RPO 与 RTO
- 从业务目标反推备份频率、WAL 连续性和恢复资源要求
- 用归档状态与恢复演练验证目标是否真的可达
把 RPO 与 RTO 放在同一条时间轴上
RPO(Recovery Point Objective)回答“最多能丢多久的数据”。若业务 RPO 是 5 分钟,发生灾难后可接受的恢复点最多落后故障时刻约 5 分钟。它约束的是恢复点距离故障时刻的时间差,不是备份任务本身运行了多久。
RTO(Recovery Time Objective)回答“故障后多久必须恢复业务”。若 RTO 是 30 分钟,从业务中断或故障发生到新实例可被业务使用,检测、准备环境、恢复基础备份、回放 WAL、校验和切流的总耗时都要落在这 30 分钟内。
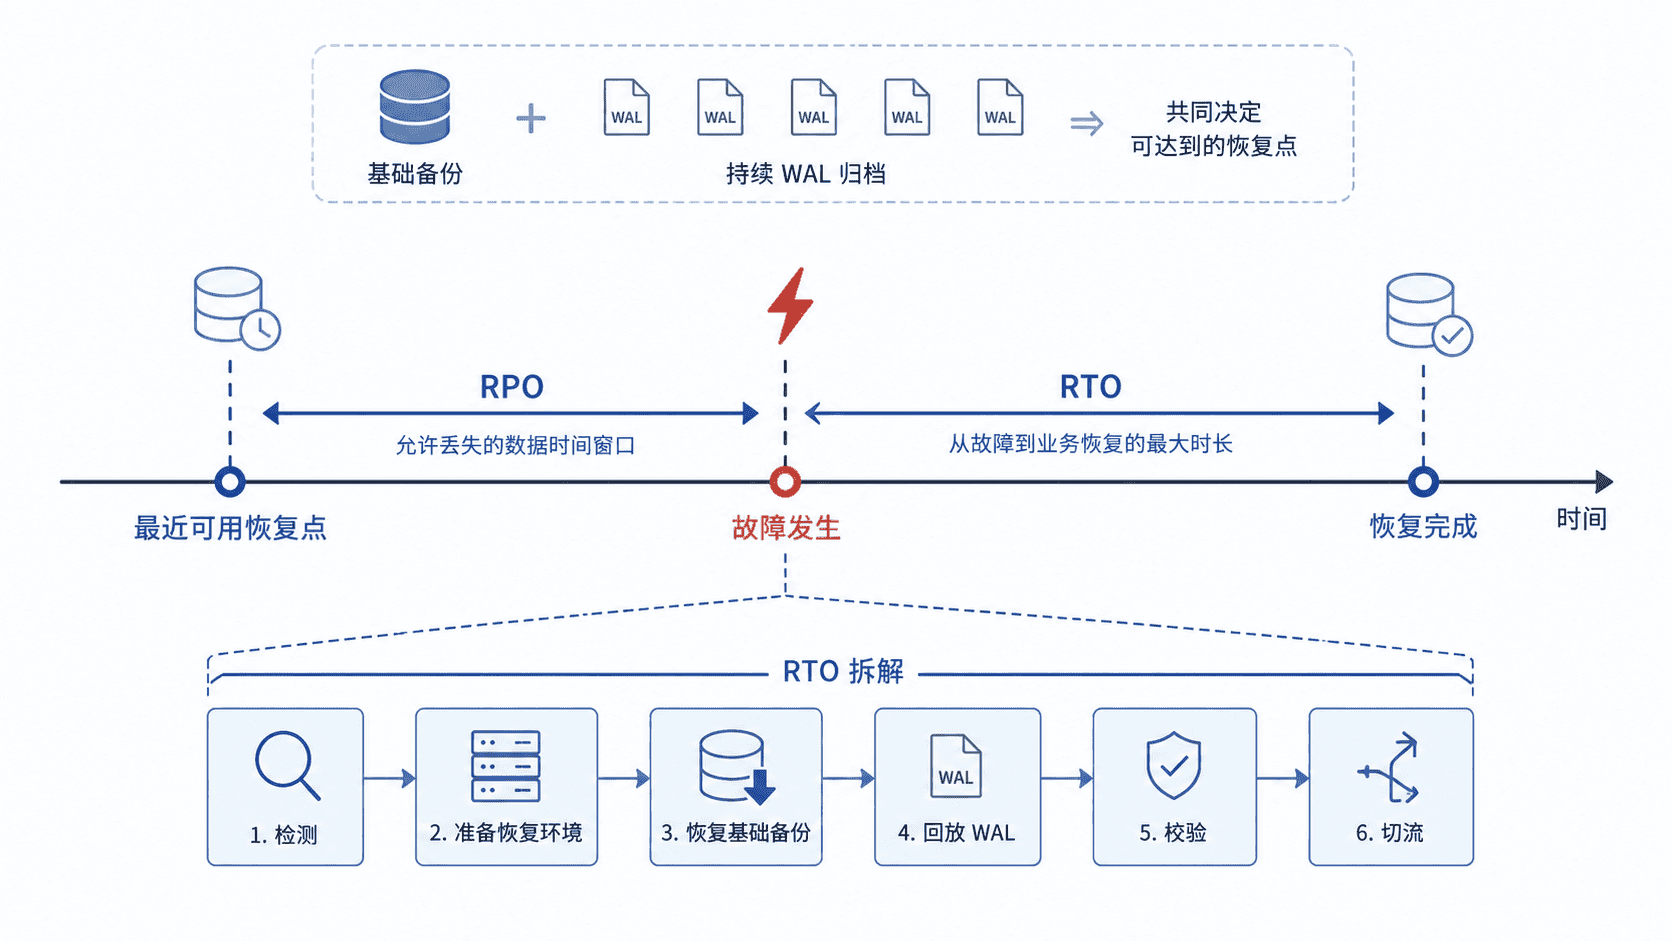
从目标反推备份与归档要求
如果业务给出 RPO 5 分钟,单纯“每天做一次基础备份”显然不够;需要把基础备份后的 WAL 持续传到独立、可靠的存储,并让归档失败和异常延迟能够被及时发现。低写入场景还要关注 WAL 段长时间不切换的问题,必要时评估 archive_timeout,但它只能限制自动 WAL 切段之间的最长间隔,不能替代对归档成功率和存储可用性的监控。
RTO 30 分钟则会继续约束备份形态与恢复环境。若恢复 2 TB 基础备份本身就需要 50 分钟,那么即使 RPO 做到 1 分钟也无法满足 RTO。此时要通过更快的备份介质、预置恢复主机、并行恢复能力、更高的基础备份频率或备用实例来缩短恢复路径。
用归档状态检查 RPO 风险
在开启 WAL 归档的主库上,可以先看 pg_stat_archiver。下面查询把最近一次成功归档距离当前的时间换算成秒,便于和业务 RPO 做同量纲比较。
SELECT
  archived_count,
  failed_count,
  last_archived_wal,
  EXTRACT(EPOCH FROM (clock_timestamp() - last_archived_time))::bigint AS archive_age_seconds
FROM pg_stat_archiver;
预期结果
 archived_count | failed_count | last_archived_wal | archive_age_seconds
----------------+--------------+-------------------+--------------------
 <VALUE>        | <VALUE>      | <VALUE>           | <VALUE>
实际值会随负载和运行时间变化;如果尚未成功归档过 WAL,相关字段也可能为 NULL。活跃写入期间,如果 failed_count 持续增长,或 archive_age_seconds 长期超过 RPO 预算,应立即检查归档命令、目标存储和 WAL 传输链路。
不过 archive_age_seconds 不是严格的“数据丢失量”指标:低写入时可能因为当前 WAL 段尚未切换而变大。因此生产监控还应结合 WAL 生成速率、归档失败、归档存储中的 WAL 连续性以及恢复演练结果判断,而不能只设置一个时间阈值。
用恢复演练证明 RTO 可达
RTO 不能靠配置文件推算完成,必须定期计时演练。一次完整演练应从“宣布主库不可用”开始计时,直到恢复实例通过一致性检查、关键查询验证并具备切流条件为止。
演练时至少记录基础备份恢复耗时、需要回放的 WAL 量与回放耗时、验证耗时,以及人为审批或基础设施准备造成的等待。若任何阶段长期逼近目标上限,就应调整备份策略或恢复资源,而不是把希望寄托在真实故障时“操作会更快”。
最终可以把业务目标写成可验收条件,例如:“RPO ≤ 5 分钟,要求 WAL 归档链连续且归档失败与延迟受监控;RTO ≤ 30 分钟,要求季度演练从故障确认到可切流的实际耗时不超过 30 分钟。”这样备份策略才从“做了任务”变成“能够恢复”。