
PostgreSQL / 系统课时
开展灾难恢复演练并验证 RPO/RTO
开展灾难恢复演练并验证 RPO/RTO
灾难恢复方案只有在真实计时和业务证据下才可信。本课用一次可重复的 PostgreSQL 演练,把连续提交探针、故障注入、PITR 恢复、数据校验和业务接管串成完整流程,并用故障前最后一次已确认提交与恢复后最后可见提交计算实际 RPO、RTO。
学习目标
- 设计包含持续业务探针、故障注入、恢复、校验和业务接管的完整演练
- 用故障域之外的见证记录核对最后确认提交,准确计算实际 RPO 与 RTO
- 根据数据缺口、阶段耗时和人工步骤修订恢复方案
统一演练口径
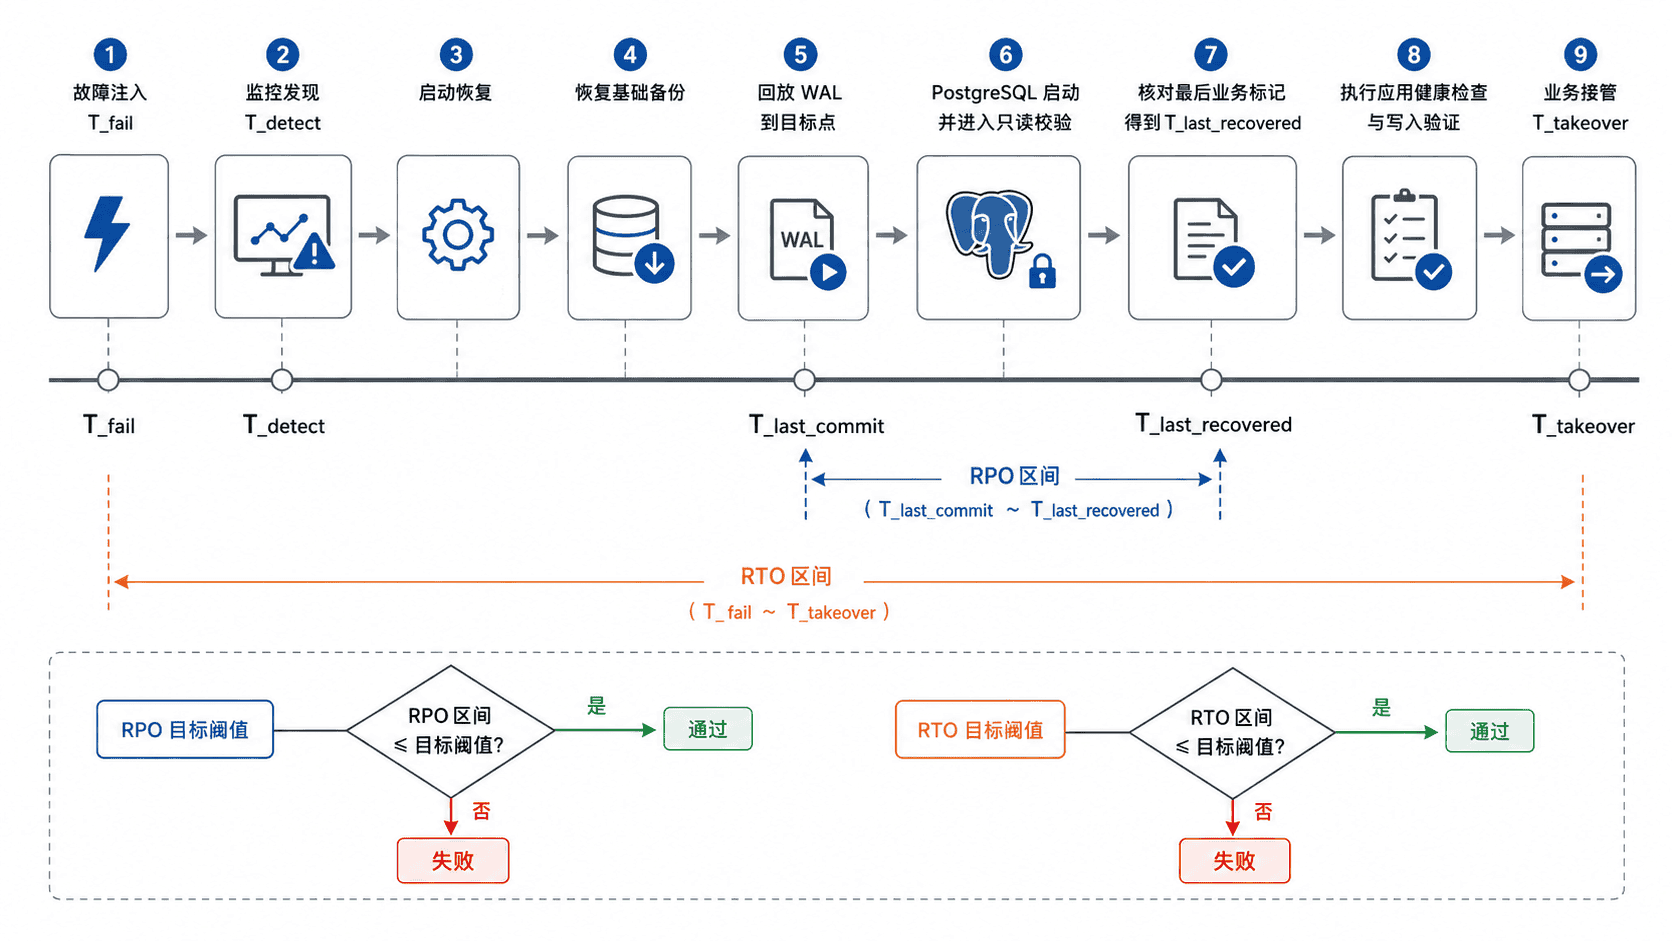
先把“恢复成功”写成可测量条件。至少记录故障发生 T_fail、首次发现 T_detect、数据库可校验 T_db_ready、业务正式接管 T_takeover 四个时间点。RTO 的终点必须是业务恢复对外服务,而不是 PostgreSQL 进程启动。
RPO 不能依赖演练开始前的一次性标记。演练期间应持续提交带唯一 ID 的探针,并在数据库之外记录每次客户端已确认成功的提交。故障前最后一条 ACK 对应 T_last_commit;恢复后查询最后可见的探针 ID,再回查该 ID 的 ACK 时间作为 T_last_recovered_commit。实际数据损失窗口为 ,实际恢复时间为 。
持续写入并记录确认提交
下面的主示例先创建探针表,再每秒提交一条记录。WITNESS_LOG 必须位于故障域之外,例如演练控制机或独立日志系统;只有 psql 成功返回后才写入 ACK,这样记录的是客户端已经确认成功的事务,而不是“尝试过写入”的时间。
export PGHOST='<HOST>'
export PGPORT='<PORT>'
export PGDATABASE='<DB_NAME>'
export PGUSER='<USER>'
export PGCONNECT_TIMEOUT=3
export WITNESS_LOG='<PATH>/dr-probe-ack.log'

mkdir -p "$(dirname "$WITNESS_LOG")"
: > "$WITNESS_LOG"

psql -X -v ON_ERROR_STOP=1 <<'SQL'
CREATE TABLE IF NOT EXISTS dr_probe (
    probe_id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    observed_at timestamptz NOT NULL DEFAULT clock_timestamp(),
    note text NOT NULL
);
SQL

while true; do
  if row=$(psql -X -qAt -v ON_ERROR_STOP=1 -c "INSERT INTO dr_probe(note) VALUES ('drill') RETURNING probe_id, observed_at;"); then
    ack_time=$(date -u +%Y-%m-%dT%H:%M:%SZ)
    printf 'ACK|%s|%s\n' "$ack_time" "$row" | tee -a "$WITNESS_LOG"
  else
    fail_time=$(date -u +%Y-%m-%dT%H:%M:%SZ)
    printf 'FAIL|%s\n' "$fail_time" | tee -a "$WITNESS_LOG"
    break
  fi
  sleep 1
done
预期输出
ACK|<TIME>|<ID>|<TIME>
ACK|<TIME>|<ID>|<TIME>
FAIL|<TIME>
实际时间和 ID 会不同。演练控制端应在注入故障的瞬间独立记录 T_fail;FAIL 只是探针首次写入失败的时间,不能自动替代故障发生时间。若探针要代表真实业务,应沿用相同的数据库、连接路径和事务提交策略,或直接使用可审计的订单号、流水号等真实业务确认点。
执行恢复并定位最后恢复点
按恢复 SOP 选择基础备份和所需 WAL,配置恢复目标并启动 PostgreSQL。实例可连接后记录 T_db_ready,然后查询恢复后最后一条可见探针,同时从见证日志中找出故障前最后一次成功确认和该探针对应的确认记录。
pg_isready -h "$PGHOST" -p "$PGPORT" -d "$PGDATABASE"

recovered_id=$(psql -X -qAt -h "$PGHOST" -p "$PGPORT" -d "$PGDATABASE" -c "SELECT probe_id FROM dr_probe ORDER BY probe_id DESC LIMIT 1;")
last_ack=$(grep '^ACK|' "$WITNESS_LOG" | tail -n 1)
recovered_ack=$(awk -F'|' -v id="$recovered_id" '$1=="ACK" && $3==id {line=$0} END {print line}' "$WITNESS_LOG")

printf 'recovered_id=%s\nlast_ack=%s\nrecovered_ack=%s\n' "$recovered_id" "$last_ack" "$recovered_ack"
预期输出
<HOST>:<PORT> - accepting connections
recovered_id=<ID>
last_ack=ACK|<TIME>|<ID>|<TIME>
recovered_ack=ACK|<TIME>|<ID>|<TIME>
last_ack 的客户端确认时间就是 T_last_commit,recovered_ack 的确认时间就是 T_last_recovered_commit。如果两者 ID 相同,本次探针观测到的 RPO 为 0;如果不同,则用两条 ACK 的客户端确认时间差计算数据损失窗口,并同时记录丢失的探针条数。若 recovered_ack 为空,说明恢复结果早于当前见证日志覆盖范围,不能据此宣称 RPO 达标。
计算指标并完成业务验收
所有计时时钟应同步,并统一使用 UTC 或明确时区。若目标是 RPO <= 5 分钟、RTO <= 30 分钟,按同一套口径比较:
| 指标 | 实际值 | 目标 | 通过条件 |
|---|---|---|---|
| RPO | T_last_commit - T_last_recovered_commit |
5 分钟 | 实际值不大于目标 |
| RTO | T_takeover - T_fail |
30 分钟 | 实际值不大于目标 |
数据库可连接并不代表业务已经恢复。接管前至少完成关键一致性查询、只读业务检查和一次受控写入,确认应用连接、权限、缓存或依赖服务均正常后再记录 T_takeover。如果数据库 18 分钟可用,但应用直到 34 分钟才恢复健康检查和写入,那么本次 RTO 是 34 分钟。
用演练证据修订恢复方案
演练记录至少保留故障类型、参与人、关键时间点、见证日志、实际 RPO/RTO、基础备份与 WAL 范围、失败步骤、人工介入点和最终业务验收结果。若 RPO 超标,优先检查 WAL 归档延迟、归档缺口、恢复目标和事务提交确认策略;若 RTO 超标,则按备份获取、解压、WAL 回放、实例启动、数据校验和应用切换拆分耗时。
一次有效演练的产物不是“恢复成功”四个字,而是一组可重复核对的时间证据和改进项。只有后续演练仍能按相同口径测量,并稳定满足既定 RPO/RTO,备份与 PITR 方案才真正具备可运营性。