
PostgreSQL / 系统课时
从主机丢失恢复整个集群
从主机丢失恢复整个集群
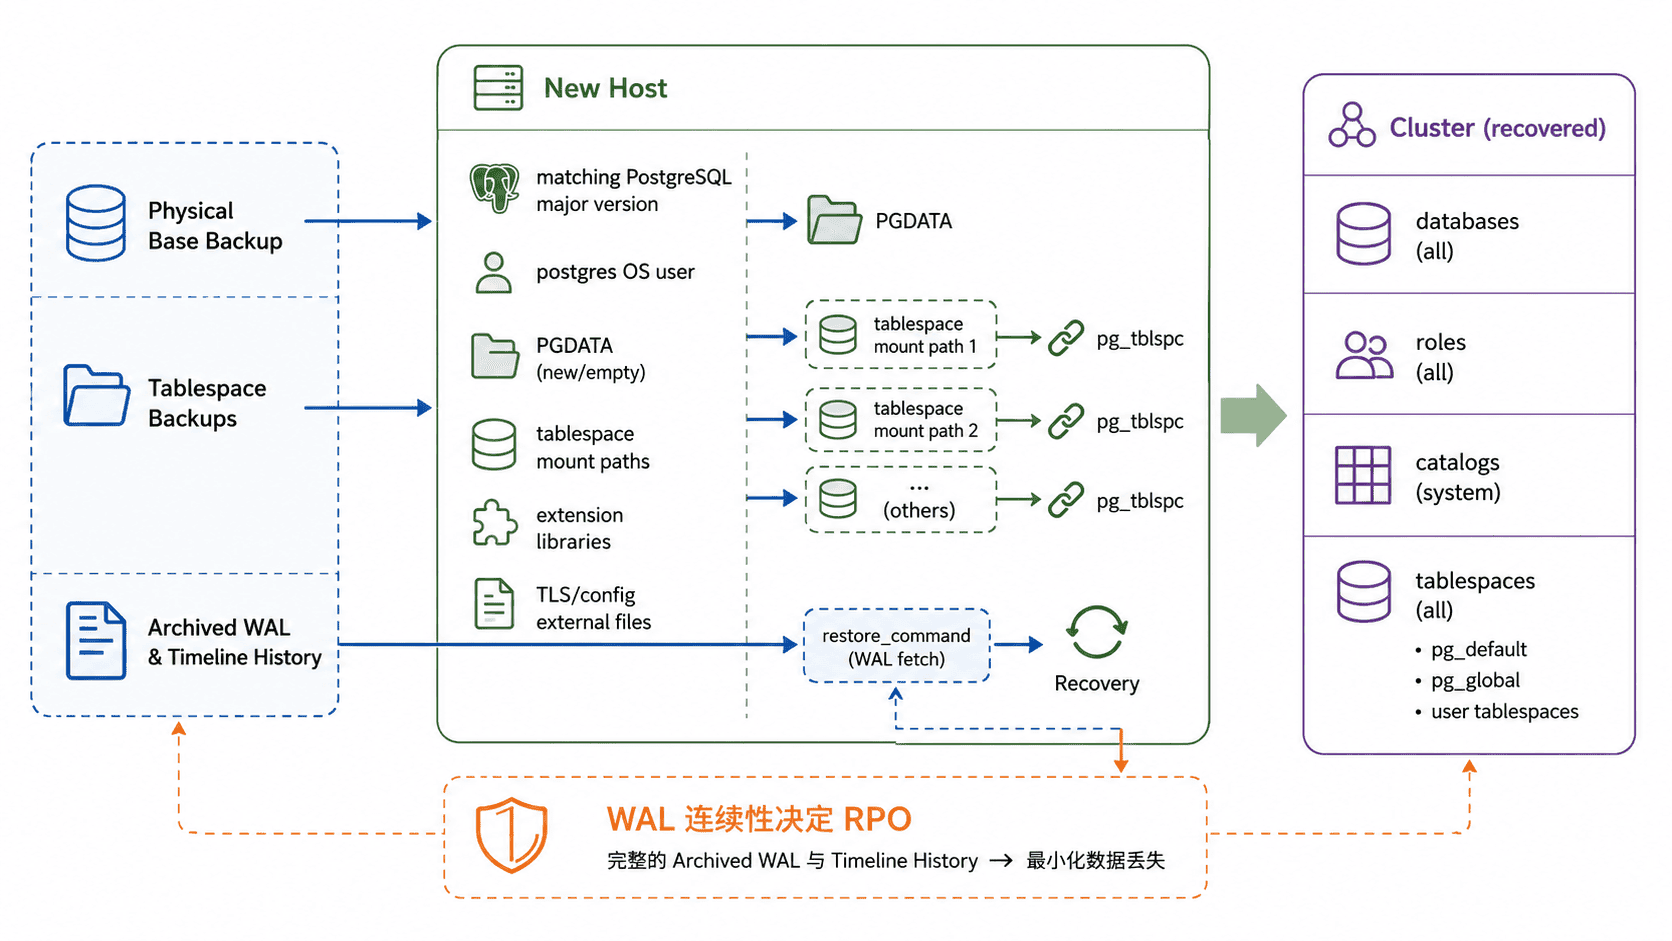
主机彻底丢失时,恢复对象不是单个数据库,而是整个 PostgreSQL 集群。目标是在新主机上恢复 PGDATA 与表空间,先清除物理备份可能携带的旧备用库配置,再仅通过归档 WAL 回放到连续可恢复的末端,最后完成集群级验收。
学习目标
- 核对整集群物理恢复所需的版本、目录和外部依赖
- 还原
PGDATA与表空间,并确认旧备用库配置已被彻底清除 - 使用归档 WAL 完成恢复,并验证数据库、角色、扩展与业务读写
先确认物理恢复前提
以下流程按 PostgreSQL 12 及以上版本的 recovery.signal 机制说明。新主机必须安装与基础备份相同的 PostgreSQL 主版本,并准备兼容的操作系统、架构和扩展动态库。基础备份与归档 WAL 必须来自同一恢复链,且从备份所需的起始 WAL 开始连续可用。
还要核对不一定包含在 PGDATA 中的依赖,例如 TLS 证书、shared_preload_libraries 对应库、外部 include 配置、归档脚本、密钥文件和表空间挂载。缺少这些内容时,数据文件即使完整,实例也可能无法启动或与原集群行为不一致。
还原数据并清除旧备用库状态
物理备份可能来自曾经的备用库,因此不能把备份复制到新主机后就直接创建 recovery.signal。必须先移除 standby.signal、旧 recovery.signal,并清理 primary_conninfo、primary_slot_name、旧 restore_command 和 recovery_target_*;否则新主机可能重新连接已经失效的主库或复制槽。
下面把文件还原、旧配置审计、本次归档恢复配置、启动和基础验收串成一个主流程。目标目录必须专用于本次恢复;若有多个表空间,需要按各自 OID 重复表空间复制与符号链接步骤。
set -euo pipefail

PGDATA="<PGDATA>"
BASE_BACKUP_DIR="<BASE_BACKUP_DIR>"
TABLESPACE_PATH="<TABLESPACE_PATH>"
TABLESPACE_BACKUP_DIR="<TABLESPACE_BACKUP_DIR>"
TABLESPACE_OID="<TABLESPACE_OID>"
WAL_ARCHIVE_DIR="<WAL_ARCHIVE_DIR>"
RECOVERY_LOG="<RECOVERY_LOG>"
PORT="<PORT>"

sudo install -d -o postgres -g postgres -m 0700 "$PGDATA"
sudo rsync -aHAX --delete "$BASE_BACKUP_DIR"/ "$PGDATA"/
sudo chown -R postgres:postgres "$PGDATA"

sudo install -d -o postgres -g postgres -m 0700 "$TABLESPACE_PATH"
sudo rsync -aHAX --delete "$TABLESPACE_BACKUP_DIR"/ "$TABLESPACE_PATH"/
sudo chown -R postgres:postgres "$TABLESPACE_PATH"
sudo -u postgres rm -f "$PGDATA/pg_tblspc/$TABLESPACE_OID"
sudo -u postgres ln -s "$TABLESPACE_PATH" "$PGDATA/pg_tblspc/$TABLESPACE_OID"

# 先清除备份中可能遗留的备用库/旧恢复信号和自动配置。
sudo -u postgres rm -f "$PGDATA/standby.signal" "$PGDATA/recovery.signal"
sudo -u postgres sed -Ei '/^[[:space:]]*(primary_conninfo|primary_slot_name|restore_command|archive_cleanup_command|recovery_target(_[a-z_]+)?)[[:space:]]*=/d' "$PGDATA/postgresql.auto.conf"

PRIMARY_CONNINFO="$(sudo -u postgres postgres -D "$PGDATA" -C primary_conninfo)"
PRIMARY_SLOT_NAME="$(sudo -u postgres postgres -D "$PGDATA" -C primary_slot_name)"
if [ -n "$PRIMARY_CONNINFO" ] || [ -n "$PRIMARY_SLOT_NAME" ]; then
  echo "旧备用库配置仍从 postgresql.conf 或 include 文件生效" >&2
  exit 1
fi

sudo -u postgres tee -a "$PGDATA/postgresql.auto.conf" >/dev/null <<EOF
restore_command = 'cp "$WAL_ARCHIVE_DIR/%f" "%p"'
recovery_target_timeline = 'latest'
port = $PORT
EOF

sudo -u postgres touch "$PGDATA/recovery.signal"
sudo -u postgres pg_ctl -D "$PGDATA" -l "$RECOVERY_LOG" start

sudo -u postgres psql -p "$PORT" -d postgres -At <<'SQL'
SELECT 'recovery=' || CASE WHEN pg_is_in_recovery() THEN 'true' ELSE 'false' END;
SELECT 'db=' || datname FROM pg_database WHERE datallowconn ORDER BY datname;
SELECT 'tablespace=' || spcname || '=' || pg_tablespace_location(oid)
FROM pg_tablespace
ORDER BY spcname;
SQL
预期输出
waiting for server to start.... done
server started
recovery=false
db=<DATABASE_NAME>
db=<DATABASE_NAME>
tablespace=pg_default=
tablespace=pg_global=
tablespace=<TABLESPACE_NAME>=<TABLESPACE_PATH>
实际数据库名、表空间名和路径会因环境而不同。若脚本在旧备用库配置检查处退出,应继续沿 postgresql.conf 的 include 或 include_dir 查找并删除来源,而不是绕过检查;postgres -C 读取的是最终生效值,因此也能暴露外部包含文件中的残留配置。
理解归档恢复的结束位置
这里只创建 recovery.signal,不创建 standby.signal,也不设置时间、LSN 或事务恢复目标。PostgreSQL 会从基础备份要求的位置开始读取 WAL,并沿 recovery_target_timeline = 'latest' 回放到当前恢复链中连续可用的末端,然后退出恢复模式。
归档链中间若缺少必需 WAL,继续回放会被阻断;原主机损坏前尚未归档、且其他副本也未保存的尾部 WAL,则已经超出当前备份体系的 RPO,无法凭现有基础备份与归档重新构造。
完成集群级验收
recovery=false 只说明实例已经退出恢复,不代表灾备完成。还要核对关键角色能否登录、shared_preload_libraries 和业务扩展能否加载、表空间是否落在预期挂载点,并分别执行应用只读查询与受控写事务。
最后重新启用备份、归档和监控任务,并确认新生成的 WAL 能进入新的归档链。只有数据对象、外部依赖、业务读写以及后续备份链都通过验证,整个集群恢复才算完成。