
PostgreSQL / 系统课时
理解 WAL、LSN 与检查点
理解 WAL、LSN 与检查点
这一课把 WAL、LSN、检查点和数据文件放进同一条恢复链路:你会看清“先记日志、后落数据页”的约束,理解检查点如何限定崩溃恢复的起始边界,以及基础备份为什么必须配合连续 WAL 才能恢复到目标位置。
学习目标
- 解释 WAL 与数据页落盘之间的先后关系,以及它如何支撑崩溃恢复。
- 区分 LSN、WAL 段文件与事务 ID,能用 LSN 描述日志位置和推进量。
- 说明检查点、基础备份与 WAL 重放在 PITR 恢复链路中的不同职责。
把恢复链路连起来
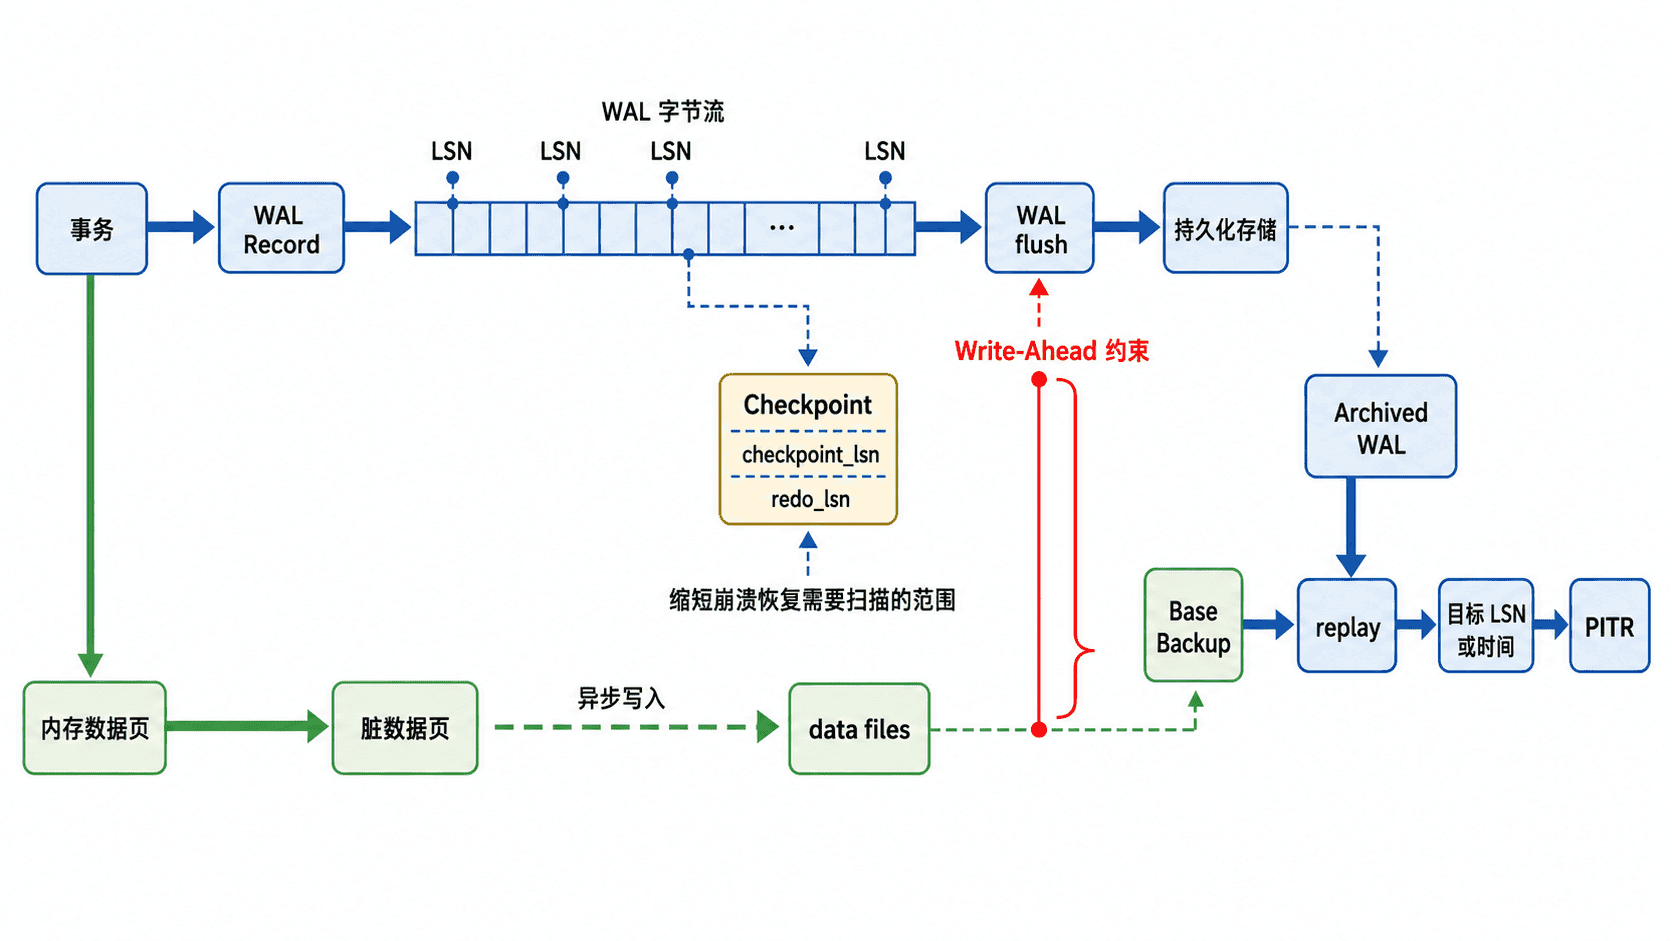
PostgreSQL 修改表或索引页时,不要求每次提交都立即把所有脏页写回数据文件。关键约束是 Write-Ahead Logging:描述修改的 WAL 必须先于对应数据页写入持久化存储;事务需要持久化提交时,还必须先保证相关 WAL 已可靠刷盘。数据页可以稍后写回,因此主机异常中断后,即使磁盘上的页面落后,也能通过 WAL 重做尚未反映到数据文件中的变更。
LSN(Log Sequence Number)是 WAL 字节流中的位置标记。恢复过程按 WAL 顺序推进,所以“恢复进行到哪里”可以用当前已重放到的 LSN 表达。WAL 段文件则是这条连续字节流的物理切片;初始化集群时默认段大小通常为 16 MiB,也可以在创建集群时选择其他受支持的段大小。
检查点提供可定位的恢复基线。检查点完成时,PostgreSQL 已完成该检查点要求的数据页持久化,并记录检查点及 REDO 起点等控制信息。崩溃恢复时会定位最近可用检查点,再根据其中的 REDO 位置开始重放,而不是简单地从检查点记录自身所在的 LSN 开始。
用 LSN 观察 WAL 前进
LSN 不是时间戳,也不是事务 ID。它的文本形式类似 0/16B6C50,可以转换为 pg_lsn 比较大小,也可以对两个 LSN 做减法计算它们之间相隔的 WAL 字节数。事务 ID 服务于事务可见性等机制,业务时间用于表达时间目标,都不能替代 LSN 对 WAL 物理位置的描述。
下面的实验应在可丢弃的测试数据库中通过 psql 执行。先保存当前 WAL 插入位置,再创建并写入一张普通表,最后比较前后两个 LSN;整个实验放在事务中并回滚,避免留下测试表。
BEGIN;

SELECT pg_current_wal_insert_lsn() AS before_lsn \gset

CREATE TABLE wal_probe (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    payload text NOT NULL
);

INSERT INTO wal_probe(payload)
SELECT repeat(md5(g::text), 4)
FROM generate_series(1, 2000) AS g;

WITH current_position AS (
    SELECT pg_current_wal_insert_lsn() AS after_lsn
)
SELECT :'before_lsn'::pg_lsn AS before_lsn,
       after_lsn,
       after_lsn - :'before_lsn'::pg_lsn AS wal_bytes
FROM current_position;

ROLLBACK;预期输出中,after_lsn 应大于 before_lsn,wal_bytes 为正值。具体 LSN 和字节数取决于版本、页面状态以及同时发生的其他数据库活动。
BEGIN
CREATE TABLE
INSERT 0 2000
 before_lsn  | after_lsn   | wal_bytes
-------------+-------------+-----------
 <LSN_BEFORE> | <LSN_AFTER> | <VALUE>
(1 row)

ROLLBACK
这个差值表示整个集群 WAL 插入位置在实验期间推进的字节量,不等于这张表的文件增长量,也不能严格视为当前会话独占产生的 WAL。一次逻辑修改可能产生多类 WAL 记录,还可能写入 full-page image;并发会话也可能同时推进 WAL。
检查点决定 REDO 从哪里开始
可以在测试或受控运维场景中强制执行一次检查点,再读取控制信息中的 checkpoint_lsn 与 redo_lsn。CHECKPOINT 会主动推动脏页写出并造成额外 I/O,不应为了“让数据更安全”而在正常业务中频繁手工执行;执行账号需要具备执行检查点所需的权限。
CHECKPOINT;

SELECT checkpoint_lsn,
       redo_lsn,
       redo_wal_file,
       checkpoint_time
FROM pg_control_checkpoint();
预期输出会显示最新检查点记录的位置、REDO 起点、对应 WAL 文件和检查点时间;这些字段均为运行时动态值。
CHECKPOINT
 checkpoint_lsn | redo_lsn | redo_wal_file | checkpoint_time
----------------+----------+---------------+-----------------
 <LSN>          | <LSN>    | <WAL_FILE>    | <TIME>
(1 row)
checkpoint_lsn 表示检查点记录自身在 WAL 中的位置,redo_lsn 则表示从这个检查点恢复时可能需要开始重做的位置,因此后者可能早于前者。更频繁的检查点通常可以缩短崩溃恢复需要扫描和重放的 WAL 区间,但会增加检查点写盘压力;间隔更长则减少检查点频率,却可能让恢复阶段需要处理更多 WAL。
基础备份为什么离不开 WAL
物理基础备份提供可恢复的数据文件基线,但在线备份期间数据库仍然可能持续写入,不同数据文件也不会在同一个瞬间被复制。因此恢复时必须取得这份基础备份所要求的 WAL,并从备份元数据和控制信息确定的正确位置连续重放,才能重新形成一致的数据库状态。
PITR 在此基础上继续向前:先还原基础备份,再通过 restore_command 等机制取得归档 WAL,按顺序重放到指定时间、LSN、事务 ID 或命名恢复点。只保留基础备份而丢失恢复区间所需 WAL,或者归档 WAL 中间缺少必要段,恢复链都会在缺口处中断。
因此可以把恢复模型记成一句话:基础备份给出物理起点,检查点和备份控制信息确定恢复所需的 REDO 边界,LSN 标识 WAL 顺序,连续 WAL 再把数据库推进到目标状态。