
PostgreSQL / 系统课时
回退破坏性数据库发布
回退破坏性数据库发布
错误 DDL、批量脚本或迁移任务已经落库后,关键不是“恢复最新备份”,而是把数据库停在第一笔有害事务生效之前,并确保恢复副本不会继续连接旧主库或被同一发布再次改坏。本篇用隔离 PITR 实例完成边界选择、恢复、验证与切换判断。
学习目标
- 根据错误变更的事务边界选择可验证的 PITR 目标
- 清理基础备份中的旧待机配置,并在隔离实例执行目标恢复
- 判断应整体回退,还是仅从恢复副本选择性取回数据
先确定最后正确状态
破坏性发布常同时包含 DDL、数据迁移和应用写入。PITR 会把整个集群恢复到一个历史点,因此目标不应简单取“发布时间”,而应落在第一笔有害事务提交之前。若迁移分成多个事务,边界必须早于其中最早的破坏性提交。
| 场景 | 更合适的恢复边界 | 关键代价 |
|---|---|---|
| 单事务 DDL 或迁移 | 错误事务提交前 | 目标之后的合法写入也会丢失 |
| 多事务批处理 | 第一笔有害事务之前 | 需要确认最早受影响事务 |
| 错误发布后仍有大量合法业务写入 | 恢复隔离副本,再选择性修复生产库 | 不适合直接整体回退 |
如果发布前调用过 pg_create_restore_point(),优先记录并使用命名恢复点;否则可结合数据库日志、发布流水线和业务审计确定 recovery_target_time。时间目标必须携带明确时区,避免发布系统与数据库服务器时区不同导致边界偏移。
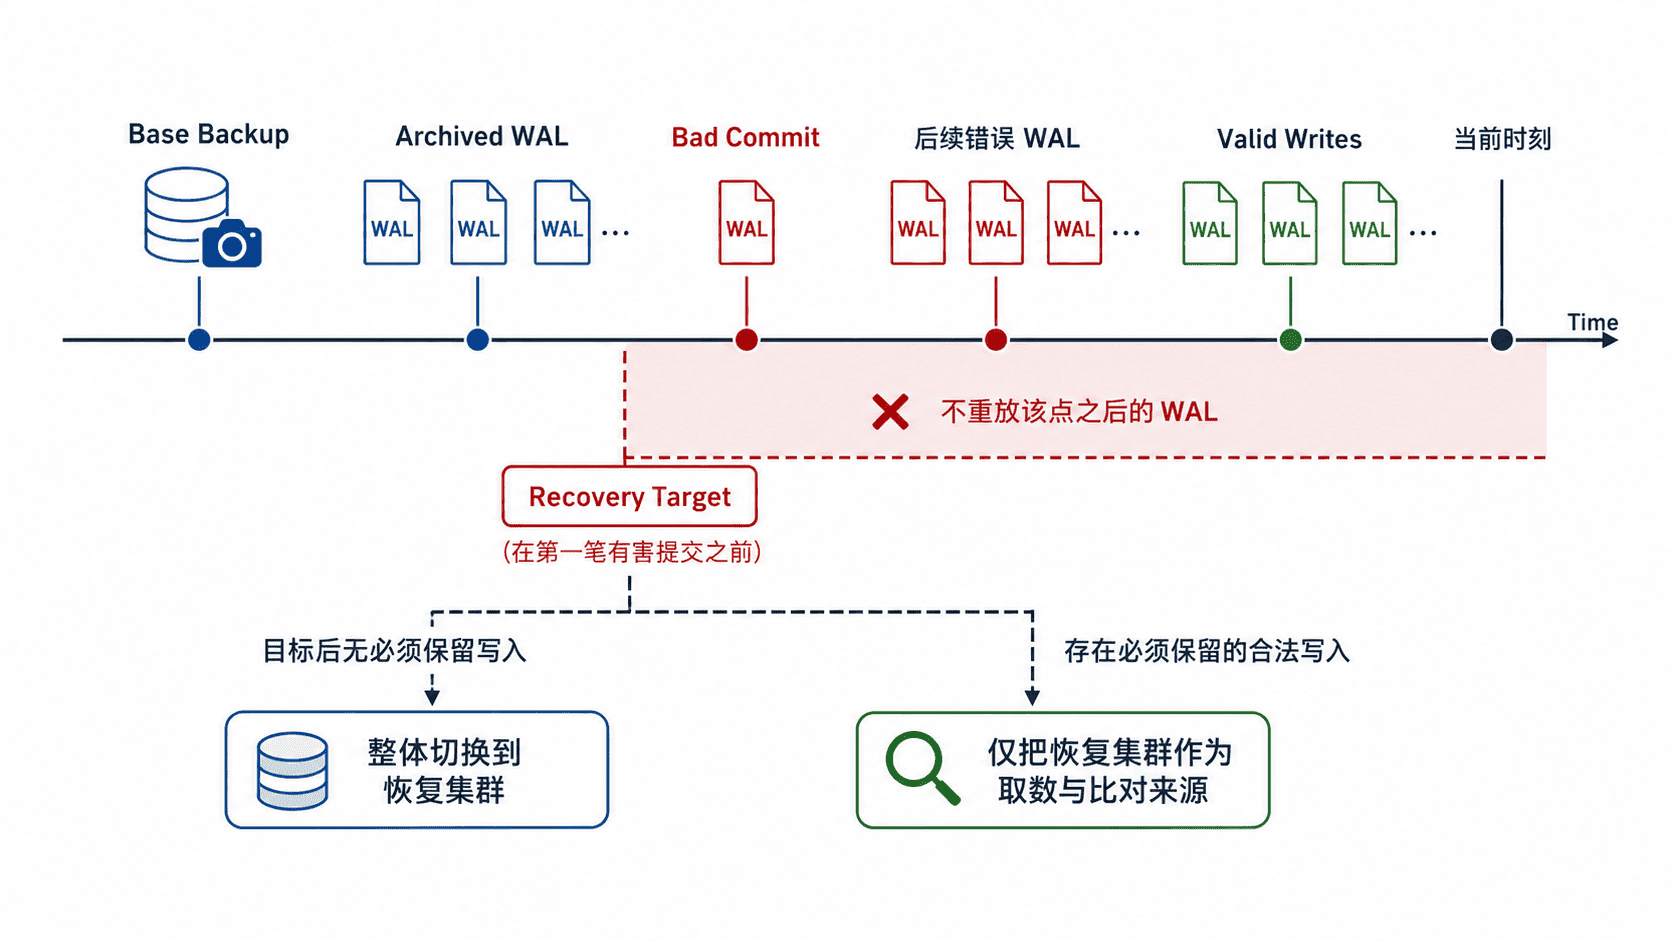
在隔离实例执行目标恢复
下面假设已有一份早于错误发布的物理基础备份,并且归档 WAL 连续覆盖到目标时间。恢复目录必须与生产 PGDATA 隔离,PostgreSQL 主版本与备份一致;若使用独立表空间,也要恢复或映射到隔离路径,不能继续指向生产目录。
基础备份如果由 pg_basebackup -R 等方式生成,可能包含 standby.signal,并在 postgresql.auto.conf 中留下 primary_conninfo、primary_slot_name。若直接启动,这些配置会把恢复副本带回旧的待机语义,甚至再次连接原上游。因此应先清理旧信号文件和旧流复制参数,再写入本次 PITR 配置。
sudo -u postgres rsync -aHAX <BASE_BACKUP_DIR>/ <PGDATA_RECOVERY>/

# 只处理隔离恢复目录:先删除旧 standby/recovery 信号文件。
sudo -u postgres rm -f <PGDATA_RECOVERY>/standby.signal <PGDATA_RECOVERY>/recovery.signal
sudo -u postgres touch <PGDATA_RECOVERY>/postgresql.auto.conf

# pg_basebackup -R 会把连接信息写入 auto.conf;同时清理旧恢复目标,避免覆盖本次配置。
sudo -u postgres sed -i -E '/^[[:space:]]*(primary_conninfo|primary_slot_name|restore_command|recovery_target_[[:alnum:]_]+)[[:space:]]*=/d' <PGDATA_RECOVERY>/postgresql.auto.conf

sudo -u postgres tee -a <PGDATA_RECOVERY>/postgresql.auto.conf >/dev/null <<'EOF'
restore_command = 'cp <WAL_ARCHIVE_DIR>/%f %p'
recovery_target_time = '<TARGET_TIME_WITH_TIMEZONE>'
recovery_target_inclusive = false
recovery_target_action = 'promote'
listen_addresses = '127.0.0.1'
archive_mode = off
port = <PORT>
EOF

# 只创建 recovery.signal:执行一次性归档恢复,而不是持续作为 standby 追随旧主库。
sudo -u postgres touch <PGDATA_RECOVERY>/recovery.signal
sudo -u postgres pg_ctl -D <PGDATA_RECOVERY> -l <RECOVERY_LOG> start
预期输出
waiting for server to start.... done
server started
recovery_target_inclusive = false 表示当时间目标恰好落在某笔事务提交点时,不把该目标事务包含进恢复结果。archive_mode = off 可避免提升后的隔离实例继续向原归档目标写入新时间线。若环境通过 include 或自定义配置文件设置过 primary_conninfo、primary_slot_name 等参数,也应同步检查并移除;上述清理只覆盖 postgresql.auto.conf。路径、端口和目标时间均为占位符,实际值按环境替换。
验证恢复边界
pg_ctl start 只说明服务进程已经启动,不代表目标恢复已经完成。等待恢复日志确认已到达目标并执行提升后,再验证实例已经退出恢复状态。
sudo -u postgres psql -p <PORT> -d postgres -Atc "SELECT pg_is_in_recovery();"预期输出
f随后按本次发布的验收清单反向核对:错误新增或修改的对象应回到发布前状态,被误删的数据应重新出现,迁移脚本产生的错误标记不应存在。若 WAL 归档存在缺口,实例可能无法到达配置的恢复目标,此时不能把“数据库进程启动过”当作恢复成功。
防止同一发布再次破坏恢复结果
数据库恢复正确后,发布系统也必须回到安全状态。停用会自动执行迁移的应用版本、Job 或 CI/CD 步骤,并确认启动流程不会再次运行同一批 DDL。只有数据库状态、应用版本和迁移状态形成兼容组合后,才考虑切流。
切换前保留原故障集群或快照作为证据和补数来源,不要因恢复副本验证通过就立即销毁。对高风险发布,在变更前创建命名恢复点并记录发布批次,可以把事故中的“猜时间”变成按已知边界恢复。