
PostgreSQL / 系统课时
区分逻辑、物理与连续归档备份
区分逻辑、物理与连续归档备份
这篇解决一个常见误区:把 pg_dump、物理基础备份和 WAL 归档都叫“备份”,却默认它们能完成同一种恢复。你会建立三者的恢复边界,并知道做对象级恢复、整库恢复和 PITR 时分别需要什么。
学习目标
- 说清逻辑备份、物理基础备份与 WAL 连续归档各自保存的内容
- 判断三种手段能恢复到什么粒度、什么时间点
- 识别“有备份文件但仍无法 PITR”的典型缺口
三类备份解决的是不同问题
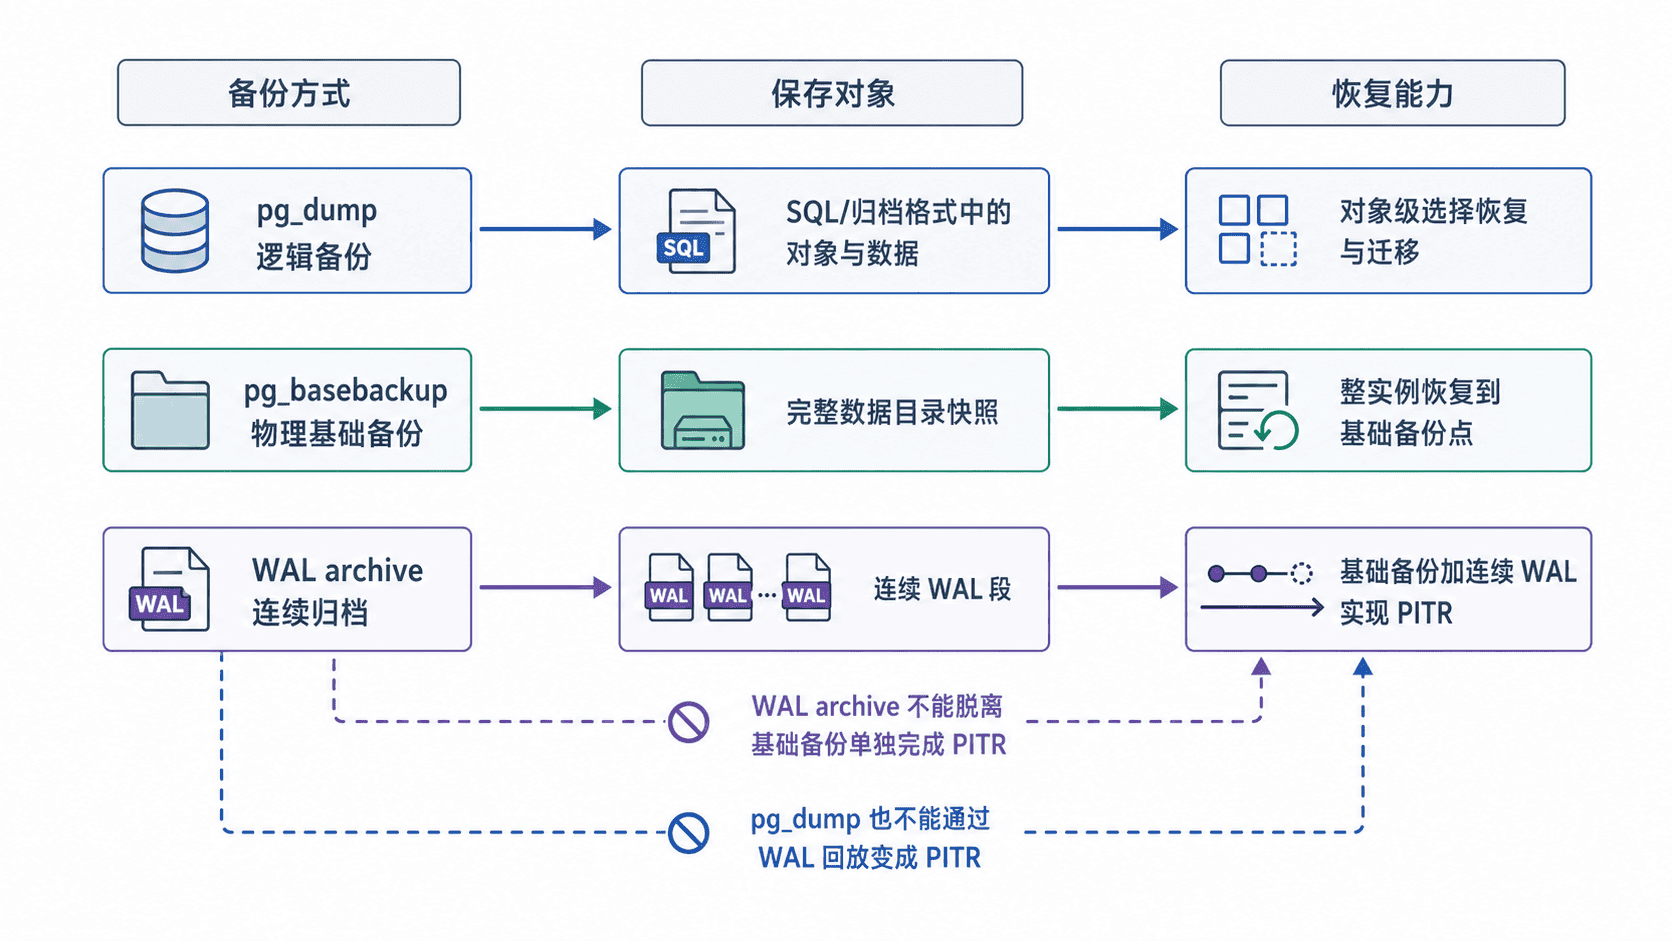
pg_dump 是逻辑备份:它读取数据库对象和数据,生成可由 pg_restore 或 psql 重建的逻辑内容。它适合迁移、选择性恢复表或 schema,也常用于跨 PostgreSQL 版本迁移,但它不是数据目录的字节级副本。
物理基础备份保存 PostgreSQL 集群的数据文件,例如使用 pg_basebackup 得到一套可用于实例级恢复的数据目录。它面向“把整个实例恢复起来”,要求目标服务器能够读取该备份的物理格式,不能像逻辑备份那样直接挑一张表恢复。
WAL 连续归档持续保存数据库产生的 WAL 段。它不能替代基础备份,而是与物理基础备份配合,把恢复终点推进到更晚的时间、事务或恢复点,因此是 PITR 的关键组成部分。
PITR 为什么必须组合基础备份与 WAL
PITR 的起点是一份可恢复的物理基础备份,恢复过程再按顺序重放它所需要的 WAL,并继续重放归档中的后续 WAL。只有 WAL 而没有匹配的基础备份,恢复进程没有一致的数据文件起点;只有基础备份而缺少目标时间点之前所需的后续 WAL,也无法推进到该目标。
因此,“每天做一次 pg_dump 并持续归档 WAL”并不会自动得到 PITR。逻辑 dump 不是 WAL 重放所需的物理起点。真正的 PITR 组合应是物理基础备份 + 从该备份所需位置开始连续、可读取的 WAL。
用命令验证逻辑备份能力
下面示例假设本机已有可连接的 appdb,当前用户拥有读取所需对象的权限。它创建 custom 格式逻辑备份,并用文件非空检查确认命令成功产出备份文件。
pg_dump --dbname=appdb --format=custom --file=appdb.dump
test -s appdb.dump && echo "logical backup created"
预期输出
logical backup created这个结果只证明逻辑备份文件已生成,不代表已经具备整实例恢复或 PITR 能力。若还要保存角色、表空间等集群级全局对象,需要另行使用 pg_dumpall --globals-only 等方式。
物理基础备份通常由 pg_basebackup 或专用备份工具生成;连续归档则由 archive_mode 配合 archive_command、archive_library 或备份系统持续保存 WAL。验证这两类能力时,应检查基础备份是否可恢复,以及从该备份所需位置开始的 WAL 是否连续可读,而不是只看归档目录里“有文件”。
按恢复目标选择手段
需要恢复单表、单 schema,或进行逻辑迁移时,优先考虑 pg_dump/pg_restore。需要整实例快速重建时,物理基础备份通常更合适。需要把数据库恢复到故障前某个时间点时,则必须规划物理基础备份与连续 WAL 归档。
生产方案往往同时保留两类能力:物理备份与 WAL 负责灾难恢复和 PITR,逻辑备份用于对象级导出、迁移或额外保险。判断备份是否“够用”时,不要问文件有多少,而要先问目标恢复粒度、目标时间点以及允许的数据丢失窗口。