
PostgreSQL / 系统课时
执行并控制 PITR 恢复
执行并控制 PITR 恢复
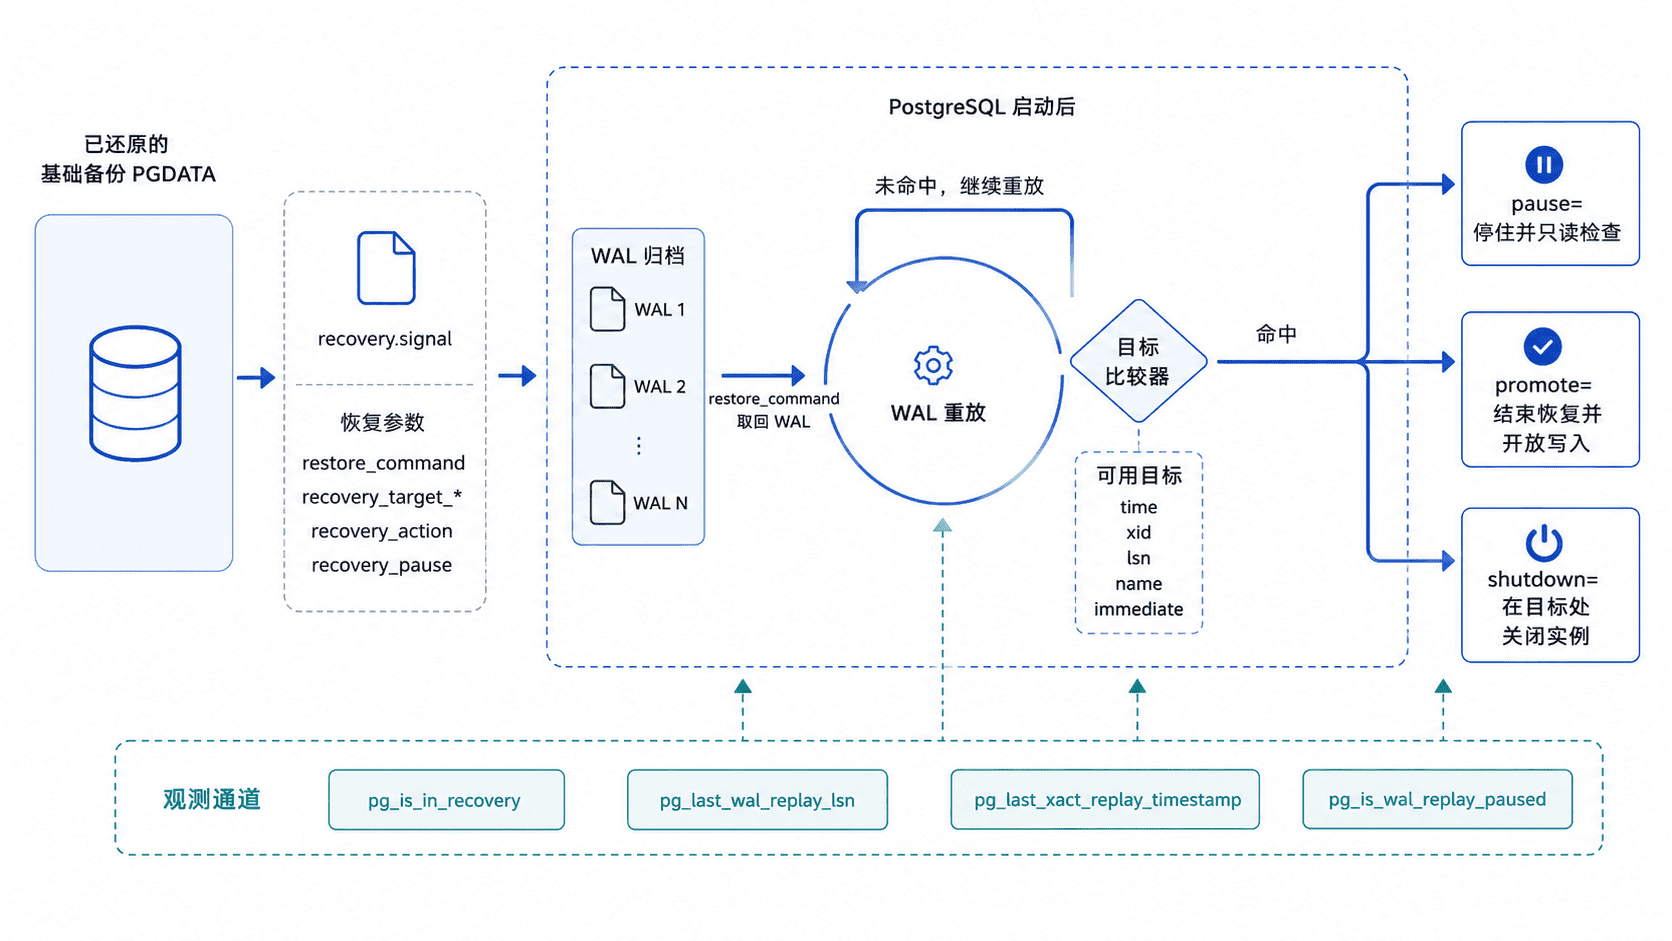
完成目标选择后,PITR 的执行可以归纳为还原基础备份、进入归档恢复、持续重放 WAL、在目标点执行指定动作并验收结果。本课给出一条可重复执行的路径,并重点避免旧恢复目标残留导致的多目标冲突。
学习目标
- 配置
recovery.signal、restore_command、唯一恢复目标与recovery_target_action。 - 观察 WAL 重放位置,并确认目标是否真正进入暂停状态。
- 正确处理
pause、promote、shutdown,完成恢复后的业务验收。
启动前固定恢复副本
PITR 应在从基础备份还原出的独立数据目录上执行,不要直接在事故现场的数据目录反复试错。启动前确认 PostgreSQL 已停止、基础备份早于目标点、目录权限正确,并且 WAL 归档连续覆盖到目标位置。
恢复副本还要清理上一轮的目标设置。同一次恢复只能使用 recovery_target_time、recovery_target_xid、recovery_target_lsn、recovery_target_name 或 recovery_target = 'immediate' 中的一种。若是再次从既有时间线做 PITR,还要检查 recovery_target_timeline 是否符合预期;现代版本默认选择可达的最新时间线。
配置并启动恢复
下面以时间目标和 pause 动作为主示例。请以 PostgreSQL 操作系统账号执行,并确认实例已经停止。脚本会先从 postgresql.auto.conf 删除上一轮 PITR 可能留下的恢复命令、目标参数和本例覆盖的热备设置,再写入本次配置,因此重复执行不会持续堆叠旧目标。
set -euo pipefail
umask 077

export PGDATA="<PATH>"
AUTO_CONF="$PGDATA/postgresql.auto.conf"
TMP_CONF="$PGDATA/postgresql.auto.conf.pitr-tmp"

touch "$AUTO_CONF"

# 先移除旧 PITR 设置,避免 time/xid/lsn/name 等目标同时生效。
awk '
  !/^[[:space:]]*(restore_command|hot_standby|recovery_target|recovery_target_(time|xid|lsn|name|inclusive|action|timeline))[[:space:]]*=/
' "$AUTO_CONF" > "$TMP_CONF"
mv "$TMP_CONF" "$AUTO_CONF"

touch "$PGDATA/recovery.signal"

cat >> "$AUTO_CONF" <<'EOF'
restore_command = 'cp <PATH>/%f %p'
recovery_target_time = '<TIME>'
recovery_target_inclusive = 'off'
recovery_target_action = 'pause'
hot_standby = 'on'
EOF

pg_ctl -D "$PGDATA" -l "<PATH>" start
预期输出
waiting for server to start.... done
server started
三个 <PATH> 分别替换为数据目录、WAL 归档目录和日志文件路径,<TIME> 替换为带明确时区的目标时间。若恢复参数还存在于 postgresql.conf 或其他 include 文件中,也必须删除冲突项;只清理 postgresql.auto.conf 不能覆盖其他配置来源。改用 xid、lsn、name 或 immediate 时,应删除本例的时间目标,只保留一种目标。
recovery_target_inclusive = 'off' 表示不包含恰好位于目标边界的事务,是否关闭包含性应与前面确定的业务恢复语义一致。生产恢复期间还应限制普通应用连接,避免在验点完成前把恢复副本当作正式主库使用。
观察 WAL 重放与目标命中
启动成功只说明实例进入了恢复流程,不代表已经到达目标。开启 hot_standby 后,可以从另一个会话观察当前恢复状态、实际暂停状态、WAL 重放位置和最后一次事务重放时间。
SELECT
  pg_is_in_recovery() AS in_recovery,
  pg_get_wal_replay_pause_state() AS replay_pause_state,
  pg_last_wal_replay_lsn() AS replay_lsn,
  pg_last_xact_replay_timestamp() AS replay_time;
预期结果
 in_recovery | replay_pause_state | replay_lsn | replay_time
-------------+--------------------+------------+-------------
 t           | <STATE>            | <LSN>      | <TIME>
(1 row)
WAL 正在推进时,<STATE> 通常为 not paused,<LSN> 会继续向前;目标命中并完成暂停后,状态应为 paused。replay_time 是最后一个已重放事务的提交时间,没有可报告事务时可能为 NULL。支持 pg_get_wal_replay_pause_state() 的版本应以 paused 判断真正停止重放,而不是只看是否发出了暂停请求。
控制目标命中后的动作
recovery_target_action 决定命中目标后的行为:pause 适合人工验点;promote 会结束恢复并进入正常运行;shutdown 会在目标处关闭实例,适合先保留现场再做离线处理。若未启用 hot_standby,pause 会按 shutdown 处理,无法提供交互式只读验点。
当 pause 后确认恢复点正确,可以恢复 WAL 重放。对于由恢复目标触发的暂停,执行 pg_wal_replay_resume() 会让恢复在该目标处结束并进入正常运行,而不是继续无限越过目标。
SELECT pg_wal_replay_resume();预期结果
 pg_wal_replay_resume
----------------------

(1 row)如果验点发现当前状态太早,不要先恢复重放;应关闭实例,把目标改到更晚的位置后重新启动并继续恢复。若已经越过了真正需要的更早目标,WAL 不能倒放,必须从合适的基础备份重新构造恢复副本。
验收恢复结果与失败边界
恢复结束后,先确认实例已经离开恢复状态,再开放应用写流量。
SELECT pg_is_in_recovery() AS in_recovery;预期结果
 in_recovery
-------------
 f
(1 row)
随后执行业务级验收,例如确认误操作对象处于预期状态、关键表计数合理、应用只读检查通过。若持续报找不到 WAL,优先检查 restore_command 展开的归档路径、文件权限和归档连续性;若归档恢复在到达目标前就耗尽可用 WAL,PostgreSQL 会以致命错误停止,说明当前基础备份与 WAL 链无法覆盖该目标。
使用 shutdown 时要特别注意:该动作不会自动移除 recovery.signal。再次启动前必须修改恢复配置或手动移除恢复信号,否则实例可能再次按同一目标进入恢复并立即关机。