
PostgreSQL / 系统课时
建立备份恢复监控与告警
建立备份恢复监控与告警
备份任务显示“成功”并不代表当前仍可恢复。本篇把备份新鲜度、WAL 归档、WAL 生成、存储余量和恢复验证串成一条监控链,并同时检查恢复验证的执行结果、最近成功时间与指标完整性,让绿色状态真正表示“近期可以恢复”。
学习目标
- 区分备份任务成功与实际恢复能力,建立面向 RPO 的监控指标。
- 从 PostgreSQL 与存储侧采集归档、WAL 和容量信号。
- 为恢复验证同时监控执行结果、最近成功时间和指标缺失。
把告警对准恢复能力
监控的核心不是“有没有备份文件”,而是“当前还能不能恢复到目标时间点”。至少应覆盖五个连续环节:最近一次成功备份、WAL 是否持续归档、WAL 是否异常堆积、归档存储是否仍有余量,以及最近是否真正完成过一次恢复验证。
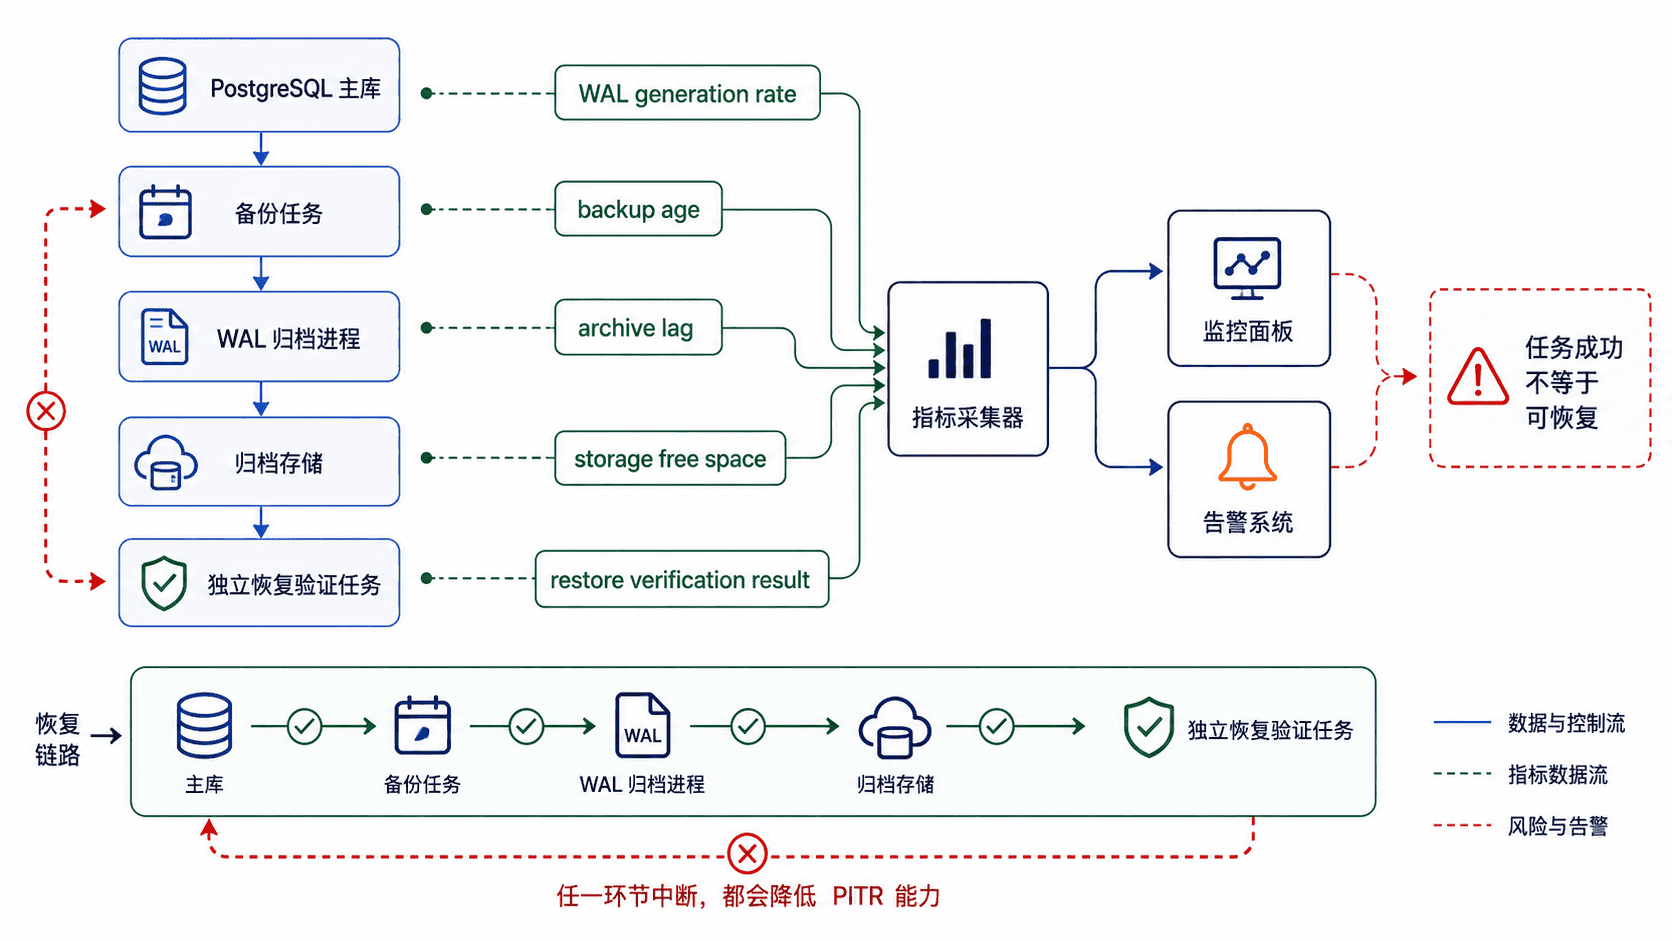
“归档延迟”必须结合 WAL 是否仍在增长判断。业务完全空闲时可能没有新的完整 WAL 段需要归档,最后归档时间自然不会推进;只有 WAL 持续产生,而成功归档时间长期不变化时,才应把它视为归档停滞。
采集归档与 WAL 信号
PostgreSQL 的统计视图可以提供归档成功、失败和 WAL 累计生成量。下面的查询适合作为 exporter 自定义采集项,也可以先用 psql 手工确认数据是否可信。
SELECT
    now() AS observed_at,
    a.archived_count,
    a.failed_count,
    a.last_archived_wal,
    a.last_archived_time,
    EXTRACT(EPOCH FROM (now() - a.last_archived_time))::bigint
        AS seconds_since_last_archive,
    w.wal_bytes
FROM pg_stat_archiver AS a
CROSS JOIN pg_stat_wal AS w;
预期结果
observed_at | archived_count | failed_count | last_archived_wal | last_archived_time | seconds_since_last_archive | wal_bytes
<TIME>      | <VALUE>        | <VALUE>      | <WAL_SEGMENT>     | <TIME>             | <VALUE>                    | <VALUE>
wal_bytes 是自相关统计重置以来的累计值,不能把单次读数直接当成生成速率。监控系统应保存连续采样,再用相邻样本计算增量速率。如果 last_archived_time 为空,应先确认实例是否刚启用归档,或尚未产生可归档的完整 WAL 段。
归档存储和本机 pg_wal 还应从操作系统侧检查容量。下面示例查看 WAL 目录大小和归档目标文件系统的剩余空间,实际路径替换为部署值。
du -sb "<PATH>/pg_wal"
df -P "<ARCHIVE_PATH>"
预期输出
<VALUE>	<PATH>/pg_wal
Filesystem  1024-blocks  Used     Available  Capacity  Mounted on
<DEVICE>    <VALUE>      <VALUE>  <VALUE>    <VALUE>%  <PATH>
如果归档目标是对象存储,就不能用本机 df 代替容量监控,应改为采集配额或容量限制、写入失败、API 错误,以及生命周期策略导致的对象过早删除等信号。
把恢复链指标变成告警
阈值应从恢复目标反推,而不是照抄固定数字。例如 RPO 为 15 分钟时,归档停滞阈值应明显小于真正不可接受的窗口,并给人工处置留出时间;完整备份的新鲜度则应根据备份周期与恢复策略单独确定。
下面是一组 Prometheus 风格的规则示例。指标名是示例契约,接入现有 exporter 时应映射为实际名称。恢复验证任务每次运行都更新 postgresql_restore_verification_success:成功为 1,失败为 0;成功时同时更新 postgresql_restore_verification_last_success_timestamp_seconds 为 Unix 时间戳。这样才能区分“刚刚验证成功”和“很久以前成功过一次”。
groups:
  - name: postgresql-recovery-readiness
    rules:
      - alert: PostgreSQLBackupTooOld
        expr: time() - postgresql_backup_last_success_timestamp_seconds > 86400
        for: 15m

      - alert: PostgreSQLArchiveFailure
        expr: increase(postgresql_archiver_failed_count_total[10m]) > 0
        for: 5m

      - alert: PostgreSQLArchiveStalled
        expr: rate(postgresql_wal_bytes_total[5m]) > 0 and on (instance) time() - postgresql_last_archived_timestamp_seconds > 600
        for: 10m

      - alert: PostgreSQLArchiveStorageLow
        expr: postgresql_archive_storage_free_ratio < 0.15
        for: 15m

      - alert: PostgreSQLRestoreVerificationFailed
        expr: postgresql_restore_verification_success == 0
        for: 5m

      - alert: PostgreSQLRestoreVerificationStale
        expr: time() - postgresql_restore_verification_last_success_timestamp_seconds > 86400
        for: 15m

      - alert: PostgreSQLRestoreVerificationMetricsMissing
        expr: absent(postgresql_restore_verification_success) or absent(postgresql_restore_verification_last_success_timestamp_seconds)
for: 15m恢复验证需要三类互补告警:Failed 发现最近一次执行明确失败,Stale 发现最近一次成功已经过旧,MetricsMissing 发现监控数据根本没有上报。只有三者同时存在,才不会因为一个长期保持为 1 的旧成功结果而永久显示绿色。
示例中的 86400 代表一天,仅用于说明规则形式。若要求每天至少成功恢复一次,应结合任务调度时间、允许延迟和人工处置窗口设定阈值;如果恢复演练周期是每周,则应相应调整,而不是机械沿用一天。
验证告警真的能发现不可恢复状态
配置完成后,先检查规则语法,再做受控故障演练。Prometheus 环境可以用 promtool 验证规则文件,避免 YAML 或 PromQL 错误导致整组告警未加载。
promtool check rules <PATH>/postgresql-recovery-readiness.yml预期输出
Checking <PATH>/postgresql-recovery-readiness.yml
  SUCCESS: <VALUE> rules found
真正的验收至少应覆盖四类场景:阻断归档目标写入,确认归档失败或停滞告警出现;把归档存储压到预警阈值,确认容量告警出现;让恢复验证任务执行失败,确认失败告警出现;最后分别停止上报恢复验证指标,以及把最近成功时间推进到阈值之外,确认缺失和过期告警都能触发。演练结束后恢复现场,并确认告警能够自动恢复。
最终需要盯住的不是某一个绿色指标,而是一条完整恢复链:有足够新的基线备份、有连续 WAL、有可用存储,并且最近确实恢复成功过。恢复验证的结果、成功时间和指标存在性缺一不可。