
PostgreSQL / 系统课时
恢复误删或误更新的数据
恢复误删或误更新的数据
误删或误更新发生后,最安全的做法通常不是直接覆盖生产库,而是先根据事故时间和业务证据确定恢复目标,在隔离实例执行 PITR,再按影响范围选择局部数据修复或整库回切,从而尽量保留事故后的合法交易。
学习目标
- 根据日志、审计和业务证据确定可验证的 PITR 目标点。
- 在隔离数据目录恢复到错误事务之前,并确认恢复确实暂停在目标边界。
- 在局部数据修复与整库回切之间做选择,避免丢失事故后的正常数据。
先确定事故边界
先保全当前生产库、WAL 归档和相关日志,不要为了“尽快恢复”删除现有数据目录或清理归档。目标时间应尽量依据错误事务的提交时间,而不是只依据用户点击时间或应用请求开始时间;如果已经设置过命名恢复点,应优先使用能明确定位的恢复点。
若只有时间证据,要统一时区,并把应用日志、数据库日志、审计记录和业务异常首次出现时间放在同一时间轴上。对错误提交时间仍有不确定性时,应先恢复到更早的候选点验证,而不是冒险让错误事务被重放。
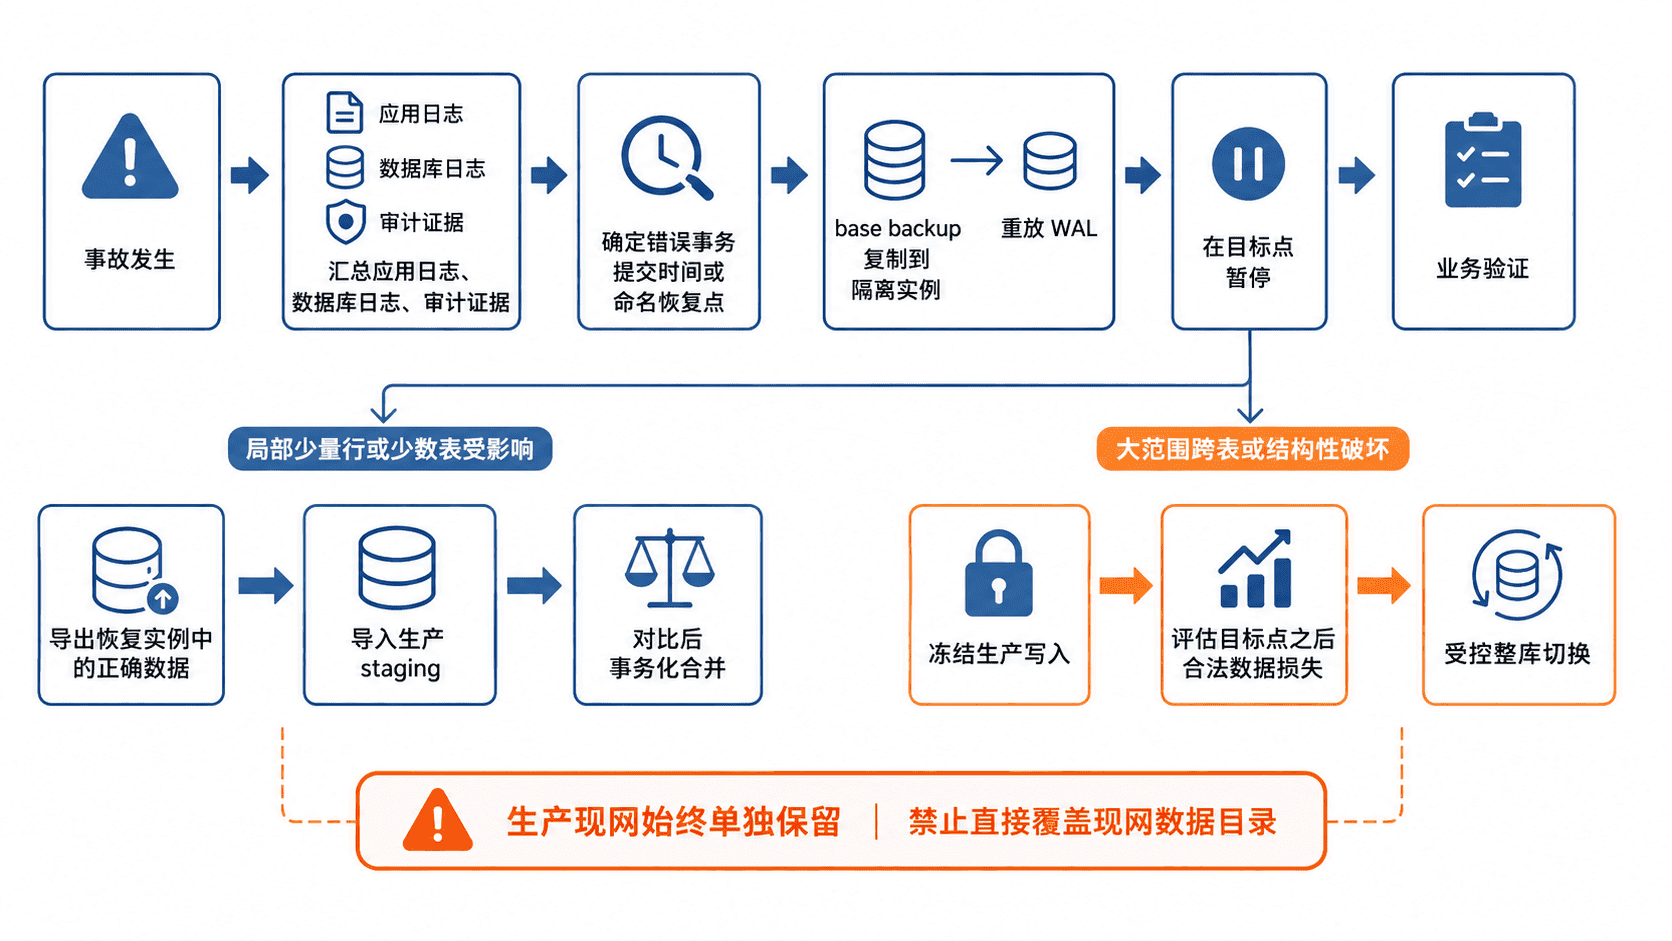
在隔离实例执行 PITR
以下以 PostgreSQL 14 及以上版本为例,恢复触发方式使用 PostgreSQL 12 起提供的 recovery.signal。准备一份结束时间早于目标点的物理基础备份,将其恢复到独立的 <PATH>/pitr-incident,并确认 WAL 归档覆盖目标时间。不要让业务流量连接这个实例。
把 <PATH>、<TIME> 和 <PORT> 替换成真实值后执行。这里将 <TIME> 设为已经确认的错误事务提交时间,并用 recovery_target_inclusive = false 让恢复停在该提交之前。
PGDATA='<PATH>/pitr-incident'

cat >> "$PGDATA/postgresql.auto.conf" <<'EOF'
restore_command = 'cp <PATH>/wal-archive/%f %p'
recovery_target_time = '<TIME>'
recovery_target_inclusive = false
recovery_target_action = 'pause'
hot_standby = on
port = <PORT>
EOF

touch "$PGDATA/recovery.signal"
pg_ctl -D "$PGDATA" start
预期输出:
waiting for server to start.... done
server started
如果 <TIME> 只是确认安全的较早点,而不是错误事务本身的提交时间,recovery_target_inclusive 不能弥补证据不精确;仍应通过业务数据验证边界。若 WAL 在目标点之前就耗尽,恢复不算成功,应先补齐归档链路。
验证暂停点并提取正确数据
恢复到目标后,应确认 WAL 回放确实处于暂停状态,并记录最后重放事务时间。连接参数按隔离实例实际环境填写。
psql "host=127.0.0.1 port=<PORT> dbname=postgres user=<USER>" -c "SELECT pg_is_in_recovery() AS in_recovery, pg_get_wal_replay_pause_state() AS pause_state, pg_last_xact_replay_timestamp() AS replay_time;"预期输出:
 in_recovery | pause_state |      replay_time
-------------+-------------+------------------------
 t           | paused      | <REPLAY_TIME>
(1 row)
<REPLAY_TIME> 是最后一个已重放事务的提交时间;当错误事务被 recovery_target_inclusive = false 排除时,它应早于该错误事务的提交时间。PostgreSQL 12~13 可用 pg_is_wal_replay_paused() 做兼容性检查。
对于只影响少量行或少数表的事故,优先从隔离实例导出事故前的正确记录,再在生产库通过 staging 表对比后合并。下面假设事故对象为 public.orders,实际使用时替换 <DB>、<USER>、<ID_LIST> 和输出路径。
psql "host=127.0.0.1 port=<PORT> dbname=<DB> user=<USER>" -c "\copy (SELECT id, status, updated_at FROM public.orders WHERE id IN (<ID_LIST>) ORDER BY id) TO '<PATH>/orders-recovered.csv' CSV HEADER"预期输出:
COPY <N><N> 是实际导出的行数。把文件送入生产前,应先导入独立 staging 表,对比当前值与恢复值,只更新已确认受事故影响的主键;不要用整表覆盖修复少量记录。
选择逻辑修复还是整库回切
| 情况 | 更合适的动作 | 主要代价 |
|---|---|---|
| 少量行、少数表被误删或误更新 | 从 PITR 实例提取正确数据,事务化合并到当前生产库 | 需要逐条确认业务键和关联关系 |
| 大范围跨表污染、批量 DDL 或状态难以逐项修补 | 评估后执行整库回切 | 目标点之后的合法写入需要另行补偿 |
| 事故边界仍不确定 | 继续在隔离实例尝试更早或更晚的恢复目标 | 增加恢复验证次数,但不破坏现网 |
整库回切前必须冻结或排空生产写入,保留当前生产库作为可回退证据,并明确目标点之后有哪些合法交易会消失。若决定采用已经暂停且验证通过的 PITR 实例作为新主库,应在受控切换窗口结束恢复,再重新接入归档、监控和业务流量。
局部数据修复的核心是只取回错误操作破坏的那部分历史;整库回切的核心是接受整个集群回到旧时间点。把两种动作区分开,才能避免修复一次误操作时再制造一次更大的数据丢失。