
消息队列 / 系统课时
读懂 Classic Rebalance 流程
读懂 Classic Rebalance 流程
Classic Rebalance 的核心不是“协调器直接把分区算好”,而是让全组成员先进入同一轮 JoinGroup,由选出的 group leader 计算分配,再通过 SyncGroup 把结果同步给所有成员。理解这两个同步屏障,就能解释为什么成员变化时会出现全组等待,以及暂停究竟发生在哪一段。
学习目标
- 按
JoinGroup、leader 分配、SyncGroup、恢复消费的顺序解释一次 Classic Rebalance - 找到全组等待和分区暂停产生的位置
- 区分 classic 协议本身与 eager、cooperative 分配策略带来的停顿差异
从加入组到恢复消费
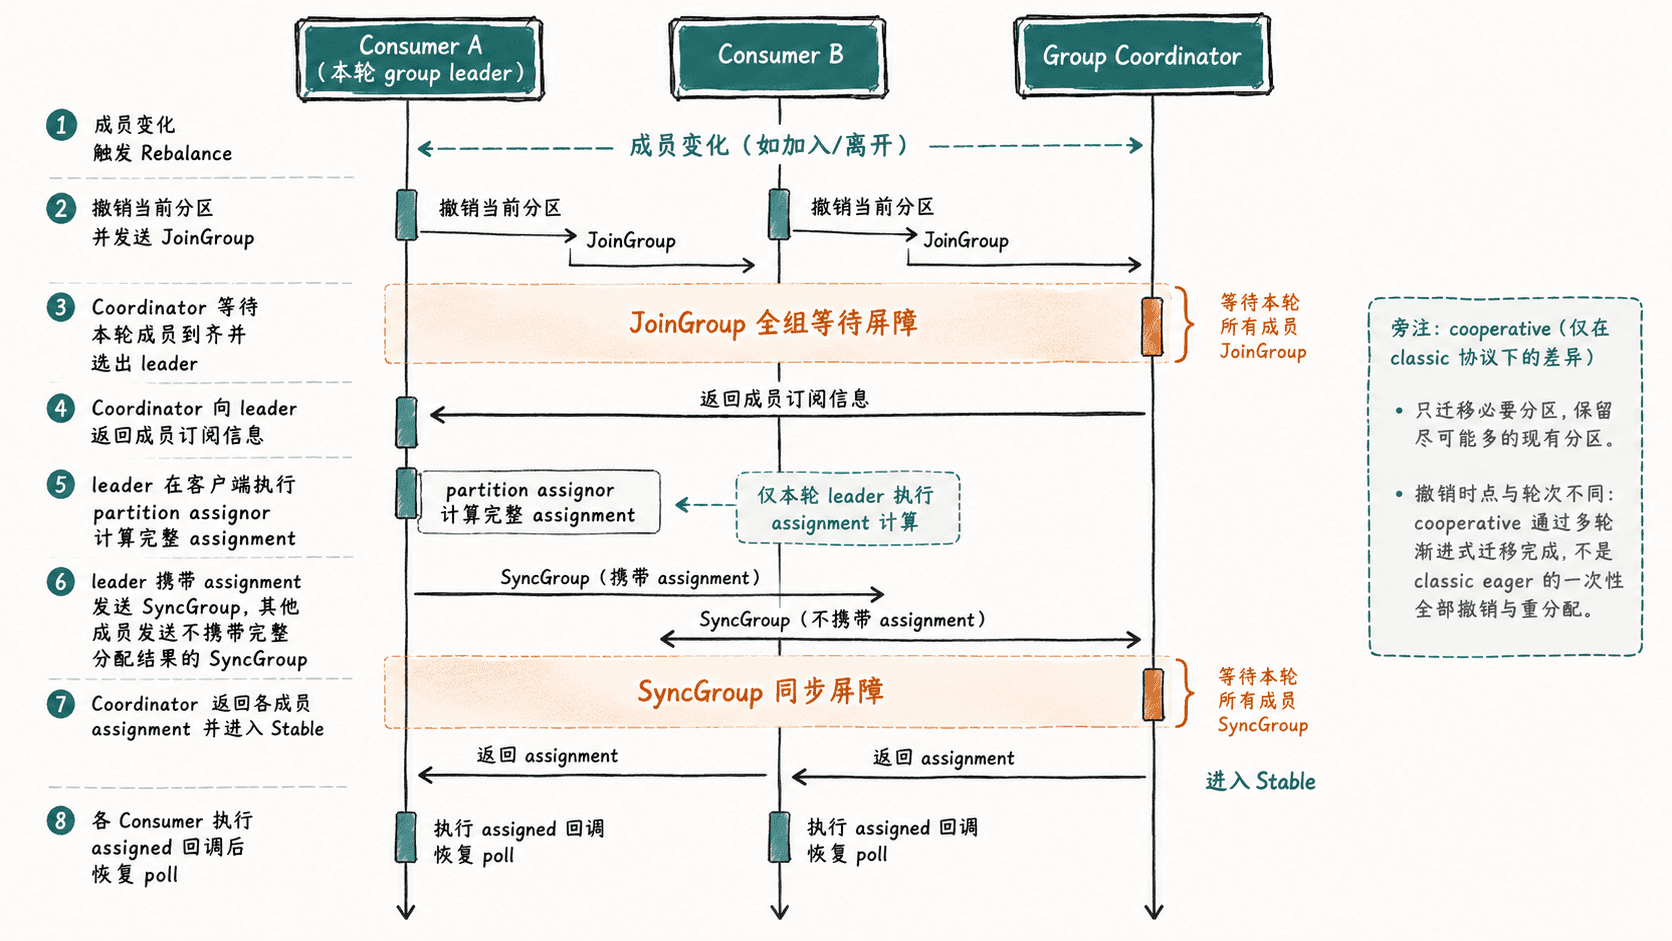
一次典型 Classic Rebalance 可以拆成四段。消费者先找到 Group Coordinator;当协调器进入重新平衡状态后,成员提交 JoinGroup 请求并等待同一代次形成。协调器从成员中选出 group leader,并把成员及订阅信息交给 leader。
leader 随后运行客户端分配器,例如 Range、RoundRobin 或 Sticky,计算“哪个成员拿哪些 partition”。leader 通过 SyncGroup 把整份 assignment 提交给协调器,其他成员也发送 SyncGroup 等待结果。协调器接受分配后,将各成员自己的 assignment 返回,组重新进入 Stable,消费者再对新分区执行本地初始化并继续 poll()。
全组等待发生在两个屏障
第一个屏障是 JoinGroup。协调器必须拿到这一轮有效成员的加入信息,才能确定成员集合和选出 leader。某个成员因为长时间处理、阻塞回调或网络问题迟迟不能完成 rejoin,会让其他已经到达的成员一起等待,直到它加入、失活或本轮超时条件成立。
第二个屏障是 SyncGroup。leader 必须先完成分配并把结果交给协调器,其他成员才能拿到自己的 assignment。因此 leader 端分配计算过慢、成员规模过大或分配结果过大,都可能拉长这一段。Classic 协议的关键成本就在这里:成员变动会把整个组拉回一个需要共同收敛的同步过程。
暂停范围取决于分配策略
Classic group protocol 常和“stop-the-world”联系在一起,但要把协议同步与分区撤销策略分开看。使用 eager 分配器时,成员在重新加入前通常先撤销当前全部分区,所以从撤销到新 assignment 生效之间,整个组容易出现明显消费空窗。
若在 classic 协议下使用 cooperative sticky 分配器,成员只撤销确实需要迁移的分区,其他仍归自己持有的分区可以继续保留。这样能显著缩小一次 Rebalance 的暂停范围,但 Classic 的 JoinGroup 与 SyncGroup 协调轮次仍然存在,成员变化仍需要全组完成协议收敛。
因此看到“Classic”时,不应直接推导出“每次都全量撤销”;应继续检查 partition.assignment.strategy 以及客户端实际采用的是 eager 还是 cooperative 语义。
用组状态观察流程阶段
片段示例:假设已经有 Kafka 客户端脚本、localhost:9092 可访问,并且 demo 消费组正在运行。下面循环每秒查询一次组状态,用于在启动或关闭消费者时观察状态变化。
while true; do
  kafka-consumer-groups.sh --bootstrap-server localhost:9092 --describe --group demo --state
  sleep 1
done
稳定阶段的预期结果应包含 Stable。如果采样正好落在 Rebalance 窗口,不同 Kafka 版本的 CLI 输出格式会有差异,但状态可能短暂表现为准备或完成 Rebalance 的中间态,随后回到 Stable。
GROUP  ...  STATE   #MEMBERS
demo   ...  Stable  <N>
<N> 是当时有效成员数,协调器 ID、主机和列顺序也可能随版本不同。这个命令更适合确认“组是否正在反复离开 Stable”,若要解释为什么反复发生,还要继续结合消费者日志、成员超时和订阅或 partition 变化来定位触发源。
把延迟拆到具体阶段
遇到一次 Rebalance 很慢,不要只记录“耗时几十秒”。先判断成员是不是迟迟没有完成 rejoin;若 JoinGroup 很慢,重点查 poll() 是否被业务处理拖住、撤销回调是否阻塞、成员是否频繁失活。若成员很快进入组但同步仍慢,再看 leader 分配计算、成员规模与 assignment 大小。
最后再看恢复阶段:成员已拿到新分区后,若 onPartitionsAssigned 中还要做外部 I/O、状态恢复或大规模 seek,组可能已经 Stable,但业务消费仍没有真正恢复。把“触发 → JoinGroup 屏障 → leader 分配 → SyncGroup 屏障 → 本地恢复”分开测,才能把 Classic Rebalance 的停顿从一个模糊现象拆成可治理的具体阶段。