
消息队列 / 系统课时
设计可重试的消费处理
设计可重试的消费处理
Kafka 在崩溃恢复、提交失败和 Rebalance 后都可能再次交付已经处理过的记录。可重试消费的目标不是消灭重复读取,而是让同一业务事件被执行多次时,最终业务状态仍只产生一次有效副作用。
学习目标
- 找出“业务已成功但 offset 未提交”这一类必然产生重复的失败窗口
- 用稳定的幂等键与数据库事务把重复消息变成可安全重放的输入
- 按错误类型设计重试、转移和提交顺序,避免重复副作用或消息丢失
先把重复交付当成正常路径
最常见的窗口是:消费者完成数据库更新,随后还没来得及提交 Kafka offset 就宕机,或者这时发生 Rebalance。新的消费者仍会从旧 committed offset 读取同一条记录,因此“至少一次”处理天然允许重复。
治理重点应从“这条消息会不会再来”改成“再来一次会发生什么”。如果再次执行会重复扣款、重复发券、重复创建工单,就必须让业务写入识别同一事件;仅靠 offset 提交时机无法覆盖所有崩溃窗口。
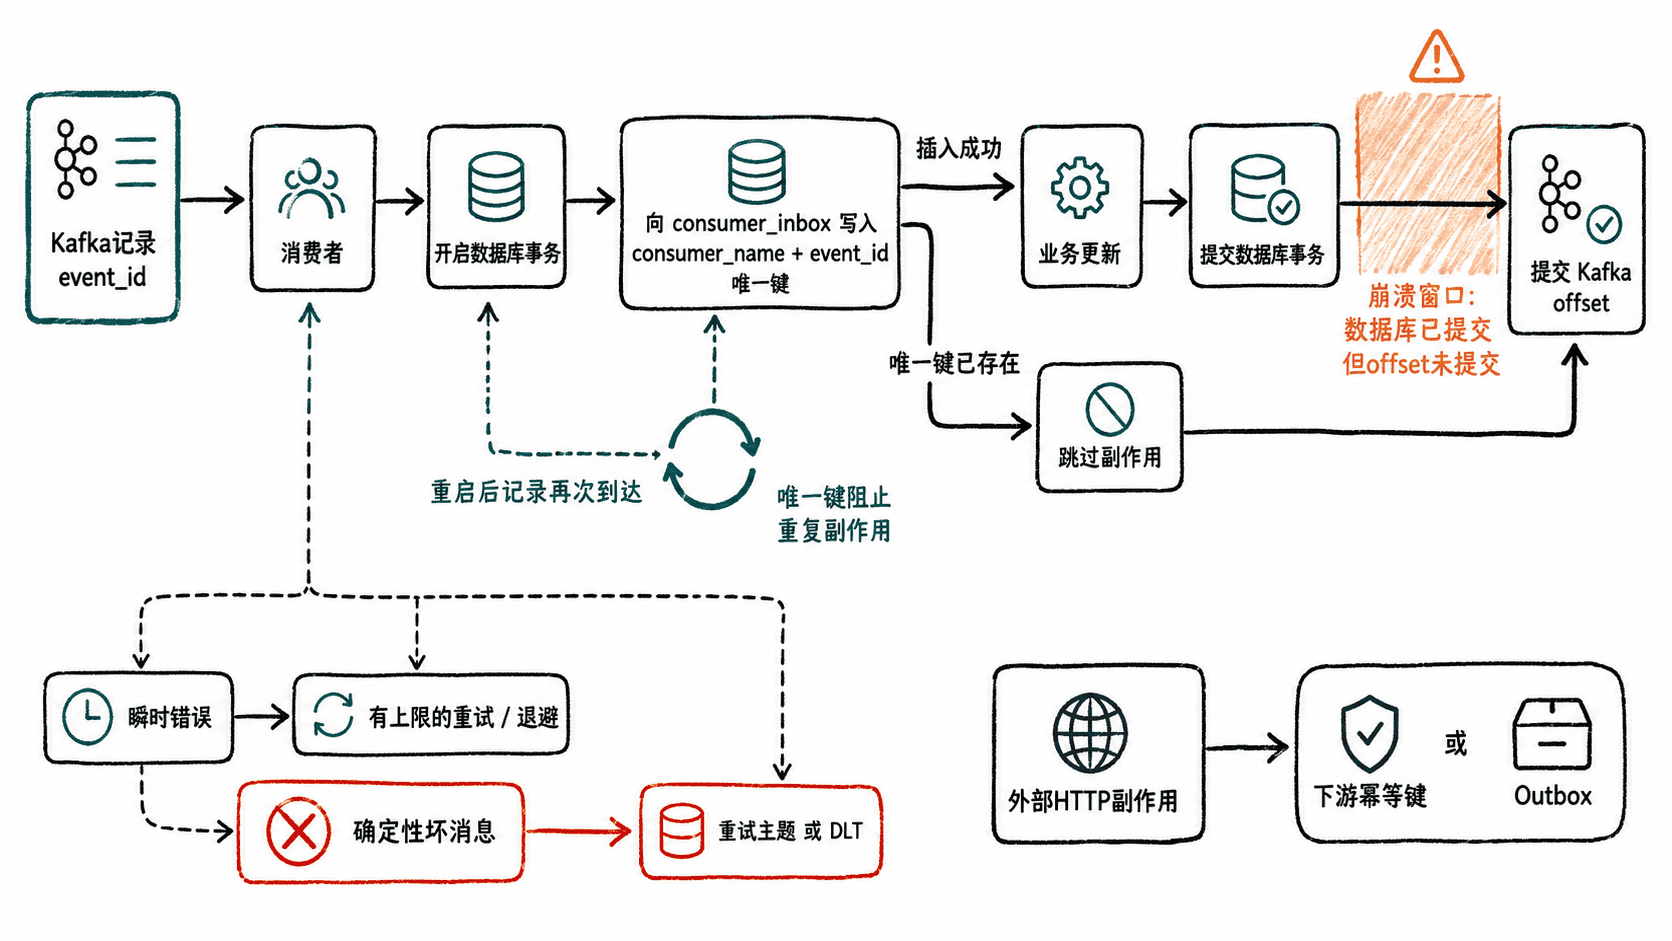
用稳定幂等键包住业务副作用
优先使用业务事件自身的稳定 ID,例如 event_id、支付请求号或订单状态变更 ID。topic + partition + offset 可以识别一次物理投递,但同一业务事件被重新发布到新 offset 时就会失效,因此它更适合没有业务 ID 时的兜底方案。
下面用 PostgreSQL 演示一个最小 Inbox 模式:去重记录与账户余额更新处于同一事务。第一次处理写入唯一键并增加余额;第二次处理同一个 event_id 时,唯一键冲突被安全忽略,业务更新不会再次执行。
DROP TABLE IF EXISTS consumer_inbox;
DROP TABLE IF EXISTS account_balance;

CREATE TABLE account_balance (
    account_id text PRIMARY KEY,
    amount bigint NOT NULL
);

CREATE TABLE consumer_inbox (
    consumer_name text NOT NULL,
    event_id text NOT NULL,
    processed_at timestamptz NOT NULL DEFAULT now(),
    PRIMARY KEY (consumer_name, event_id)
);

INSERT INTO account_balance(account_id, amount)
VALUES ('acct-1', 0);

BEGIN;
WITH accepted AS (
    INSERT INTO consumer_inbox(consumer_name, event_id)
    VALUES ('billing-consumer', 'evt-1001')
    ON CONFLICT DO NOTHING
    RETURNING 1
)
UPDATE account_balance
SET amount = amount + 100
WHERE account_id = 'acct-1'
  AND EXISTS (SELECT 1 FROM accepted);
COMMIT;

BEGIN;
WITH accepted AS (
    INSERT INTO consumer_inbox(consumer_name, event_id)
    VALUES ('billing-consumer', 'evt-1001')
    ON CONFLICT DO NOTHING
    RETURNING 1
)
UPDATE account_balance
SET amount = amount + 100
WHERE account_id = 'acct-1'
  AND EXISTS (SELECT 1 FROM accepted);
COMMIT;

SELECT account_id, amount FROM account_balance;
SELECT count(*) AS processed_count FROM consumer_inbox;
预期结果:
 account_id | amount
------------+--------
 acct-1     |    100

 processed_count
-----------------
               1
这个模式抵抗的不只是 Kafka 的重复拉取,也包括消费者重启后重新执行同一事件。唯一键必须与“业务上只允许发生一次”的语义一致;如果一个事件允许被不同消费逻辑各处理一次,就把消费者名或处理类型纳入唯一键。
让数据库先落稳,再提交 offset
当业务状态写在外部数据库时,推荐的顺序是:完成数据库事务,然后再提交 Kafka offset。这样有三个清晰结果:数据库提交前崩溃,不会留下半个副作用;数据库提交后、offset 提交前崩溃,会重复读取,但幂等键会挡住第二次写入;offset 已提交时,业务状态早已持久化。
反过来先提交 offset 再写数据库会制造真正的丢消息窗口:一旦进程在两者之间崩溃,Kafka 认为记录已经消费完成,而业务状态却没有变化。这个风险不能靠重试弥补。
按错误类型决定是否重试
瞬时错误,例如数据库连接抖动、限流或短暂超时,可以在当前处理链路中做有上限的指数退避,并加入少量 jitter,避免大量消费者同时重试。重试期间不要推进对应记录的 committed offset;如果退避可能很长,不要让 poll() 线程一直休眠到超过 max.poll.interval.ms,应暂停该分区并继续轮询,或把任务转入独立重试通道。
确定性错误,例如业务校验永远不通过或消息内容缺少必填字段,不应无限阻塞分区。可以记录失败原因并转入重试主题或 DLT,再提交原始记录的 offset。若“发布重试消息”和“提交原始 offset”都发生在 Kafka 内部,可用 Kafka 事务把二者纳入同一事务;否则至少遵循“先确认重试消息已持久化,再提交原始 offset”,并继续依赖幂等键处理可能的重复发布。
对强顺序业务还要额外评估 retry topic:把失败记录延后处理可能让同一 key 的后续记录越过它。若顺序不可破坏,宁可暂停该分区并在原地有限重试,也不要为了吞吐把有序流拆散。
用故障注入验收幂等性
验收时不要只跑一次成功路径。至少验证三种场景:连续处理两次相同 event_id,业务状态只变化一次;在数据库提交后、Kafka offset 提交前强制终止进程,重启后重复记录不会重复副作用;处理过程中触发 Rebalance,新持有者接管后仍能安全重放。
如果这三种场景都成立,重试策略才真正建立在业务幂等之上,而不是依赖“提交足够快”这种无法保证的时间假设。