
消息队列 / 系统课时
使用 Pause 与 Resume 做背压
使用 Pause 与 Resume 做背压
当下游数据库、HTTP 服务或线程池暂时处理不过来时,目标不是让消费者退出组,而是暂缓指定分区继续取数,同时保持 Poll 循环活跃。pause() 与 resume() 可以把背压限制在当前消费者和当前分区,避免用重启制造额外 Rebalance。
学习目标
- 理解
pause()、resume()与消费组成员关系之间的边界。 - 使用高低水位控制拉取节奏,并持续调用
poll()。 - 正确处理已拉取记录、Offset 提交与 Rebalance 后的暂停状态。
Pause 不是停掉消费者
pause(Collection<TopicPartition>) 暂停的是指定已分配分区的后续取数。被暂停后,未来的 poll() 不再返回这些分区的新记录,但订阅关系和分区归属并不会因此改变,也不会因为调用 pause() 本身触发 Rebalance。
这和“停止调用 poll()”完全不同。消费组仍然要求消费者按时进入 Poll 循环;如果两次 poll() 的间隔超过 max.poll.interval.ms,消费者可能被视为失去处理能力并引发重新分配。背压期间应继续短周期 Poll,只是让暂停分区暂时不再补充新记录。
还要注意一个边界:pause() 只影响之后的 Poll,已经返回到应用内存中的记录不会被 Kafka 收回。因此真正的限流对象应是“Kafka 拉取 + 本地待处理队列”这条链路,而不是等内存已经堆满后才暂停。
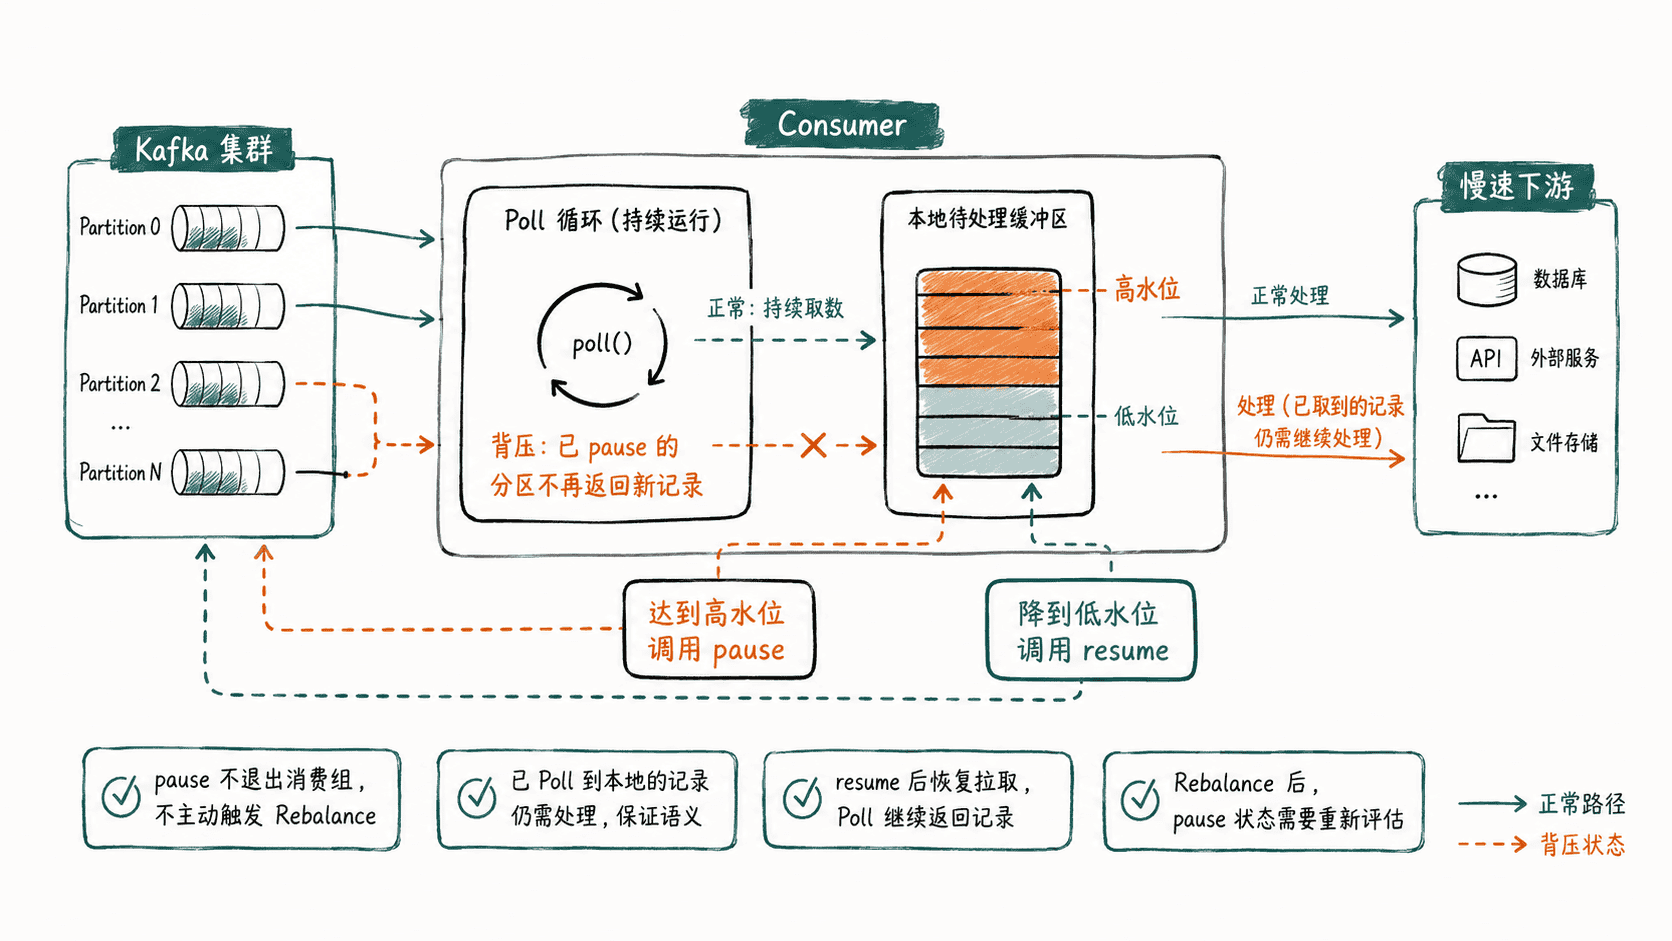
用高低水位控制拉取
最实用的策略是设置两个阈值:待处理记录达到高水位时暂停拉取,下降到低水位时再恢复。两个阈值不要相同,否则队列在临界点附近抖动时会频繁 Pause/Resume。
下面示例假设 Java 工程已引入与集群兼容的 org.apache.kafka:kafka-clients。它把 Poll 到的记录先放入本地缓冲区,每轮只处理少量记录,从而保证消费线程能持续回到 poll();Offset 只提交到已经处理完成的位置。
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRebalanceListener;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.clients.consumer.OffsetAndMetadata;
import org.apache.kafka.common.TopicPartition;
import org.apache.kafka.common.serialization.StringDeserializer;

import java.time.Duration;
import java.util.ArrayDeque;
import java.util.Collection;
import java.util.Collections;
import java.util.Deque;
import java.util.HashMap;
import java.util.HashSet;
import java.util.Map;
import java.util.Properties;
import java.util.Set;

public class PauseResumeBackpressureDemo {
    private static final int HIGH_WATERMARK = 200;
    private static final int LOW_WATERMARK = 50;
    private static final int PROCESS_PER_LOOP = 10;

    public static void main(String[] args) {
        String bootstrapServers = args.length > 0 ? args[0] : "localhost:9092";
        String topic = args.length > 1 ? args[1] : "orders";
        String groupId = args.length > 2 ? args[2] : "orders-worker";

        Properties props = new Properties();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServers);
        props.put(ConsumerConfig.GROUP_ID_CONFIG, groupId);
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, "false");
        props.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, "50");

        Deque<ConsumerRecord<String, String>> buffer = new ArrayDeque<>();

        try (KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props)) {
            consumer.subscribe(Collections.singletonList(topic), new ConsumerRebalanceListener() {
                @Override
                public void onPartitionsRevoked(Collection<TopicPartition> partitions) {
                    // 丢弃尚未处理的本地记录,让新 owner 从已提交 Offset 重新获取。
                    buffer.clear();
                    System.out.println("revoked=" + partitions);
                }

                @Override
                public void onPartitionsAssigned(Collection<TopicPartition> partitions) {
                    System.out.println("assigned=" + partitions);
                }
            });

            while (true) {
                ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(100));
                records.forEach(buffer::addLast);

                Set<TopicPartition> assignment = consumer.assignment();
                if (buffer.size() >= HIGH_WATERMARK
                        && !assignment.isEmpty()
                        && consumer.paused().isEmpty()) {
                    consumer.pause(assignment);
                    System.out.println("PAUSE buffer=" + buffer.size() + " partitions=" + assignment);
                }

                Map<TopicPartition, OffsetAndMetadata> processedOffsets = new HashMap<>();
                for (int i = 0; i < PROCESS_PER_LOOP && !buffer.isEmpty(); i++) {
                    ConsumerRecord<String, String> record = buffer.removeFirst();
                    process(record);
                    TopicPartition tp = new TopicPartition(record.topic(), record.partition());
                    processedOffsets.put(tp, new OffsetAndMetadata(record.offset() + 1));
                }

                if (!processedOffsets.isEmpty()) {
                    consumer.commitSync(processedOffsets);
                }

                if (buffer.size() <= LOW_WATERMARK && !consumer.paused().isEmpty()) {
                    Set<TopicPartition> paused = new HashSet<>(consumer.paused());
                    consumer.resume(paused);
                    System.out.println("RESUME buffer=" + buffer.size() + " partitions=" + paused);
                }
            }
        }
    }

    private static void process(ConsumerRecord<String, String> record) {
        try {
            // 模拟可被拆成短片执行的下游处理,避免一次处理长期占住消费线程。
            Thread.sleep(20);
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
            throw new RuntimeException("processing interrupted", e);
        }
    }
}
预期输出:当生产速度高于示例中的处理速度、缓冲区跨过阈值时,会看到类似状态切换;分区列表与缓冲区数值以现场为准。
assigned=<PARTITIONS>
PAUSE buffer=<VALUE> partitions=<PARTITIONS>
RESUME buffer=<VALUE> partitions=<PARTITIONS>
Offset 与 Rebalance 要一起设计
背压不能只看“是否暂停”,还要看 Offset 是否已经越过真正处理完成的位置。异步处理场景尤其不要开启自动提交后就把 Poll 到的记录直接塞进线程池,否则提交位置可能领先于下游完成进度,进程故障时会造成未处理记录被跳过。
示例在 Rebalance 撤销分区时清空未处理缓冲区,让这些记录由新 owner 从已提交位置重放。这会牺牲一部分重复处理来换取安全边界。生产系统若要减少重放,可以按分区维护任务队列和连续完成 Offset,并在撤销回调中停止接收、等待或取消该分区任务,再由消费线程提交安全位置。
Kafka 的暂停状态不会跨 Rebalance 保留。发生重新分配后,应根据新的 assignment()、当前队列水位和下游健康度重新决定哪些分区需要暂停,而不是假设旧状态仍有效。
什么时候该恢复拉取
恢复条件最好同时考虑本地队列和下游健康度。仅凭一个瞬时成功请求就 resume(),很容易让流量立即再次压满下游。实践中通常使用高低水位形成滞回,并为暂停持续时间、队列长度和消费 Lag 建立监控。
对于不可预测的长耗时 I/O,更稳妥的实现是把处理移到工作线程,但所有 KafkaConsumer API 仍由消费线程调用,并把“处理完成的 Offset”通过线程安全队列送回消费线程提交。这样既能持续 Poll,又不会违反 KafkaConsumer 非线程安全的约束。