
消息队列 / 系统课时
控制 max.poll.interval.ms
控制 max.poll.interval.ms
max.poll.interval.ms 约束的是消费者两次 poll() 之间允许经过的最长时间。真正要调稳它,不是简单把数值调大,而是把单批最坏处理耗时、外部依赖等待和提交开销算进预算,确保消费者不会因为业务线程长期不再调用 poll() 而被移出消费组。
学习目标
- 区分
max.poll.interval.ms与心跳、会话超时解决的问题 - 用单批最坏处理耗时反推合理的 Poll 时间预算
- 识别 RPC、长事务和阻塞代码导致 Poll 超时的典型风险
先确认它在限制什么
消费者成功 poll() 取到记录后,通常会在同一线程完成反序列化后的业务处理、RPC、数据库事务和位点提交,然后再次调用 poll()。这些步骤只要持续过久,就会把两次 Poll 的间隔拉长。
当该间隔超过 max.poll.interval.ms 时,客户端会被视为无法按期继续消费,并触发离组或分区重新分配。它和 session.timeout.ms 不是同一个问题:后者主要约束心跳失联,前者约束应用层是否还能持续推进 Poll 循环。
如果配置了静态成员身份 group.instance.id,Poll 超时后的成员处理节奏与普通动态成员不同,分区通常不会立刻重新分配,而会继续受会话超时约束;但应用本身已经不能把这种情况当作正常运行状态。
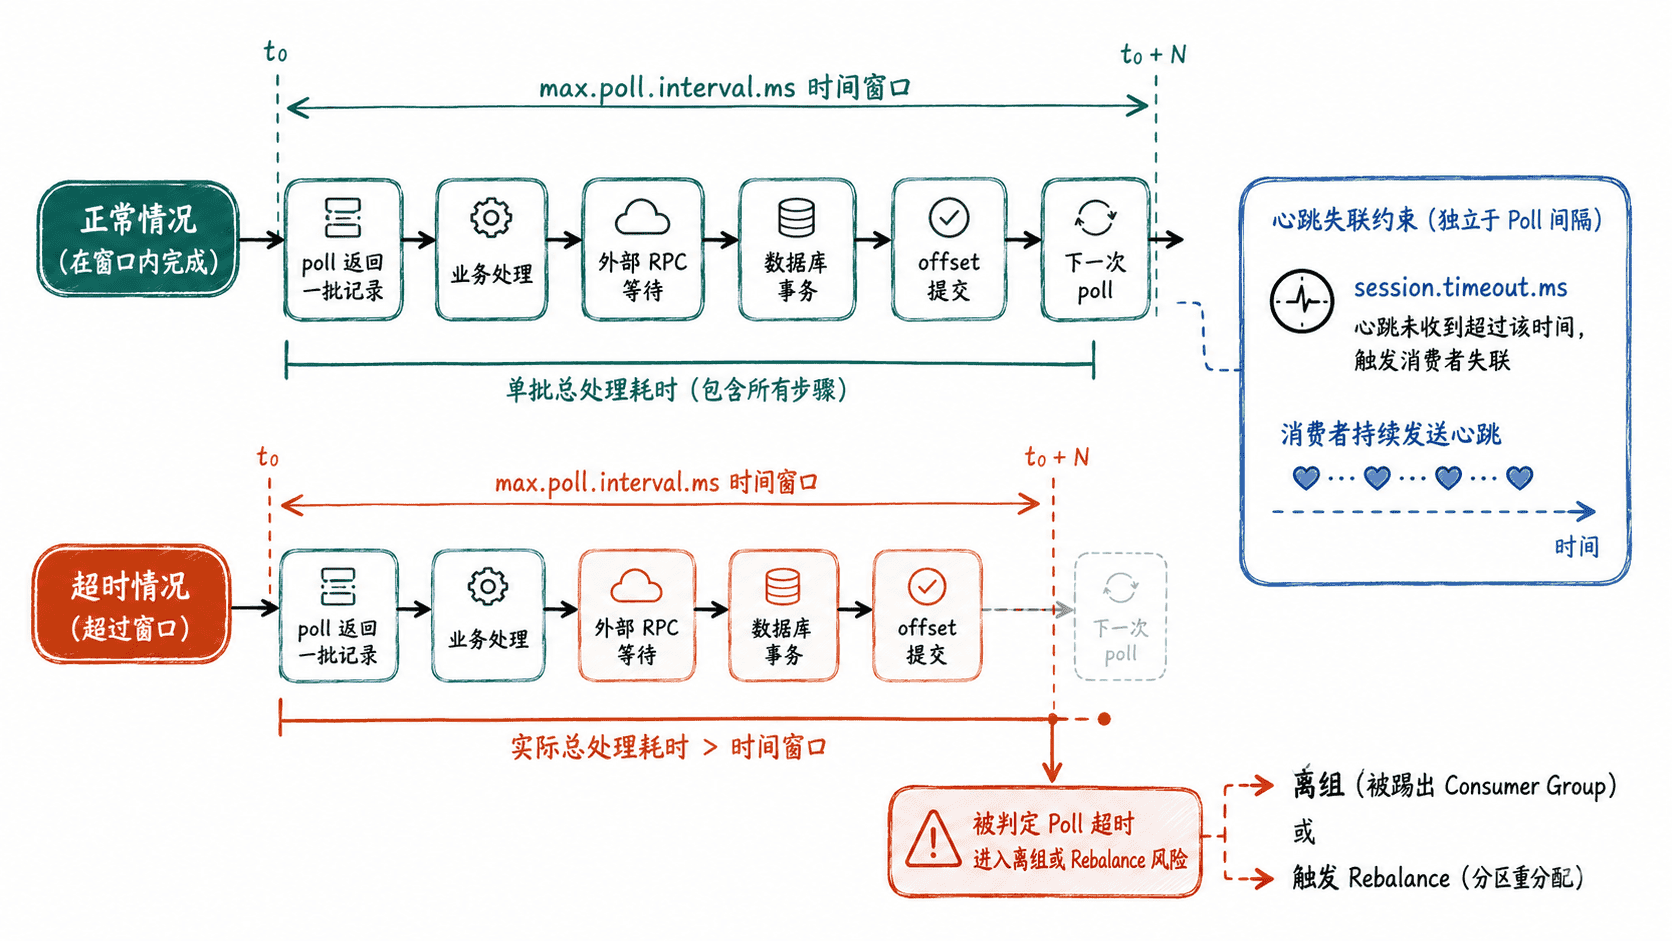
用最坏批次耗时反推配置
先估算一批记录从 poll() 返回到下一次 poll() 之前的最坏可接受耗时:
这里应关注高分位甚至故障场景,而不是平均值。例如平时 RPC 只需 20 ms,但下游抖动时单次可能等待数秒;如果一批里串行调用很多次,尾部耗时会迅速累加。
配置时应让业务预算明显小于 max.poll.interval.ms,留下 GC、调度抖动和瞬时网络延迟的余量。下面是一个片段示例,假设应用已经验证单批最坏处理时间可控制在 80 秒以内:
max.poll.records=200
max.poll.interval.ms=120000
enable.auto.commit=false
这组配置的关键不是“120 秒适合所有系统”,而是同时限制单次交给业务层的记录数,并给 80 秒处理预算留下额外余量。实际值必须用本服务的处理耗时数据重新计算。
优先消除阻塞源
如果经常逼近 Poll 上限,优先修正处理路径,而不是不断放大超时:
- 降低
max.poll.records,直接缩短单批最坏处理时间。 - 给外部 RPC、数据库调用和锁等待设置明确超时,避免无限阻塞。
- 拆短长事务,避免一批记录在同一事务中串行执行过久。
- 若把处理任务交给工作线程,必须保证 offset 只在对应记录真正处理完成后提交,并在必要时用
pause()控制继续取数,避免“Poll 很勤快但处理积压失控”。
用运行数据验证
上线后同时观察消费者自身的批次处理 P95/P99、单次 RPC 最长耗时和两次 Poll 间隔。如果通过 JMX 暴露消费者指标,可关注 last-poll-seconds-ago 与 Poll 间隔相关指标;一旦它们持续接近配置上限,就应先找出是哪一段业务处理在拉长批次。
最终目标不是让消费者“永不超时”,而是保证正常和可预期的异常场景都能在 Poll 时间预算内完成;真正不可控的阻塞应通过限时、降批次或隔离处理消除。