
消息队列 / 系统课时
设计 Lag 驱动的自动扩缩容
设计 Lag 驱动的自动扩缩容
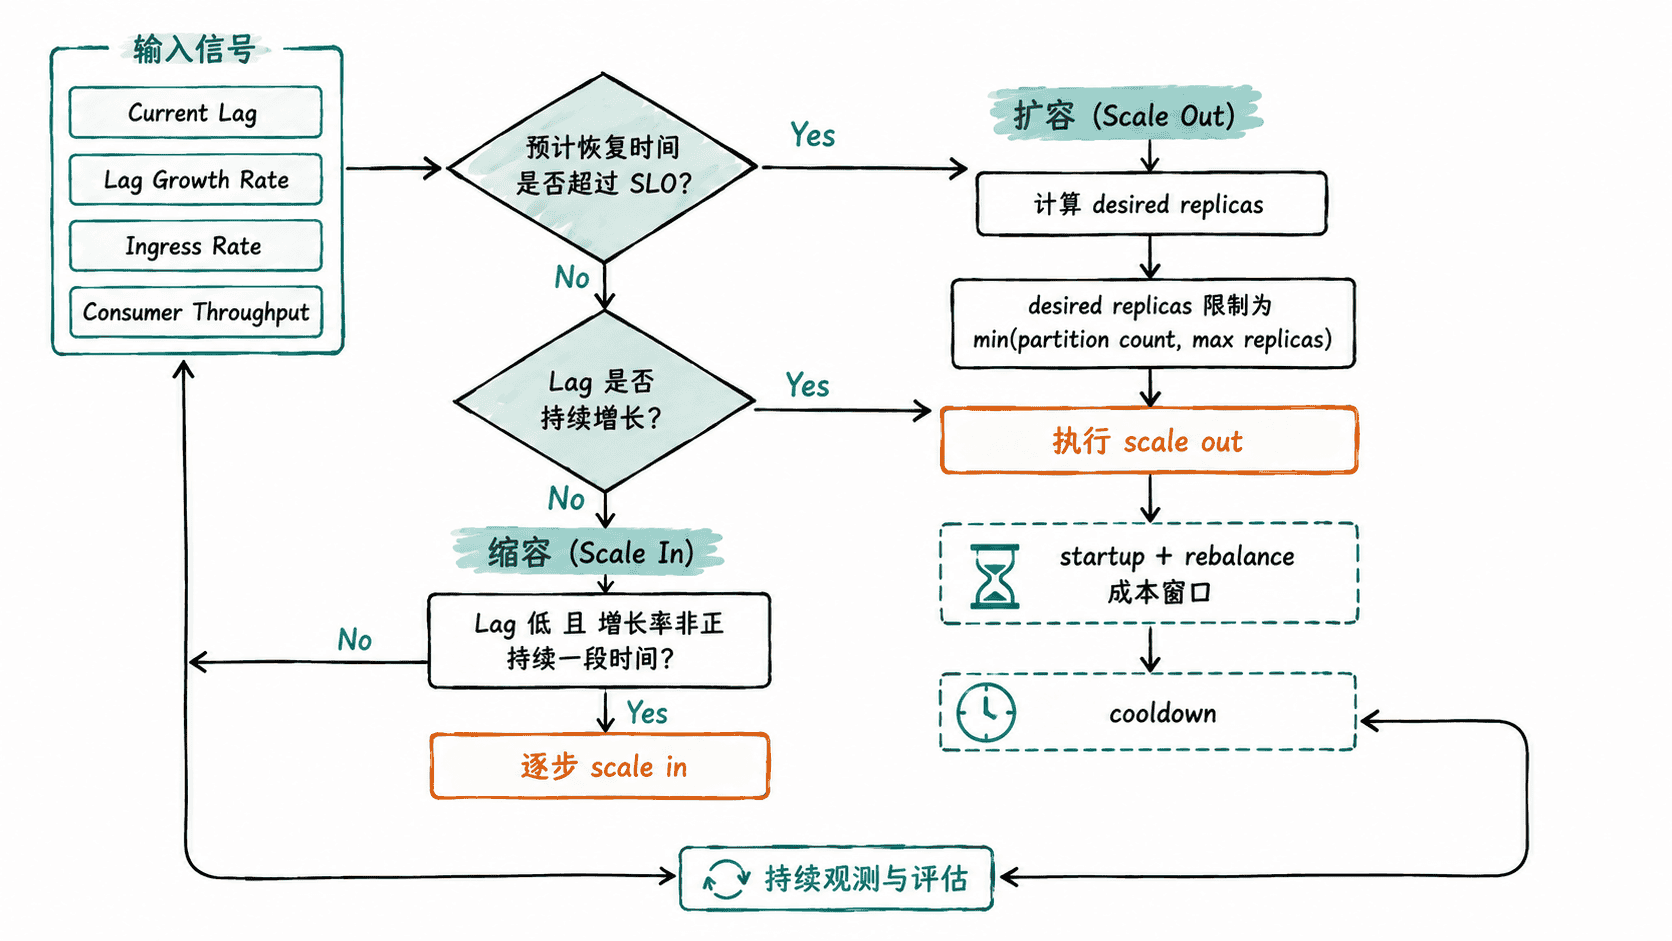
Lag 驱动扩缩容不能只写成“Lag 大于阈值就加机器”。扩容本身会触发成员变化与 Rebalance,新实例也需要启动时间。稳定的规则要同时考虑 Lag、Lag 增长速率、恢复目标、冷却窗口和分区上限。
学习目标
- 用 Lag 与增长速率构造扩缩容信号
- 把启动时间、Rebalance 成本和分区上限纳入决策
- 设计避免频繁伸缩震荡的冷却与回收规则
从恢复时间反推容量
如果当前 Lag 为 ,希望在目标时间 内清空,则系统除了跟上入口速率,还需要额外提供约 的净消费能力。
因此扩容规则可以关注“预计恢复时间”,而不只是 Lag 绝对值。相同的 100000 Lag,在入口 100 msg/s 和 10000 msg/s 的系统里代表完全不同的风险。
一个最小决策脚本
下面示例根据峰值入口、单实例能力、目标利用率和当前分区数给出基础副本数,再用 Lag 恢复需求增加容量。
python
import math

lag = 240000
recovery_seconds = 120
ingress_rate = 6000
instance_rate = 3000
target_utilization = 0.75
partitions = 8

base = math.ceil(ingress_rate / (instance_rate * target_utilization))
extra_rate = lag / recovery_seconds
extra = math.ceil(extra_rate / (instance_rate * target_utilization))

desired = min(base + extra, partitions)

print("base_replicas =", base)
print("extra_replicas =", extra)
print("desired_replicas =", desired)
预期输出:
text
base_replicas = 3
extra_replicas = 1
desired_replicas = 4
这个结果只用于容量估算,真实伸缩还要加入最小副本数、最大副本数、实例启动时间和冷却窗口。
防止伸缩震荡
扩容条件应要求信号持续一段时间,例如 Lag 连续增长 2~5 个采样窗口;缩容则更保守,例如 Lag 已低于安全线且增长率非正持续更久。
如果每次扩容都会触发 Rebalance,那么扩容过于频繁可能让系统把时间花在重新分配而不是处理消息。冷却窗口的意义,就是让上一次伸缩完成并观察新吞吐后再做下一次决策。
分区上限必须写进规则
自动扩容副本数不能无限增长,至少要满足:
超过分区数的实例通常无法获得分区,不会增加消费吞吐。若长期触碰该上限,说明问题已经从“副本数不足”升级为“分区并行度或单实例处理能力不足”,应触发容量规划而不是继续自动加副本。
按自己的节奏,确认真正理解。