
消息队列 / 系统课时
排查 Rebalance 风暴
排查 Rebalance 风暴
Rebalance 风暴不是“发生过多次 Rebalance”这么简单,而是消费组在短时间内反复失稳,导致吞吐下降、Lag 上升,再进一步放大超时与成员波动。排查时最有效的方法是先建立时间线,再把部署、超时、网络和 Topic 变化逐项对齐。
学习目标
- 用时间线识别 Rebalance 风暴而不是正常拓扑变化
- 关联成员日志、部署事件、网络异常和分区变化
- 找到触发成员反复加入或退出的根因并验证修复
先确认是不是风暴
一次发布导致成员重启并完成一次 Rebalance 属于正常现象。异常模式通常表现为:组刚恢复 Stable 又立刻失稳;成员 ID 持续变化;Lag 与 Rebalance 频率同步上升;没有人为扩缩容却反复发生成员变更。
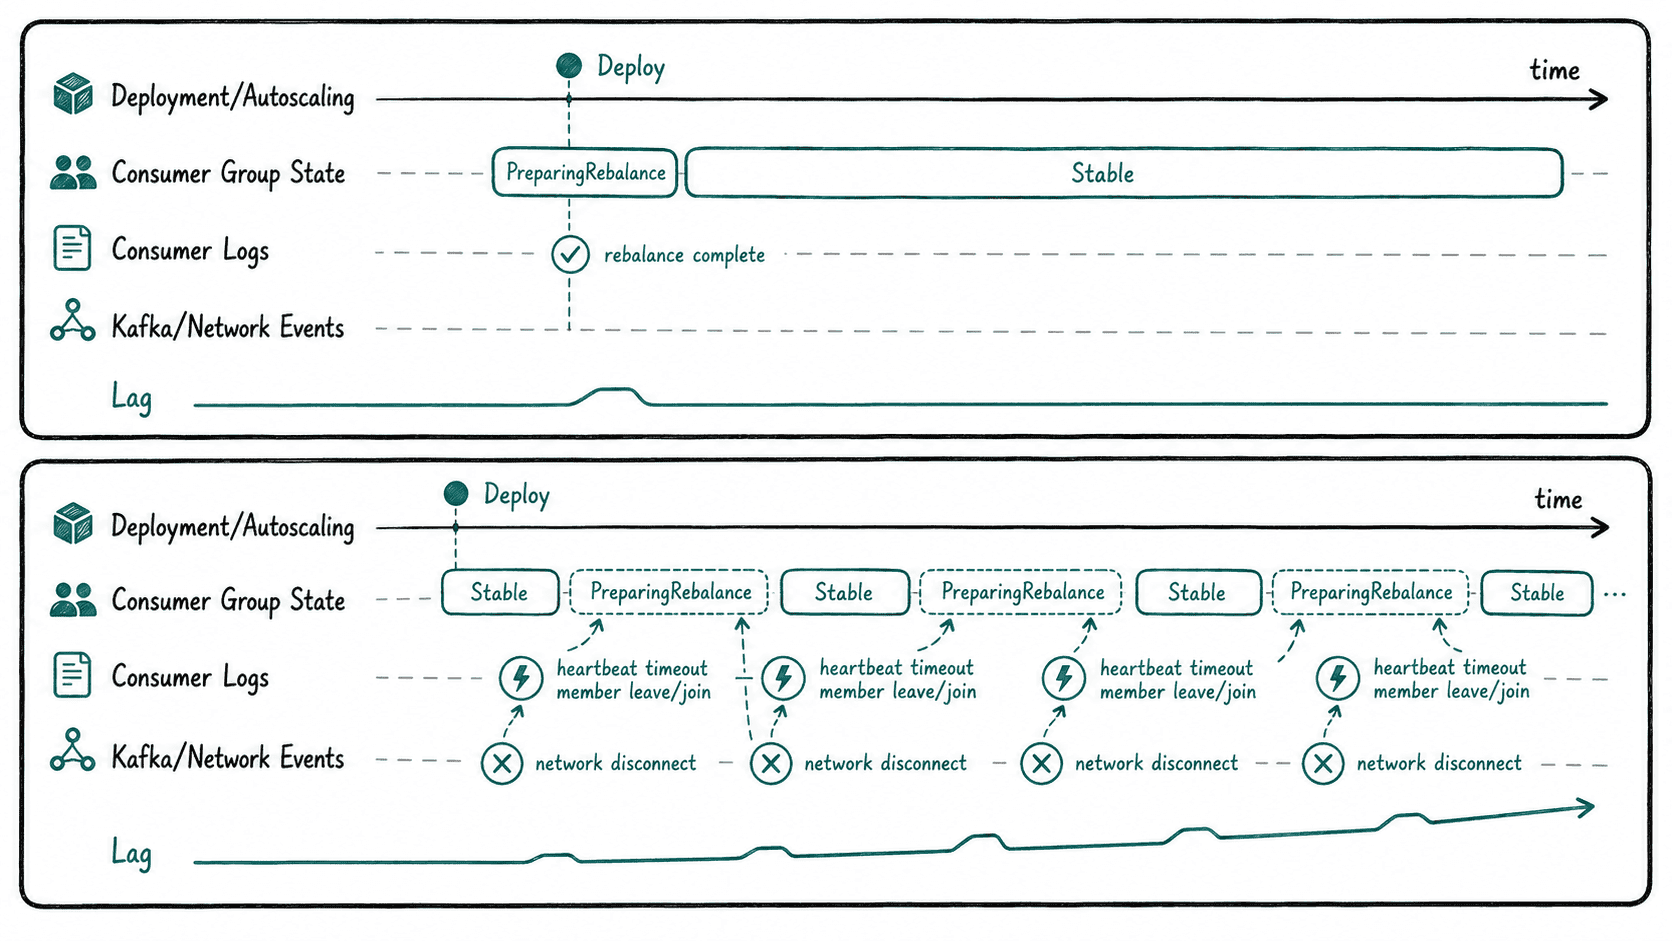
收集组状态与成员证据
先查看组状态:
bash
kafka-consumer-groups.sh --bootstrap-server <BOOTSTRAP_SERVERS> --group <GROUP_ID> --describe --state预期输出:
text
GROUP      COORDINATOR  ASSIGNMENT-STRATEGY  STATE   #MEMBERS
<GROUP_ID> <IP>:<PORT>  <VALUE>              Stable  4
如果连续观察时 STATE 频繁离开 Stable、成员数不断变化,就继续检查消费者日志。
常见日志关键词可以先做粗筛:
bash
grep -E "rebalance|heartbeat|coordinator|poll|disconnect|member" <PATH>/consumer.log预期输出:
text
<TIME> ... heartbeat ...
<TIME> ... rebalance ...
<TIME> ... coordinator ...
实际日志格式、关键词与时间会因客户端版本和日志配置不同。
按时间线排根因
优先检查是否刚发生部署、Pod 驱逐、自动扩缩容或进程重启。如果没有,再检查 max.poll.interval.ms 是否被业务处理阻塞突破,以及心跳和会话超时相关日志。
如果多个实例同时出现断连或 coordinator 请求超时,应把网络和 Broker 事件纳入同一时间线。Topic 分区数变化也会触发重新分配,不要只盯客户端。
修复后怎么验收
修复不是“日志不报错”就结束。至少观察一个完整业务高峰窗口,确认组状态长期 Stable、成员数符合预期、Rebalance 频率回到基线,Lag 不再因为协调震荡持续扩大。
如果系统使用自动扩缩容,还要确认伸缩策略不会在短时间内反复加减实例,否则根因可能从消费端转移到了控制器。
按自己的节奏,确认真正理解。