
消息队列 / 系统课时
搭建 Rebalance 观测实验
搭建 Rebalance 观测实验
要治理 Rebalance,先要有一个能重复触发、能留下证据的实验环境。本篇用固定分区数、固定生产速率和可控的消费者扩缩容,建立一套最小基线,同时记录组状态、成员分配、Lag 与客户端日志。
学习目标
- 搭建可重复的 Kafka Rebalance 实验环境
- 通过增加和移除消费者稳定触发组成员变化
- 保存成员分配、Lag 与客户端日志,形成后续对比基线
固定实验变量
实验使用 6 个分区和同一个消费组。生产端固定为每秒 20 条、每条 100 字节;消费者先启动 1 个实例,再扩到 2 个,最后停止第一个实例。这样既能看到“成员加入”触发的 Rebalance,也能看到“成员离开”后的重新分配。
为了减少历史状态干扰,脚本使用进程号生成新的 Topic 和 Group 名称。需要预先满足两个条件:本机已有可用 Kafka Broker,且 kafka-topics.sh、kafka-producer-perf-test.sh、kafka-console-consumer.sh、kafka-consumer-groups.sh 已加入 PATH。
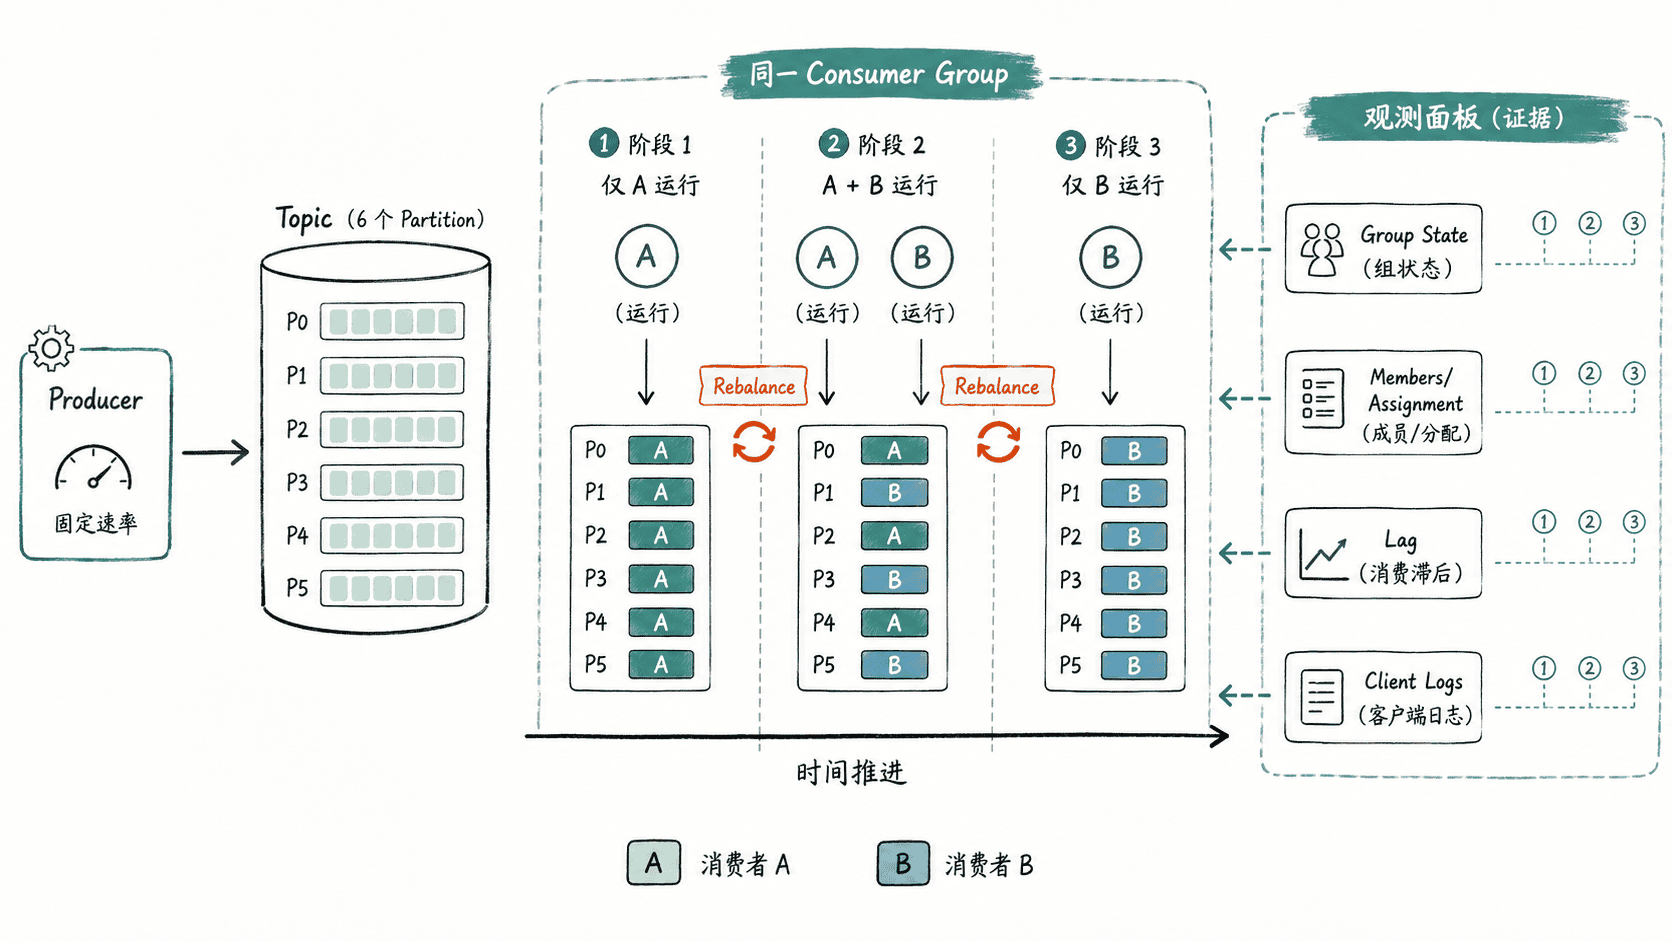
一次脚本完成三阶段实验
下面脚本会创建实验 Topic,启动固定速率生产者和消费者 A,记录第一份快照;随后启动消费者 B 触发 Rebalance,再记录第二份快照;最后停止 A,再次等待组稳定并记录第三份快照。消费者输出与标准错误分别保存在日志目录中。
#!/usr/bin/env bash
set -u

BOOTSTRAP="localhost:9092"
RUN_ID="$$"
TOPIC="rebalance-lab-${RUN_ID}"
GROUP="rebalance-lab-${RUN_ID}"
LOG_DIR="./rebalance-lab-logs-${RUN_ID}"

mkdir -p "$LOG_DIR"

observe() {
  label="$1"
  {
    echo "=== ${label} ==="
    date '+%Y-%m-%d %H:%M:%S'
    kafka-consumer-groups.sh \
      --bootstrap-server "$BOOTSTRAP" \
      --group "$GROUP" \
      --describe \
      --state
    kafka-consumer-groups.sh \
      --bootstrap-server "$BOOTSTRAP" \
      --group "$GROUP" \
      --describe \
      --members \
      --verbose
    kafka-consumer-groups.sh \
      --bootstrap-server "$BOOTSTRAP" \
      --group "$GROUP" \
      --describe
  } | tee -a "$LOG_DIR/observe.log"
}

kafka-topics.sh \
  --bootstrap-server "$BOOTSTRAP" \
  --create \
  --topic "$TOPIC" \
  --partitions 6 \
  --replication-factor 1

kafka-producer-perf-test.sh \
  --topic "$TOPIC" \
  --num-records 6000 \
  --record-size 100 \
  --throughput 20 \
  --producer-props bootstrap.servers="$BOOTSTRAP" acks=all \
  >"$LOG_DIR/producer.log" 2>&1 &
PRODUCER_PID=$!

kafka-console-consumer.sh \
  --bootstrap-server "$BOOTSTRAP" \
  --topic "$TOPIC" \
  --group "$GROUP" \
  --consumer-property client.id=consumer-a \
  --consumer-property partition.assignment.strategy=org.apache.kafka.clients.consumer.RangeAssignor \
  >"$LOG_DIR/consumer-a.out" 2>"$LOG_DIR/consumer-a.err" &
CONSUMER_A_PID=$!

sleep 5
observe "one-consumer"

kafka-console-consumer.sh \
  --bootstrap-server "$BOOTSTRAP" \
  --topic "$TOPIC" \
  --group "$GROUP" \
  --consumer-property client.id=consumer-b \
  --consumer-property partition.assignment.strategy=org.apache.kafka.clients.consumer.RangeAssignor \
  >"$LOG_DIR/consumer-b.out" 2>"$LOG_DIR/consumer-b.err" &
CONSUMER_B_PID=$!

sleep 5
observe "two-consumers"

kill "$CONSUMER_A_PID"
wait "$CONSUMER_A_PID" 2>/dev/null || true

sleep 5
observe "consumer-a-stopped"

kill "$CONSUMER_B_PID" "$PRODUCER_PID" 2>/dev/null || true
wait "$CONSUMER_B_PID" 2>/dev/null || true
wait "$PRODUCER_PID" 2>/dev/null || true

echo "logs: $LOG_DIR"
预期输出的关键特征如下。成员 ID、协调器 ID、Offset、Lag、时间和日志目录都会因运行而不同,实际值可用 <ID>、<VALUE>、<TIME>、<PATH> 对照。
=== one-consumer ===
<TIME>
GROUP               COORDINATOR (ID)  ASSIGNMENT-STRATEGY  STATE   #MEMBERS
rebalance-lab-<ID>  <VALUE>           <VALUE>              Stable  1
GROUP               CONSUMER-ID  HOST   CLIENT-ID   #PARTITIONS  ASSIGNMENT
rebalance-lab-<ID>  <ID>         /<IP>  consumer-a  6            <VALUE>

=== two-consumers ===
<TIME>
rebalance-lab-<ID>  <VALUE>  <VALUE>  Stable  2
rebalance-lab-<ID>  <ID>     /<IP>    consumer-a  3  <VALUE>
rebalance-lab-<ID>  <ID>     /<IP>    consumer-b  3  <VALUE>

=== consumer-a-stopped ===
<TIME>
rebalance-lab-<ID>  <VALUE>  <VALUE>  Stable  1
rebalance-lab-<ID>  <ID>     /<IP>    consumer-b  6  <VALUE>

logs: <PATH>
如果第二阶段仍显示 1 个成员,先不要判断 Rebalance 失败。先检查 consumer-b.err 是否存在连接、认证或配置错误,再确认两个消费者确实使用同一个 Group 和 Topic。若状态短暂处于 PreparingRebalance 或 CompletingRebalance,说明采样碰到了过渡期,等待组稳定后再次执行观测命令即可。
基线要记录什么
一次有效的 Rebalance 基线不只是“看到了两次抖动”。至少要保存四类证据:组状态变化、每个成员拿到的 Partition、每个分区的 CURRENT-OFFSET/LOG-END-OFFSET/LAG,以及消费者标准错误日志中的组协调与分区分配信息。
这四类证据要使用同一个 Topic、Group 和时间窗口。否则你很容易把“成员变化导致的暂停”误判成“生产速率突增”,或者把“消费者已恢复但提交仍滞后”误判成 Rebalance 仍未完成。
怎样判断实验已经可复验
重复运行脚本时,不要求 Offset 和 Lag 数字完全相同,但三个结构性结果应该稳定出现:1 个消费者时独占 6 个分区,2 个消费者时各获得 3 个分区,停止 A 后 B 再次接管 6 个分区;同时 observe.log 中应能对应到三次稳定状态快照。
后续调优 session.timeout.ms、heartbeat.interval.ms、max.poll.interval.ms,或比较不同分配策略时,都应只改一个主要变量,再复用同一生产速率、分区数和观测方式。这样 Rebalance 次数、暂停时间与 Lag 变化才具备可比较性。