
消息队列 / 系统课时
验证扩缩容与故障恢复
验证扩缩容与故障恢复
Rebalance 治理不能只靠配置推断,必须在固定消息速率下主动制造成员变化和故障。本篇用同一套采样口径验证扩容、缩容、进程终止、网络抖动与慢处理,并把停顿、Lag 峰值和恢复时间变成可比较的生产验收指标。
学习目标
- 建立固定负载、固定采样间隔的 Rebalance 实验基线
- 对五类扰动分别记录成员变化、Lag 峰值与恢复过程
- 用统一指标判断扩缩容和故障恢复是否满足生产目标
先固定基线再制造扰动
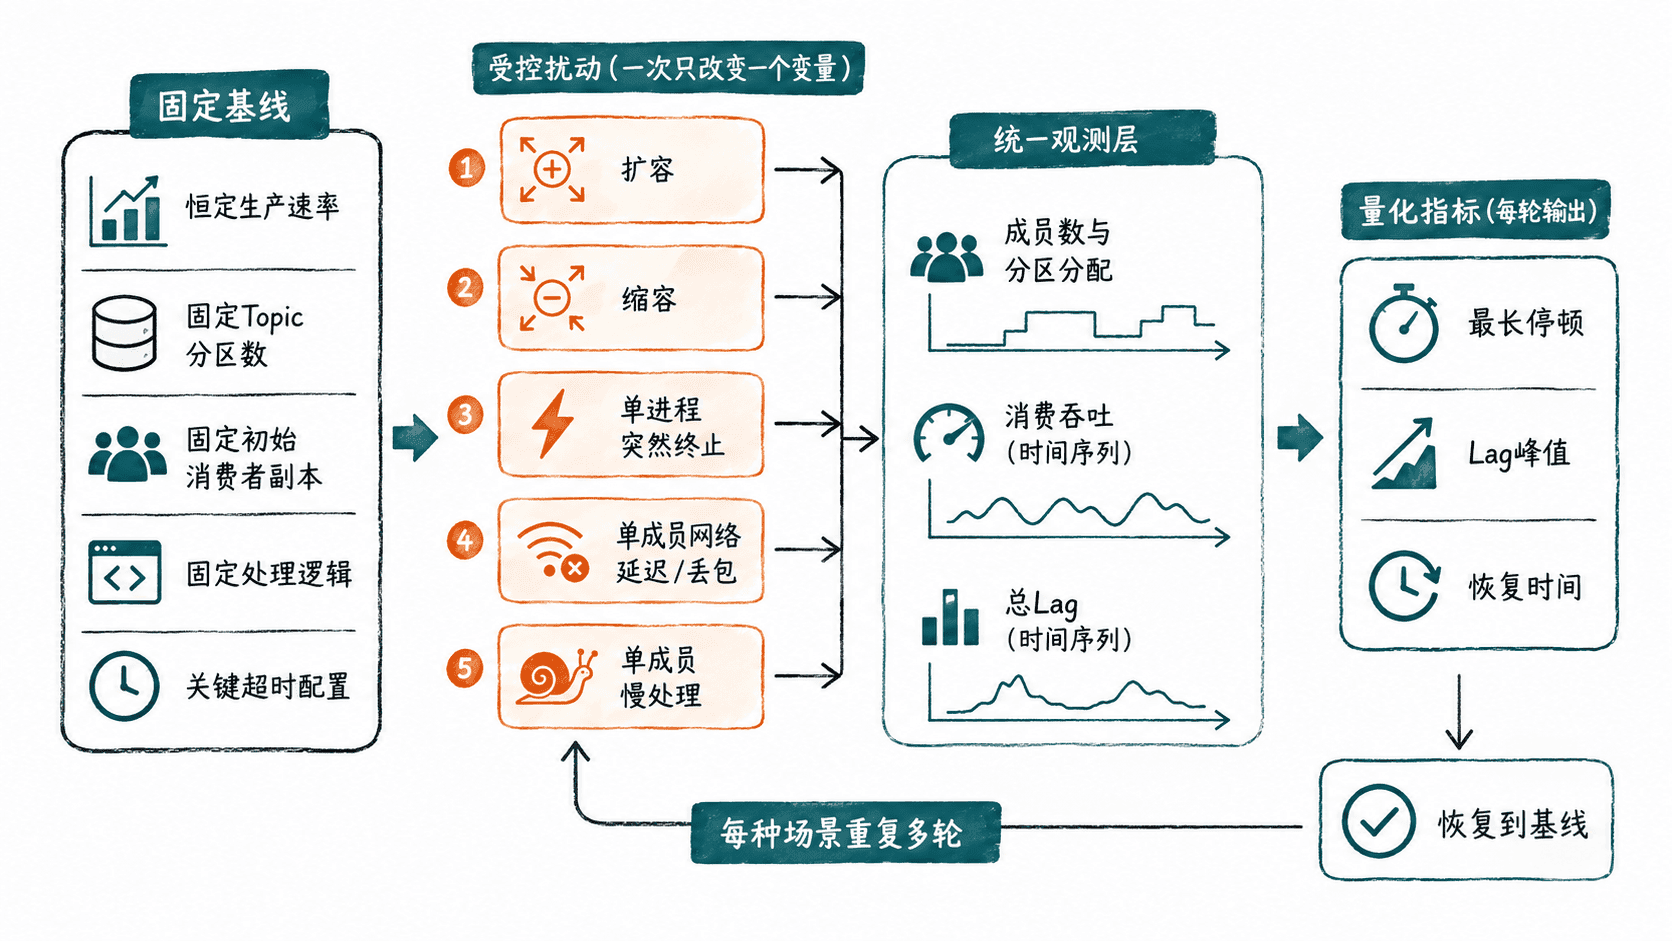
一次有效实验只改变一个变量。先固定 Topic 分区数、消费者初始副本数、生产速率、消息大小、处理逻辑与关键消费者配置,并运行到 Lag 和吞吐进入稳定区间。每个故障场景结束后都要恢复到这份基线,再开始下一轮。
建议至少记录三个指标:停顿时长是故障窗口内消费成功速率连续降到零或显著低于基线的最长时间;Lag 峰值是扰动后消费组总 Lag 的最大值;恢复时间是从注入扰动开始,到 Lag 回到基线容忍带并连续多个采样点稳定所需的时间。
建立可重复的 Lag 采样
Kafka 自带的消费者组工具可以持续读取分区 offset、Log End Offset、Lag 和成员信息。下面脚本每 5 秒采样一次,适合与应用侧的消费吞吐指标按时间对齐。
GROUP=orders-consumer
BROKER=<BROKER>

while true; do
  date '+%Y-%m-%dT%H:%M:%S%z'
  kafka-consumer-groups.sh \
    --bootstrap-server "$BROKER" \
    --describe \
    --group "$GROUP"
  sleep 5
done
预期输出
<TIME>
GROUP            TOPIC   PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG      CONSUMER-ID  HOST    CLIENT-ID
orders-consumer  orders  <VALUE>    <VALUE>         <VALUE>         <VALUE>  <ID>         /<IP>   <ID>
实际值会随负载变化。这个采样能给出 Lag 和分区归属,但“停顿”最好再用应用侧已成功处理消息计数器计算;只看 Kafka Lag,无法区分短暂停顿与生产速率本身下降。
按同一方法执行五类扰动
五类实验都应记录“扰动开始时间、成员变化时间、Lag 峰值时间、恢复到基线时间”,并至少重复多轮,避免把偶然抖动当作结论。
| 场景 | 受控动作 | 重点观察 |
|---|---|---|
| 扩容 | 在生产速率不变时把消费者副本从基线增加到更高值 | 新成员加入是否造成长停顿,扩容后处理能力是否真正上升 |
| 缩容 | 按优雅退出流程减少副本 | 分区交接是否平滑,剩余容量是否足以消化积压 |
| 进程终止 | 只让一个成员突然退出,不执行应用 drain | 组检测失败成员所需时间、重新分配范围和 Lag 增长速度 |
| 网络抖动 | 只对一个消费者到 Broker 的链路注入可记录的延迟或丢包 | 心跳、请求超时与成员失联之间的关系,故障解除后的恢复速度 |
| 慢处理 | 只给一个成员增加处理延迟,并分别测试正常区间和接近 max.poll.interval.ms 的区间 |
是否因 poll 间隔过长被移出组,以及其他成员能否及时接管 |
扩缩容可以直接用 Kubernetes 做一轮可重复实验。下面假设基线副本数为 3,扩容到 6 后再恢复到 3;每一步都应与前面的采样脚本同时运行。
kubectl scale deployment/orders-consumer --replicas=6
kubectl rollout status deployment/orders-consumer --timeout=3m
kubectl scale deployment/orders-consumer --replicas=3
kubectl rollout status deployment/orders-consumer --timeout=3m
预期输出
deployment.apps/orders-consumer scaled
deployment "orders-consumer" successfully rolled out
deployment.apps/orders-consumer scaled
deployment "orders-consumer" successfully rolled out
网络抖动和突然终止应只在隔离测试环境或受控故障平台执行,并记录实际延迟、丢包率、持续时间与目标成员。不要同时给多个成员注入故障,否则无法判断恢复慢究竟来自协议、容量还是故障范围扩大。
计算停顿、Lag 峰值与恢复时间
设固定生产速率为 λ,故障期间有效消费速率为 μ,持续时间为 Δt。若 μ 低于 λ,积压的近似增长量可以写成:
实际验收不要只用这个近似式,而要从采样数据取真实峰值。恢复时间应定义清楚,例如“从故障注入开始,到总 Lag 回到基线 P95 加容忍值,并连续 3 个采样点满足条件”。同一团队必须使用同一个定义,否则不同实验没有可比性。
用实验结果决定治理动作
如果突然终止总要等很久才恢复,优先检查故障检测窗口与是否仍有足够剩余容量;如果慢处理频繁触发成员退出,重点检查处理批次、单条处理上界与 max.poll.interval.ms;如果扩缩容本身造成明显长停顿,则应回到发布批次、分区分配策略和成员变更节奏。
最终交付物不应只是“测试通过”,而是一组可重复的上界:允许的最大停顿、可接受的 Lag 峰值、要求的恢复时间,以及对应的基线生产速率和消费者规模。只有这些条件一起记录,下一次改配置或升级客户端时才能判断 Rebalance 是否真的变好了。