
消息队列 / 系统课时
处理同步与异步提交
处理同步与异步提交
commitSync() 与 commitAsync() 的差别不只是是否阻塞,还决定了失败何时暴露、退出前如何收口以及旧 Offset 能否被错误重试。本课用“运行期异步、关键边界同步”的模式兼顾吞吐与可控恢复。
学习目标
- 说明
commitSync()与commitAsync()在阻塞、错误处理和回调上的差异。 - 正确理解多个异步提交的顺序保证,不把网络异步误解为任意乱序写入。
- 设计不重试陈旧 Offset、并在关键边界使用同步提交收口的模式。
先区分阻塞与完成通知
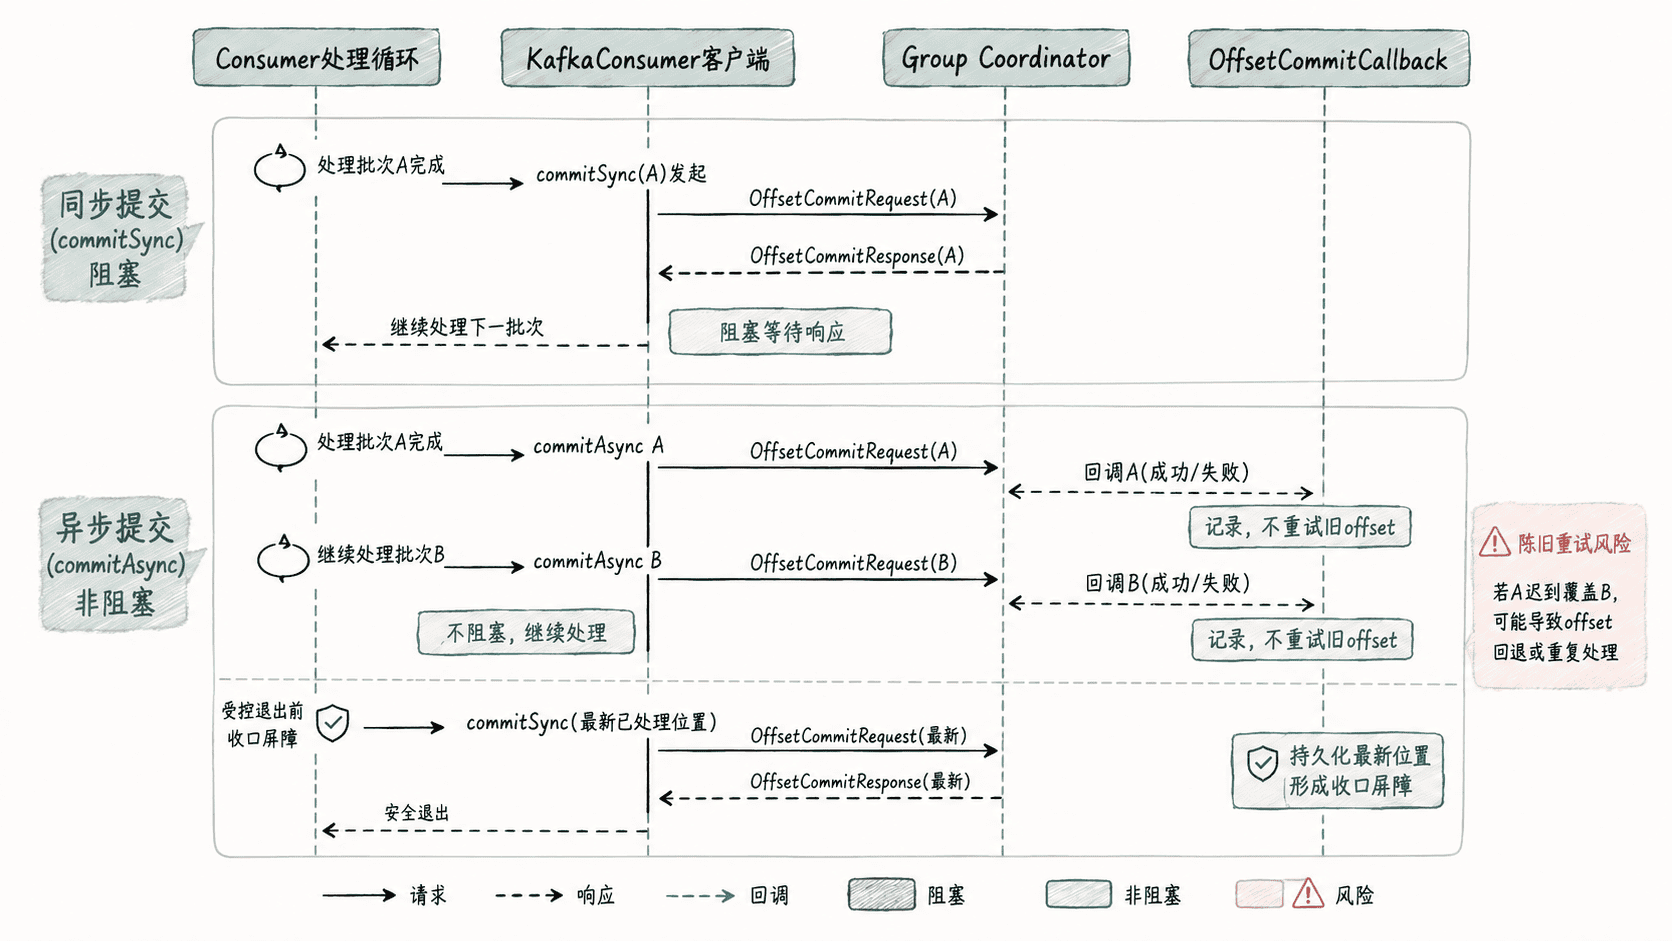
commitSync() 会等待提交成功、遇到不可恢复错误或超时,因此调用点能直接知道结果,适合关闭前、分区撤销前等必须确认进度的边界。代价是消费线程在提交期间不能继续处理下一批数据。
commitAsync() 立即返回,提交结果随后进入 OffsetCommitCallback。它适合正常消费循环,因为提交请求可以和后续处理重叠,但失败不能靠调用栈捕获,必须在回调中记录和治理。
Kafka 已保证异步调用顺序
同一个 KafkaConsumer 上连续调用 commitAsync() 时,客户端保证这些异步提交按调用顺序发送,对应回调也按同样顺序执行。因此,正常的 A→B 两次异步提交不会因为“B 网络响应更快”就自动把最终进度倒退成 A。
真正需要治理的是应用自己制造的陈旧重试。例如 A 的提交失败后,回调把 A 的旧 Offset 放进独立重试队列;此时主循环已经把更大的 B 提交成功,稍后重试 A 就可能再次显式提交更小的位置。安全做法是:异步失败只记录告警并让后续更新提交追上,或者重试前比较该分区当前待提交的最新位置,绝不无条件重放旧 Map。
运行期异步,退出前同步收口
下面示例关闭自动提交。每批消息全部处理成功后,把 ConsumerRecords.nextOffsets() 作为本批下一条待处理位置异步提交;失败回调只记录,不重试旧值。演示循环结束后,再对最近一次完整处理成功的 Offset Map 执行同步提交。
import java.time.Duration;
import java.util.HashMap;
import java.util.List;
import java.util.Map;
import java.util.Properties;
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.clients.consumer.OffsetAndMetadata;
import org.apache.kafka.common.TopicPartition;
import org.apache.kafka.common.serialization.StringDeserializer;

public class AsyncThenSyncCommit {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "<BOOTSTRAP_SERVERS>");
        props.put(ConsumerConfig.GROUP_ID_CONFIG, "async-commit-demo");
        props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, "false");
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());

        Map<TopicPartition, OffsetAndMetadata> latestProcessed = new HashMap<>();

        try (KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props)) {
            consumer.subscribe(List.of("<TOPIC>"));

            // 演示运行 5 个 poll 周期;生产代码可替换为自己的受控运行循环。
            for (int cycle = 0; cycle < 5; cycle++) {
                ConsumerRecords<String, String> records = consumer.poll(Duration.ofSeconds(1));
                for (ConsumerRecord<String, String> record : records) {
                    process(record);
                }

                if (!records.isEmpty()) {
                    latestProcessed.clear();
                    latestProcessed.putAll(records.nextOffsets());

                    Map<TopicPartition, OffsetAndMetadata> snapshot =
                            Map.copyOf(latestProcessed);
                    consumer.commitAsync(snapshot, (offsets, exception) -> {
                        if (exception != null) {
                            System.err.printf("async commit failed: %s%n", offsets.keySet());
                            return; // 不重试这份旧快照,让后续更新提交追上。
                        }
                        offsets.forEach((tp, offset) ->
                                System.out.printf("async commit ok: %s -> %d%n",
                                        tp, offset.offset()));
                    });
                }
            }

            if (!latestProcessed.isEmpty()) {
                consumer.commitSync(Map.copyOf(latestProcessed));
                System.out.println("final sync commit ok");
            }
        }
    }

    private static void process(ConsumerRecord<String, String> record) {
        System.out.printf("handled %s-%d@%d%n",
                record.topic(), record.partition(), record.offset());
    }
}
预期输出
handled <TOPIC>-<PARTITION>@<OFFSET>
async commit ok: <TOPIC>-<PARTITION> -> <NEXT_OFFSET>
final sync commit ok
实际分区与 Offset 会不同。若某次异步提交失败,会出现 async commit failed;示例不会立即重试旧快照,而是让下一次成功处理后的更大 Offset 覆盖进度,或者在演示循环结束时由最后一次同步提交确认最新完整处理位置。
失败处理要区分可继续与不可继续
同步提交失败时,不要把所有异常都写成无限重试。超时可以在仍持有分区且业务允许的前提下重新评估;如果已经发生 Rebalance,原分区可能不再属于当前 Consumer,此时旧 Offset 不能继续按原假设提交,应先完成重新分配并基于新 assignment 决定下一步。
异步提交失败时,核心目标通常是“避免丢失,允许有限重放”。只记录失败并让后续提交追上,会增加崩溃时的重放窗口,但不会把处理完成点向前伪造。若业务要求每次提交都必须确认,就应该降低异步程度,直接选择同步提交或缩小批次。
在 Rebalance 与关闭边界做同步确认
“异步常态、同步收口”最适合提交频繁且允许至少一次处理的消费程序。正常循环用 commitAsync() 减少阻塞;收到受控关闭信号时,对最后完整处理成功的 Offset 做 commitSync(),可以把此前异步提交收敛到明确位置。
如果应用使用 subscribe() 参与消费组自动分配,还应把“分区撤销前提交最后完成进度”放入 Rebalance 处理逻辑,而不是等分区已经失去所有权后再盲目提交。无论同步还是异步,提交 Map 都必须来自当前仍拥有的分区,并且值始终是每个分区下一条尚未处理的 Offset。
最终选择并不复杂:需要调用点确认结果时用同步提交;正常高频循环可用异步提交;异步失败不要重试陈旧快照;关闭和分区所有权变化等关键边界再用同步提交确认最新已完成位置。