
消息队列 / 系统课时
建立消费者稳定性指标集
建立消费者稳定性指标集
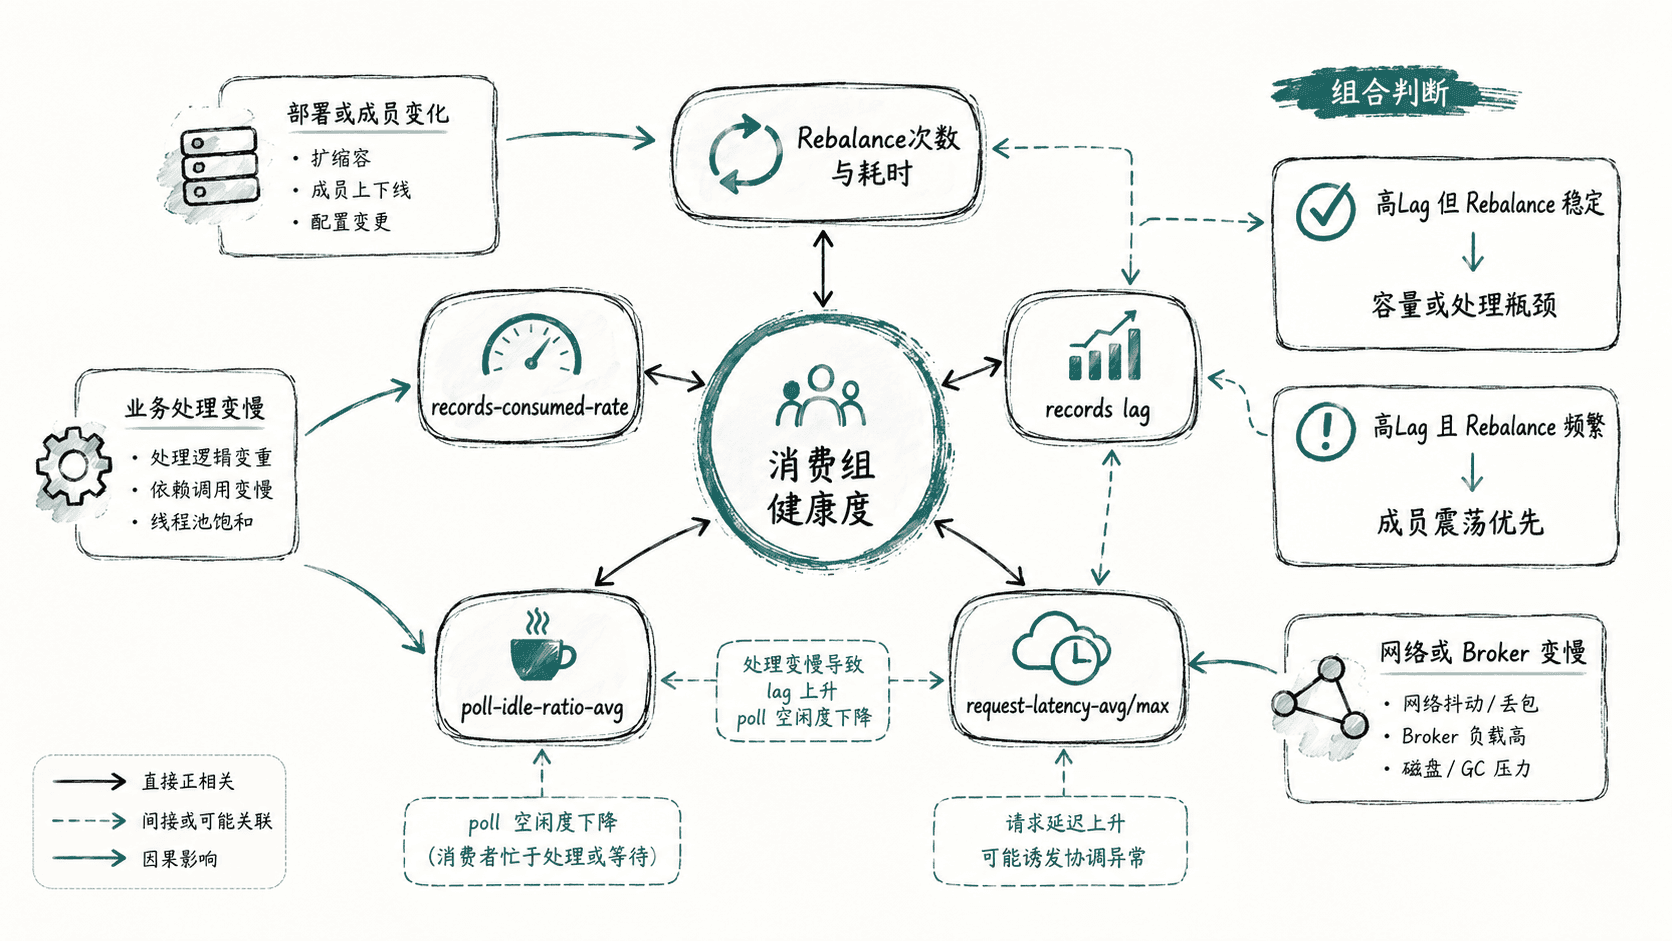
消费组是否“稳定”不能只看 Lag。一个可用的监控面板要同时回答:有没有频繁 Rebalance、消费能力是否跟得上、消费者是否长时间不调用 poll()、请求链路是否变慢,以及积压是在增长还是回落。
学习目标
- 能把 Rebalance、吞吐、积压、Poll 活跃度和请求延迟组合成一组稳定性指标
- 能区分“高 Lag 但稳定消费”和“成员震荡导致的高 Lag”
- 能用组级与实例级视角组织面板,并为告警设置组合条件
把健康度拆成五类信号
消费者稳定性至少要同时观察五类信号,而不是挑一个指标做总判定。
| 信号 | 代表指标 | 主要回答的问题 |
|---|---|---|
| 组协调 | rebalance-total、rebalance-rate-per-hour、rebalance-latency-avg/max |
是否在频繁重新分配,单次重平衡是否越来越慢 |
| 消费能力 | records-consumed-rate |
实际处理速度是否下降 |
| 积压 | records-lag-max、各分区 Lag 总和 |
生产速度是否长期高于消费能力 |
| Poll 活跃度 | poll-idle-ratio-avg |
应用是否把大量时间耗在两次 poll() 之间的业务处理上 |
| 请求链路 | request-latency-avg/max |
客户端到 Broker 的请求是否出现网络或 Broker 侧变慢 |
这些指标通常来自 Kafka Consumer JMX。导出到 Prometheus 后,名称会受 exporter 规则影响,因此面板应先确认“JMX 原始指标 → 监控系统指标名”的映射,不要直接照抄别人的 PromQL。
还要注意指标的聚合语义。Rebalance 相关 JMX 指标是消费者实例视角,同一次组级 Rebalance 可能被多个成员分别记录,因此不能把所有实例的 rebalance-total 直接相加当作组级次数;组级计数应优先来自协调器或组事件,客户端计数用于观察单实例变化。吞吐率可以按实例求和,请求延迟和最大 Lag 更适合看最大值或分位数。
poll-idle-ratio-avg 要结合 Lag 解读:它持续偏低且 Lag 上升,往往说明消费者大部分时间都在处理上一批记录,下一次 poll() 来得太晚;如果它较高而 Lag 仍上升,则应继续检查分区分配、生产突增、拉取限制或 Broker 请求延迟。
先验证组级 Lag
JMX 适合持续监控,排障时还应使用 Kafka 自带工具做一次组级快照,确认提交位点和日志末端的差值是否真的在扩大。
kafka-consumer-groups.sh \
  --bootstrap-server <HOST>:<PORT> \
  --describe \
  --group <GROUP>
预期输出
GROUP    TOPIC   PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG      CONSUMER-ID  HOST   CLIENT-ID
<GROUP>  orders  0          <VALUE>         <VALUE>         <VALUE>  <ID>         /<IP>  <ID>
实际 Offset、Lag、成员 ID 和主机地址会随现场变化。重点是连续采样:如果 LOG-END-OFFSET - CURRENT-OFFSET 持续扩大,说明积压仍在增长;如果 Lag 回落而 Rebalance 计数平稳,消费组通常只是经历了短暂流量高峰。
面板按“组”和“实例”分层
组级面板关注服务是否还能按目标速率消费:总 Lag、最大分区 Lag、组内成员数、Rebalance 频率与时长。实例级面板关注哪个消费者在拖慢整个组:records-consumed-rate、poll-idle-ratio-avg、请求延迟、CPU、GC 和业务处理耗时。
不要把所有实例的 records-lag-max 直接相加,因为它本身就是“最大值”语义。总积压应按 Topic-Partition 计算提交 Offset 与 Log End Offset 的差值后求和;最大 Lag 则保留最大值,用来发现热点分区。
告警使用组合条件
单一阈值很容易误报。更有价值的规则是“持续时间 + 两类以上信号”组合判断,例如:Lag 连续增长且消费速率下降;Rebalance 频率突然升高且成员数反复变化;请求延迟升高同时出现心跳或提交异常。
面板最终要形成一条可读的诊断链:先看 Rebalance 是否异常,再看消费速率与 Lag 是否同步恶化,最后下钻 Poll 活跃度和请求延迟。这样才能把“容量不足”“应用处理过慢”和“成员震荡”分开处理。