
消息队列 / 系统课时
读懂 Group Coordinator 与组状态
读懂 Group Coordinator 与组状态
Group Coordinator 是消费组的协调入口:它接收成员加入、心跳与离开请求,推动分区分配,并维护消费组从建组到稳定运行的状态。读懂这些状态后,你才能把“正在 Rebalance”与真正的故障区分开。
学习目标
- 说明 Group Coordinator 在成员管理和分配协同中的职责
- 识别消费组加入、分配、稳定和成员离开时的关键状态
- 使用 Kafka 命令查看组状态并判断是否处于异常震荡
Coordinator 到底协调什么
消费者并不是彼此直接协商分区。每个消费组会由某个 Broker 上的 Group Coordinator 负责协调。成员通过协调器完成加入组、同步分配结果、维持心跳以及提交 Offset 等操作。
协调器不负责消费业务消息,也不替消费者执行分区读取。它管理的是“谁属于这个组、当前这一代成员是谁、分区分配何时生效”这些控制面信息。
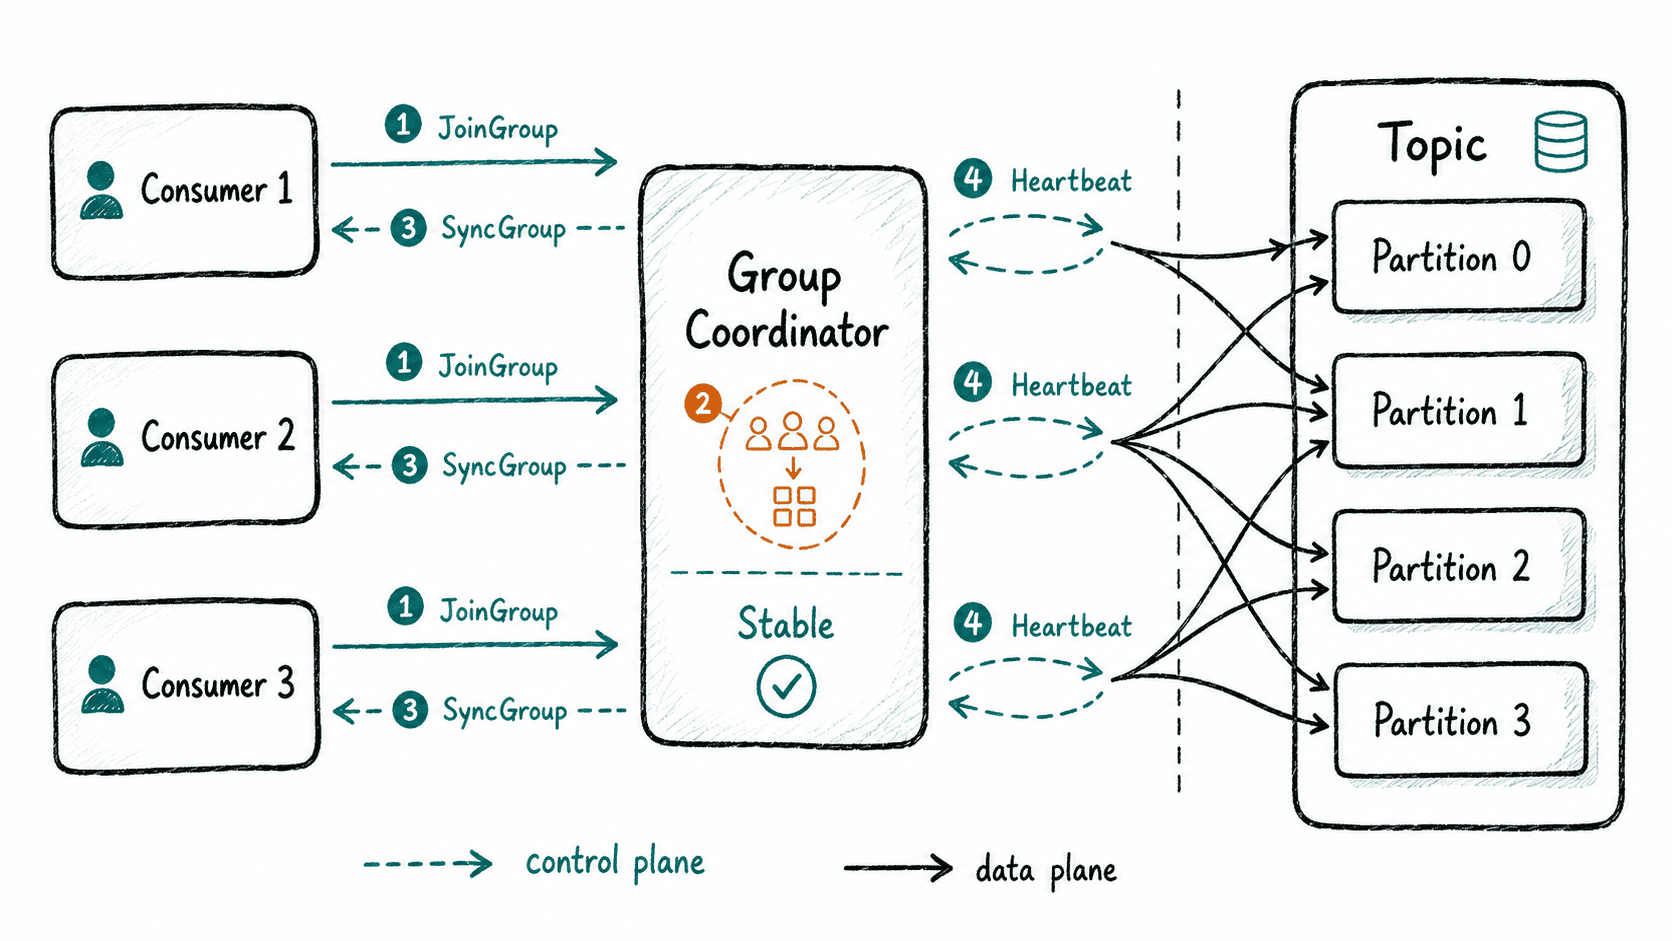
从加入到 Stable 的状态变化
经典消费组协议下,一个组通常会经历 Empty、PreparingRebalance、CompletingRebalance、Stable 等状态。成员变化或订阅元数据变化会触发新的协调过程。
关键判断不是“看到 Rebalance 就算故障”,而是观察组能否很快回到 Stable。如果状态长期停留在 PreparingRebalance,或在几个状态间高频往返,才需要继续检查成员掉线、超时、部署抖动或网络问题。
用命令查看组状态
下面的命令查看消费组成员、分配与 Lag。将 <BOOTSTRAP_SERVERS> 和 <GROUP_ID> 替换为实际值。
kafka-consumer-groups.sh --bootstrap-server <BOOTSTRAP_SERVERS> --group <GROUP_ID> --describe预期输出:
GROUP      TOPIC      PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG  CONSUMER-ID
<GROUP_ID> orders     0          12040           12045           5    <ID>
<GROUP_ID> orders     1          11820           11820           0    <ID>
这类输出说明分区已经有当前持有者,通常意味着组处于可工作的稳定阶段。实际 Offset、Lag、成员 ID 会随运行变化。
如果需要观察状态是否反复变化,可以连续执行:
watch -n 2 'kafka-consumer-groups.sh --bootstrap-server <BOOTSTRAP_SERVERS> --group <GROUP_ID> --describe --state'预期输出:
GROUP      COORDINATOR        ASSIGNMENT-STRATEGY  STATE   #MEMBERS
<GROUP_ID> <IP>:<PORT>        <VALUE>              Stable  3
实际协调器地址、分配策略和成员数可能不同。
状态异常时怎么判断
短暂进入 Rebalance 状态通常是扩缩容、发布、成员加入退出或 Topic 分区变化的正常结果。真正值得报警的是持续时间与频率:例如一分钟内多次失稳、长时间无法回到 Stable,或者成员数不断上下跳动。
排查时先建立时间线:组状态变化发生在何时,是否与发布、GC、网络抖动或 Broker 异常重合。这样才能把“协调器正在工作”与“协调器反复被迫重新工作”区分开。