
消息队列 / 系统课时
设计消费者优雅退出
设计消费者优雅退出
消费者被发布、缩容或主机停机终止时,真正要保护的是“已经处理到哪里”。优雅退出把停止拉取、完成当前批次、提交已完成位点和关闭 Consumer 串成可控顺序,避免进程突然消失后产生额外重复处理或错误跳过。
学习目标
- 设计不会继续接收新工作的退出顺序。
- 在提交位点前明确哪些消息已经真正处理完成。
- 让应用的退出时间预算与部署平台的终止宽限期一致。
先定义优雅退出的边界
对于手动提交、至少一次处理语义的普通消费者,安全顺序是:收到停止信号后不再启动新的业务批次,完成已经拉取并开始处理的记录,只提交确实完成的 offset,最后再关闭 Consumer。顺序一旦反过来,就可能把“尚未完成”误标成“已完成”,或者让已完成记录在重启后再次执行。
如果业务把消息交给异步线程池处理,“拉取完成”不等于“处理完成”。此时必须按分区跟踪连续完成的 offset,不能简单提交最后一次 poll() 返回的位置。单线程同步处理更容易先把退出语义做对,下面的主示例就采用这个模型。
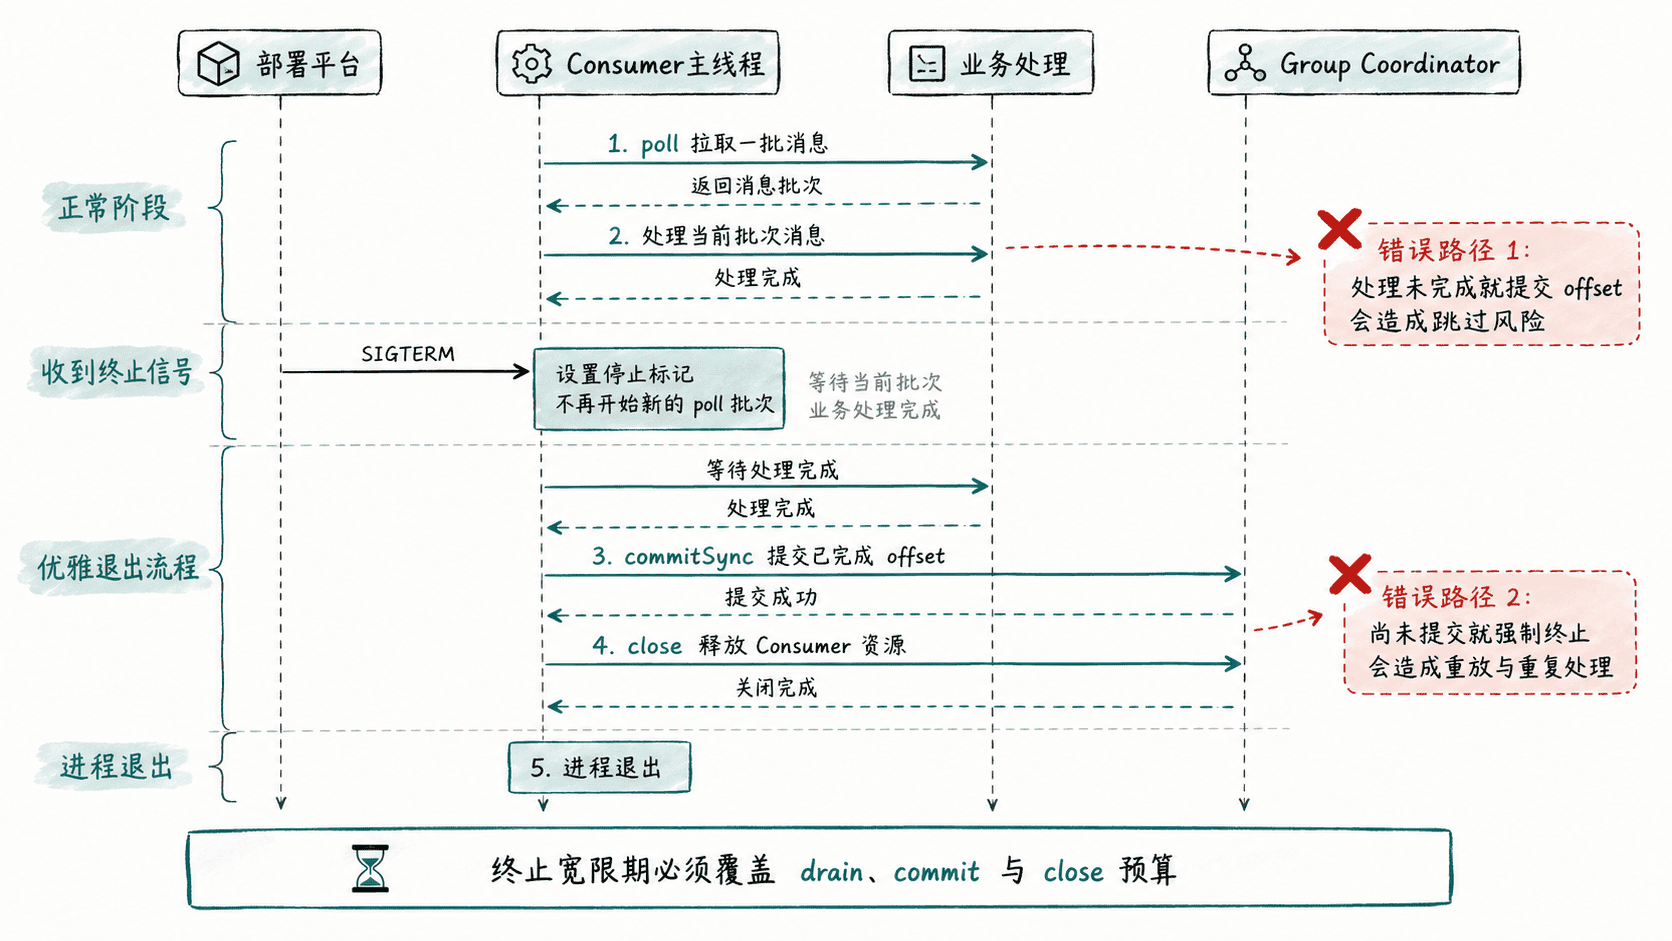
用单线程主循环实现顺序退出
下面示例让关闭钩子只修改线程安全的停止标记,并等待消费线程自己完成收尾。KafkaConsumer 仍只由主线程访问,避免跨线程调用 Consumer;较短的 poll() 超时保证停止信号到来后能及时退出循环。
import java.time.Duration;
import java.util.List;
import java.util.Properties;
import java.util.concurrent.CountDownLatch;
import java.util.concurrent.TimeUnit;
import java.util.concurrent.atomic.AtomicBoolean;

import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.common.serialization.StringDeserializer;

public class GracefulConsumer {
    private static final AtomicBoolean running = new AtomicBoolean(true);
    private static final CountDownLatch stopped = new CountDownLatch(1);

    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        props.put(ConsumerConfig.GROUP_ID_CONFIG, "orders-graceful");
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, "false");
        props.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, "100");
        props.put(ConsumerConfig.DEFAULT_API_TIMEOUT_MS_CONFIG, "10000");

        KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props);

        Runtime.getRuntime().addShutdownHook(new Thread(() -> {
            System.out.println("shutdown requested; draining current batch");
            running.set(false);
            try {
                if (!stopped.await(30, TimeUnit.SECONDS)) {
                    System.err.println("graceful shutdown window expired");
                }
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        }, "shutdown-hook"));

        try {
            consumer.subscribe(List.of("orders"));

            while (running.get()) {
                ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(500));
                if (records.isEmpty()) {
                    continue;
                }

                for (ConsumerRecord<String, String> record : records) {
                    process(record);
                }

                // 只有整个批次都处理成功后,才提交这一批的消费进度。
                consumer.commitSync();
                System.out.printf("committed batch size=%d%n", records.count());
            }
        } finally {
            try {
                consumer.close(Duration.ofSeconds(5));
                System.out.println("consumer closed");
            } finally {
                stopped.countDown();
            }
        }
    }

    private static void process(ConsumerRecord<String, String> record) {
        System.out.printf("processed partition=%d offset=%d%n",
                record.partition(), record.offset());
    }
}
预期输出
processed partition=<ID> offset=<ID>
committed batch size=<VALUE>
shutdown requested; draining current batch
consumer closed
实际分区、offset 和批次数量会变化。发送 SIGTERM 时,如果主线程正在处理一批记录,它会先处理完并提交,再结束循环;如果正在等待 poll(),最多等待本例的 500 ms 轮询超时后进入收尾。示例故意没有从关闭钩子调用 consumer.close(),因为 KafkaConsumer 除少数专门设计的中断方法外并不是线程安全对象。
与部署平台对齐时间预算
应用能优雅退出的前提是平台给出的终止宽限期足够长。可以把预算近似看成 。如果单批业务处理最坏需要 20 秒、提交最多 10 秒、关闭预算 5 秒,就不应把容器终止宽限期只设成 10 秒。
max.poll.records 是控制 drain 上界的实用手段:单条处理时间较长时,减小每批记录数比单纯放大 max.poll.interval.ms 更容易得到可预测的退出时间。对于异步处理模型,还要额外计算线程池在途任务和按分区连续提交点的等待时间。
避免把提交和关闭顺序做反
业务处理失败时不要为了“退出干净”而提交这条消息,否则重启后可能直接越过失败记录。相反,如果业务副作用已经完成但进程在提交前被强制终止,重启后可能再次收到同一条消息,这是至少一次语义下必须接受并通过幂等性治理的重复。
如果消费者使用静态成员身份,短暂重启和永久缩容还要分开处理:短暂退出希望保留稳定身份,永久删除副本则可能需要显式移除静态成员,才能避免等待成员失效超时。最终验收不应只看“进程退出码为 0”,而要看停止期间是否继续接收新工作、最后一次提交是否对应已完成处理、重启后第一条消息是否从预期位置继续。