
消息队列 / 系统课时
调整 Poll 与 Fetch 批次
调整 Poll 与 Fetch 批次
Kafka 消费吞吐不仅由 poll() 一次返回多少条记录决定,还受 Broker 每次 Fetch 返回多少数据、等待多久以及单分区读取上限影响。本篇把这些参数放到同一条数据链路里调,目标是在吞吐、单批处理时长和客户端内存之间取得可验证的平衡。
学习目标
- 区分
max.poll.records与 Fetch 类参数各自控制的层级 - 从业务处理能力反推 Poll 批次,而不是只追求更大吞吐
- 通过消费速率、批次耗时和内存数据判断参数是否需要继续调整
先分清两层批次
max.poll.records 只限制一次 poll() 最多交给应用多少条已经拉到客户端的记录,它不会直接限制 Broker 底层 Fetch 一次读取多少字节。消费者可能已经预取并缓存了更多数据,再分多次 Poll 交给业务代码。
Fetch 侧常见的几个参数作用不同:
fetch.min.bytes:Broker 希望至少积累到多少数据再返回 Fetch 响应;数据不足时最多等待fetch.max.wait.ms。fetch.max.wait.ms:在达不到fetch.min.bytes时允许 Broker 等待的最长时间。max.partition.fetch.bytes:一次 Fetch 对单个分区返回数据的目标上限。fetch.max.bytes:一次 Fetch 响应整体的目标上限。
Kafka 为保证消费者能继续前进,对“第一批记录本身就大于这些字节限制”的场景有特殊处理,因此这些字节值不能当作绝对的单条消息硬上限。
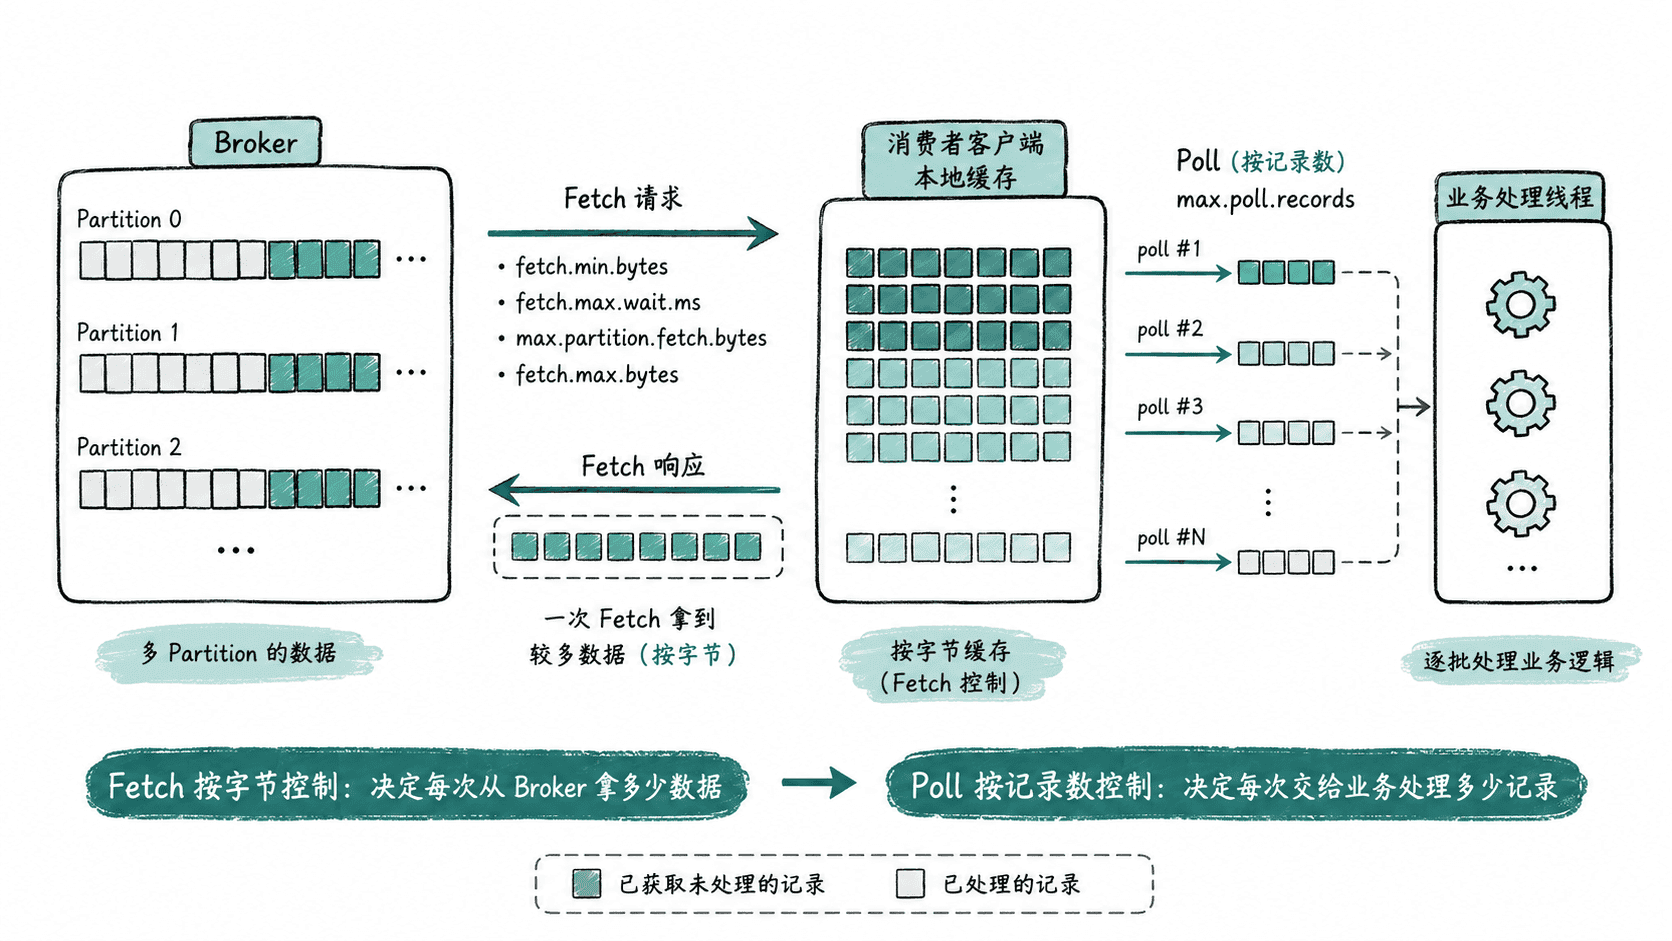
从处理能力反推 max.poll.records
先确定应用希望一批在多长时间内处理完,再结合单条记录的高分位处理耗时估算批次上限。若单条平均很快但偶发 RPC 很慢,应按高分位和外部依赖超时计算,而不是只看平均值。
例如服务希望单批业务处理控制在约 5 秒以内,单条记录高分位耗时约 20 ms,则理论上 250 条已经接近预算上限;还要给提交、调度和抖动留空间,因此可以从 200 条附近开始压测,而不是直接把 max.poll.records 调到很大。
下面是一组用于压测的起始配置,而不是通用推荐值:
max.poll.records=200
fetch.min.bytes=65536
fetch.max.wait.ms=250
max.partition.fetch.bytes=1048576
fetch.max.bytes=8388608生效后,poll() 每次最多向应用交付 200 条记录;Broker 会尝试在达到约 64 KiB 数据后返回 Fetch,若数据不足则最多等待约 250 ms。单分区和整体 Fetch 字节限制共同约束客户端一次预取的数据规模。
调吞吐时同时看延迟和内存
提高 fetch.min.bytes 往往能减少小 Fetch、提升批量效率,但低流量主题会因此增加等待时间。增大 fetch.max.bytes 或 max.partition.fetch.bytes 可以提高大批读取能力,却可能放大客户端缓存、反序列化对象和瞬时内存占用。
max.poll.records 则更直接影响业务线程的一次工作量。它过大时,即使 Fetch 很高效,也可能让单批处理时间逼近 max.poll.interval.ms;它过小时,业务代码频繁进入 Poll 与提交路径,吞吐又可能下降。
用同一组指标做验收
每次只改一组参数,并在相同流量下比较至少三类数据:消费吞吐、单批处理 P95/P99、消费者进程内存。若使用 JMX,还可以结合 fetch-size-avg、records-per-request-avg、records-consumed-rate 和 records-lag-max 判断是 Fetch 太碎、处理能力不足还是已经出现积压。
当吞吐提升但批次耗时和内存同时明显上升时,不应继续扩大 Fetch 或 Poll 批次。稳定配置应让处理耗时远低于 Poll 超时预算,内存有可控余量,并且在目标并发下 records-lag-max 不持续增长。